
浅谈 KMP 算法
最近在复习数据结构,学到了 KMP 算法这一章,似乎又迷糊了,记得第一次学习这个算法时,老师在课堂上讲得唾沫横飞,十分有激情,而我们在下面听得一脸懵比,啥?这是个啥算法?啥玩意?再去看看书,完全听不懂呀?总之,觉得十分懵比,课后去看了一些视频和博客,才慢慢有一点理解,学习不是一蹴而就的,需要脚踏实地的努力。过了三年,重新温习这个算法,似乎依旧不是很明白,理解得不够透彻,重新拾起课本和视频,认真学习这个算法。
1.KMP 算法简介
KMP 算法是由三位老前辈(D.E.Knuth,J.H.Morris 和 V.R.Pratt )的研究结果,该算法巧妙之处在于避免重复遍历的情况,全称叫做克努特-莫里斯-普拉特算法,简称 KMP 算法,D.E.Knuth,编写了《计算机程序设计艺术》写完了第四卷,这部著作被誉为计算机领域中的“相对论”。
2.子串 next 数组的计算
KMP 算法关键点是先求出 next[] 数组,这个 next 数组只与模式匹配串有关,例如以 "abababca" 这个子串计算一下它的 next 数组
下标为 index = 0 开始 ,
index = 0 ,"a" 的前缀和后缀都为空集,value = 0;
index = 1,"ab" 的前缀和后缀分别为 "a" 和 "b",不相等,value = 0;
index = 2, "aba" 的前缀是 "a"、 "ab",后缀是 "ba"、"a",有相同交集 "a",长度为 1, value = 1;
index = 3, "abab" 的前缀是 "a"、"ab"、"aba",后缀是 "bab"、"ab"、"b",有最长相同交集 "ab", 长度为 2,value = 2;
index = 4,"ababa" 的前缀是 "a"、"ab"、"aba"、"abab",后缀是 "baba"、"aba"、"ba"、"a",有最大相同交集 "aba",长度为 3, value = 3;
index = 5,"ababab" 的前缀是 "a"、"ab"、"aba"、"abab"、"ababa",后缀是 "babab"、"abab"、"bab"、"ab"、"b",有最长相同交集 "abab",长度为 4, value = 4;
index = 6,"abababc" 的前缀是 "a"、"ab"、"aba"、"abab"、"ababa"、"ababab",后缀是 "bababc"、"ababc"、"babc"、"abc"、"bc"、"c",没有相同交集,value = 0;
index = 7,"abababca" 的前缀是 "a"、"ab"、"aba"、"abab"、"ababa"、"abababc",后缀是 "bababca"、"ababca"、"babca"、"abca"、"bca"、"ca"、"a",有相同交集 "a",长度为1,value = 1;
最后结果如下:
char: | a | b | a | b | a | b | c | a |
index: | 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 |
value: | 0 | 0 | 1 | 2 | 3 | 4 | 0 | 1 |
3、如何使用 next[] 数组
得到子串的 next 数组以后,在目标串中匹配使用 next 数组,通过使用 next 数组避免重复的匹配已经匹配过的元素,如果找到长度为 partial_match_length 的部分匹配,并且表 next [partial_match_length]> 1,我们可以提前跳过 partial_match_length - next[partial_match_length-1] 个字符
总结移动位数 = 已匹配的字符数 - 对应的部分匹配值
char: | a | b | a | b | a | b | c | a |
index: | 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 |
value: | 0 | 0 | 1 | 2 | 3 | 4 | 0 | 1 |
以 "bacbababaabcbab" 为例说明它的匹配过程,第一次匹配, 调到 index = 1 位置,如下
bacbababaabcbab
|
abababca
不难看出, 部分匹配的长度为 partial_match_length = 1, 但是在 next [ partial_match_length - 1] = 0,也就是 next[0] = 0,这个元素,所以我们不需要跳过任何元素,接下来 cb 和 a 都不匹配直接向右匹配,到了下一个 a 匹配的地方
bacbababaabcbab
| | | | |
abababca
来到这个地方,你会发现此时部分匹配的长度为 5 , partial_match_length = 5, next[partial_match_length - 1] = next[4],查 next 数组,next[4] = 3,这就意味着在接下来的匹配中我们要跳过 partial_match_length - next[partial_match_length-1] ,即 5 - next[4] = 5 - 3 = 2,要跳过 2 个字符,所以接下来的匹配应该变成了如下所示:
bacbababaabcbab
xx | | |
abababca
xx 表示跳过了,部分匹配长度为 3, partial_match_length = 3,next[partial_match_length - 1] = next[2] = 1,接下来匹配中要跳过
partial_match_length - next[partial_match_length - 1], 即 3 - 1 = 2, 跳过 2 个字符后的匹配情况如下:
bacbababaabcbab
xx |
abababca
得到部分匹配长度为 1 , partial_match_length = 1, next[partial_match_length - 1] = 0,接下来匹配不用跳过字符,向右匹配,匹配串比剩余的主串要长,所以没有找到匹配的字符串。
4、KMP 算法代码实现,使用 C 语言实现
#include <stdio.h>

#include <stdlib.h>

#include <string.h>

void get_next(char T[],int next[])//next数组

{

    int i,j;

    i=;//前

    j=;//后

    next[]=;

    while(j<T[]) {

        if(i== || T[i]==T[j])

        {

            i++;

            j++;

            next[j]=i;

            /*if(T[i]!=T[j])

            {

                next[j]=i;

            }

            else

            {

                next[j]=next[i];

            }*/

        }

        else

        {

            i=next[i];

        }

    }

}

int Index_KMP(char S[],char T[])

{

    int next[];

    int i=;

    int j=;

    get_next(T,next);//获得next数组

    /*

    for(i=1;i<=T[0];i++)

    {

            printf("%d ",next[i]);

    }

    */

    while(i<=S[] && j<=T[])

    {

        if(j==||S[i]==T[j])

        {

           i++;

           j++;

        }

        else

        {

            j=next[j];

        }

    }

    if(j>T[])

        return i-T[];

    return ;

}

int main (){

    char T[],S[];

    int i,k;

    while(scanf("%s %s",S,T)!=EOF)

    {

        k=strlen(T);

        for(i=strlen(T);i>;i--)//向后移动

        {

            T[i]=T[i-];

        }

        T[]=k;

        k=strlen(S);

        for(i=strlen(S);i>;i--)//向后移动

        {

            S[i]=S[i-];

        }

        S[]=k;

        printf("%d\n",Index_KMP(S,T));

    }

    return ;

}
运行结果如下:
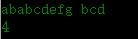
4 为第一个出现匹配字符串的数字下标从 1 开始
5、个人总结
经过这次对于 KMP 算法的练习,使我重新练习了一遍,关于 KMP 中算法实现的某些步骤依旧不是很清楚,有些地方想得还不是特别明白,也许这就是差距。今天出现了一些代码的 Bug,为了解决 Bug 查了一些网站的资料,重新温习了 C语言的使用,今天过得很充实。
更多有趣、好玩、实用的内容,请关注我的微信公众号:
参考资料:
http://jakeboxer.com/blog/2009/12/13/the-knuth-morris-pratt-algorithm-in-my-own-words/
http://www.ruanyifeng.com/blog/2013/05/Knuth%E2%80%93Morris%E2%80%93Pratt_algorithm.html
https://liam.page/2016/12/20/KMP-Algorithm/
https://blog.dotcpp.com/a/8986
浅谈 KMP 算法的更多相关文章
- 浅谈KMP算法及其next[]数组
KMP算法是众多优秀的模式串匹配算法中较早诞生的一个,也是相对最为人所知的一个. 算法实现简单,运行效率高,时间复杂度为O(n+m)(n和m分别为目标串和模式串的长度) 当字符串长度和字符集大小的比值 ...
- 单模式串匹配----浅谈kmp算法
模式串匹配,顾名思义,就是看一个串是否在另一个串中出现,出现了几次,在哪个位置出现: p.s. 模式串是前者,并且,我们称后一个 (也就是被匹配的串)为文本串: 在这篇博客的代码里,s1均为文本串, ...
- 浅谈KMP算法
一.介绍 烤馍片KMP算法是用来处理字符串匹配问题的.比如说给你两个字符串A,B,问B是不是A的子串? 比如,eg就是aeggx的子串 一般讲字符串A称为主串,用来匹配的B串称为模式串 定义n为字符串 ...
- 【字符串算法3】浅谈KMP算法
[字符串算法1] 字符串Hash(优雅的暴力) [字符串算法2]Manacher算法 [字符串算法3]KMP算法 这里将讲述 [字符串算法3]KMP算法 Part1 理解KMP的精髓和思想 其实KM ...
- 【文文殿下】浅谈KMP算法next数组与循环节的关系
KMP算法 KMP算法是一种字符串匹配算法,他可以在O(n+m)的时间内求出一个模式串在另一个模式串下出现的次数. KMP算法是利用next数组进行自匹配,然后来进行匹配的. Next数组 Next数 ...
- 浅谈KMP算法——Chemist
很久以前就学过KMP,不过一直没有深入理解只是背代码,今天总结一下KMP算法来加深印象. 一.KMP算法介绍 KMP解决的问题:给你两个字符串A和B(|A|=n,|B|=m,n>m),询问一个字 ...
- 浅谈分词算法(5)基于字的分词方法(bi-LSTM)
目录 前言 目录 循环神经网络 基于LSTM的分词 Embedding 数据预处理 模型 如何添加用户词典 前言 很早便规划的浅谈分词算法,总共分为了五个部分,想聊聊自己在各种场景中使用到的分词方法做 ...
- 浅谈分词算法(4)基于字的分词方法(CRF)
目录 前言 目录 条件随机场(conditional random field CRF) 核心点 线性链条件随机场 简化形式 CRF分词 CRF VS HMM 代码实现 训练代码 实验结果 参考文献 ...
- 浅谈分词算法(3)基于字的分词方法(HMM)
目录 前言 目录 隐马尔可夫模型(Hidden Markov Model,HMM) HMM分词 两个假设 Viterbi算法 代码实现 实现效果 完整代码 参考文献 前言 在浅谈分词算法(1)分词中的 ...
随机推荐
- 02-13 Softmax回归
目录 Softmax回归 一.Softmax回归详解 1.1 让步比 1.2 不同类之间的概率分布 1.3 目标函数 1.4 目标函数最大化 二.Softmax回归优缺点 2.1 优点 2.2 缺点 ...
- Kubernetes+Docker+Istio 容器云实践
随着社会的进步与技术的发展,人们对资源的高效利用有了更为迫切的需求.近年来,互联网.移动互联网的高速发展与成熟,大应用的微服务化也引起了企业的热情关注,而基于Kubernetes+Docker的容器云 ...
- BZOJ 2535: [Noi2010]Plane 航空管制2
Description 世博期间,上海的航空客运量大大超过了平时,随之而来的航空管制也频频发生.最近,小X就因为航空管制,连续两次在机场被延误超过了两小时.对此,小X表示很不满意. 在这次来烟台的路上 ...
- 复杂模型可解释性方法——LIME
一.模型可解释性 近年来,机器学习(深度学习)取得了一系列骄人战绩,但是其模型的深度和复杂度远远超出了人类理解的范畴,或者称之为黑盒(机器是否同样不能理解?),当一个机器学习模型泛化性能很好时 ...
- Maven插件构建Docker镜像
背景 微服务架构下,微服务在带来良好的设计和架构理念的同时,也带来了运维上的额外复杂性,尤其是在服务部署和服务监控上.单体应用是集中式的,就一个单体跑在一起,部署和管理的时候非常简单,而微服务是一个网 ...
- JVM垃圾回收(下)
接着上一篇,介绍完了 JVM 中识别需要回收的垃圾对象之后,这一篇我们来说说 JVM 是如何进行垃圾回收. 首先要在这里介绍一下80/20 法则: 约仅有20%的变因操纵着80%的局面.也就是说:所有 ...
- Hydra爆破神器使用
参数详解: -R 根据上一次进度继续破解-S 使用SSL协议连接-s 指定端口-l 指定用户名-L 指定用户名字典(文件)-p 指定密码破解-P 指定密码字典(文件)-e 空密码探测和指定用户密码探测 ...
- cobalt strike笔记-常用beacon扫盲
最近还是重新补一下cs的东西 0x01 Beacon命令 Beacon Commands =============== Command Description ------- ----------- ...
- [NOIp2014] luogu P2296 寻找道路
不知道是因为我菜还是别的,最近老是看错题. 题目描述 在有向图 GGG 中,每条边的长度均为 1,现给定起点和终点,请你在图中找一条从起点到终点的路径,该路径满足以下条件: 路径上的所有点的出边所指向 ...
- go-defer语句
Go语言中的defer语句也非常独特. defer语句仅能被放置在函数或方法中. 它由关键字defer和一个调用表达式组成. 调用表达式所表示的既不能是对Go语言内建函数的调用 也不能是对Go语言标准 ...