
python-2:爬取某个网页(虎扑)帖子的标题做词云图
关键词:requests,BeautifulSoup,jieba,wordcloud
整体思路:通过requests请求获得html,然后BeautifulSoup解析html获得一些关键数据,之后通过jieba分词对数据进行切分,去停,最后通过wordcloud画词云图
1、请求虎扑Acg区
Acg区首页的url为:https://bbs.hupu.com/acg
Acg区第二页的url为:https://bbs.hupu.com/acg-2
从这里可以得知,如果我们要请求多个网页,只需要以首页作为基础url,后面的每一页在首页的url基础上进行添加即可。引入requests库进行请求
base_url = r'https://bbs.hupu.com/acg'

add_url = ''

content_str = ''

# 尝试请求15个网页

for i in range(1, 15):

    if i != 1:

        add_url = r'-{}'.format(i)

    else:

        add_url = ''

    url = base_url + add_url

    response = requests.get(url)
2、BeautifulSoup解析
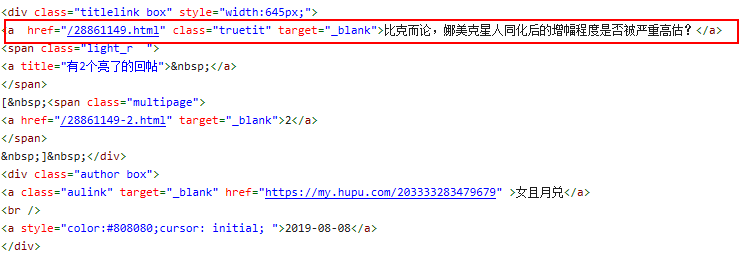
打开浏览器的控制台,观察网页源码,寻找需要获得的数据的标签。我们需要获取一个帖子的标题,通过浏览网页源码可以发现帖子的标题在一个<a></a>标签中,且class=“truetit”,通过这两个信息我们就可以通过BeautifulSoup获取一个帖子的标题了。
base_url = r'https://bbs.hupu.com/acg'

add_url = ''

content_str = ''

for i in range(1, 15):

    if i != 1:

        add_url = r'-{}'.format(i)

    else:

        add_url = ''

    url = base_url + add_url

    response = requests.get(url)

    # 引入BeautifulSoup

    soup = BeautifulSoup(response.text, "lxml")

    # 找<a></a>标签,class = ‘truetit’

    all_title = soup.find_all("a", class_="truetit")

    for title in all_title:

        content_str += title.text
需要注意的是,
all_title = soup.find_all("a", class_="truetit")
会把当前网页的所有标题都读出来,且格式是一个以<a></a>标签为元素的list,通过for遍历这个list,对每一个<a></a>,调用title.text即可以获得帖子的标题。
print一下,查看是不是获得了想要的结果:
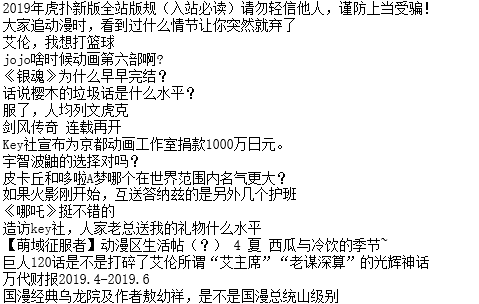
可以看到我们已经获得了我们想要的标题,下一步就是数据处理了(jieba分词+去停)
3、jieba分词+去停用词
先写一个生成停用词表的函数
# 引入停用词表

def stopwordslist(filepath):

    stopwords = [line.strip() for line in open(filepath, 'r', encoding='utf-8').readlines()]

    return stopwords
再进行jieba分词,去停使用的是哈工大停用词表
# 用lcut使得分词后为一个list

s_list = jieba.lcut(content_str)

out_list = []

# 引入停用词表

stopwords = stopwordslist(r'E:\stopwords-master\哈工大停用词表.txt')

for word in s_list:

    if word not in stopwords:

        if word != '\t':

            out_list.append(word)

out_str = " ".join(out_list)
到这一步,就可以获得分词后的关键词了。下一步就是画词云图了。
4、画词云图
引入wordcloud,font_path是字体的路径,不导入的话可能只会显示一些框框,具体文字下载可以去网上找。mask是背景图片。generate()里的是string类型的数据。
alice_mask = plt.imread(r'D:\壁纸\huge.jpg')

# generate的是string类型的

word_cloud = WordCloud(font_path='msyh.ttc',mask=alice_mask,background_color='white', max_words=400, max_font_size=80).generate(out_str)

plt.figure(figsize=(15,9))

plt.imshow(word_cloud, interpolation="bilinear")

plt.axis('off')

plt.show()
5、结果展示
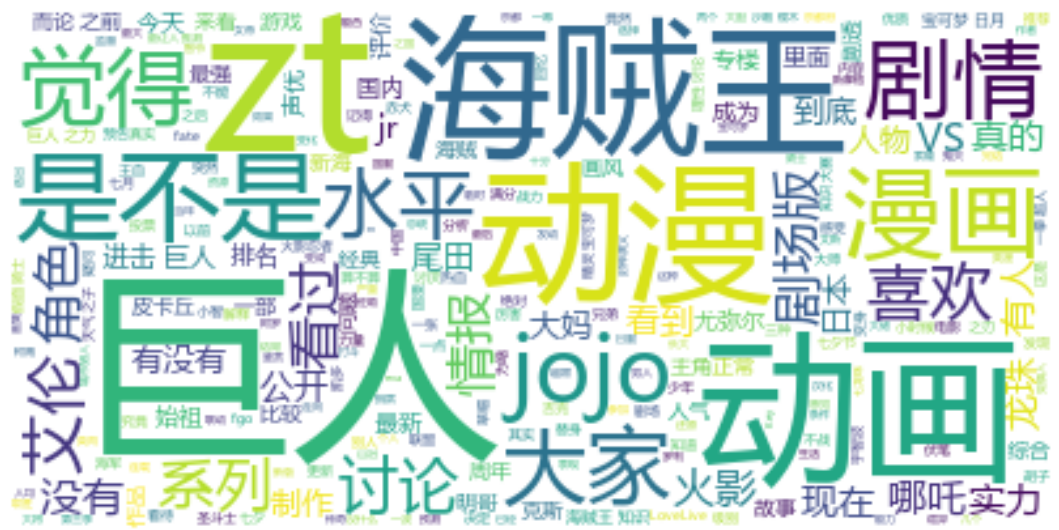
不引入mask参数:
引入mask参数:
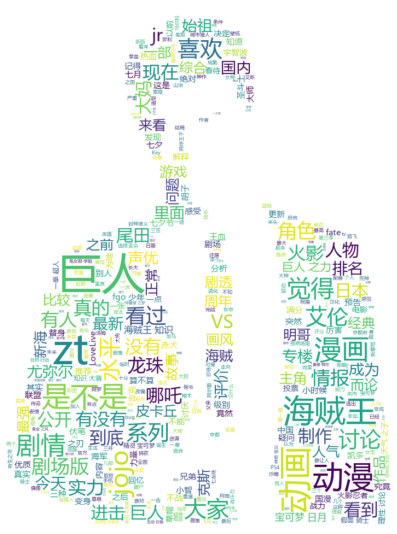
今天是8月8号,最近正好是巨人最新一话发布的时候,所以巨人的讨论度很高。同时一直支撑着虎扑acg区热度的海贼王讨论度也很高,其次的关键词还有 动画,动漫,龙珠,艾伦,漫画,情报等等。
6、需要改进的地方
(1)无关紧要的词太多了,需要自写停用词表进行去停。如最后结果中的“是不是”,“觉得”等,这些词都应该去掉
(2)引入mask的情况下,很多背景图使用了最后却没有展示出来。有的背景图可以,有的却不可以。
最后,感谢观看这篇博客。其中借鉴了许多网上的内容,感谢一些原作者的努力。
python-2:爬取某个网页(虎扑)帖子的标题做词云图的更多相关文章
- 一、python简单爬取静态网页
一.简单爬虫框架 简单爬虫框架由四个部分组成:URL管理器.网页下载器.网页解析器.调度器,还有应用这一部分,应用主要是NLP配合相关业务. 它的基本逻辑是这样的:给定一个要访问的URL,获取这个ht ...
- Python爬虫爬取百度贴吧的帖子
同样是参考网上教程,编写爬取贴吧帖子的内容,同时把爬取的帖子保存到本地文档: #!/usr/bin/python#_*_coding:utf-8_*_import urllibimport urlli ...
- 用python简单爬取一个网页
1打开编辑器 2撸几行代码 import urllib.request import urllib.error def main(): askURl("http://movie.douban ...
- Python爬虫:爬取自己博客的主页的标题,链接,和发布时间
代码 # -*- coding: utf-8 -*- """ ------------------------------------------------- File ...
- python连续爬取多个网页的图片分别保存到不同的文件夹
python连续爬取多个网页的图片分别保存到不同的文件夹 作者:vpoet mail:vpoet_sir@163.com #coding:utf-8 import urllib import ur ...
- python爬取某个网页的图片-如百度贴吧
python爬取某个网页的图片-如百度贴吧 作者:vpoet mail:vpoet_sir@163.com 注:随意copy,不用告诉我 #coding:utf-8 import urllib imp ...
- Python 爬取单个网页所需要加载的地址和CSS、JS文件地址
Python 爬取单个网页所需要加载的URL地址和CSS.JS文件地址 通过学习Python爬虫,知道根据正式表达式匹配查找到所需要的内容(标题.图片.文章等等).而我从测试的角度去使用Python爬 ...
- Python:将爬取的网页数据写入Excel文件中
Python:将爬取的网页数据写入Excel文件中 通过网络爬虫爬取信息后,我们一般是将内容存入txt文件或者数据库中,也可以写入Excel文件中,这里介绍关于使用Excel文件保存爬取到的网页数据的 ...
- python爬虫——爬取网页数据和解析数据
1.网络爬虫的基本概念 网络爬虫(又称网络蜘蛛,机器人),就是模拟客户端发送网络请求,接收请求响应,一种按照一定的规则,自动地抓取互联网信息的程序.只要浏览器能够做的事情,原则上,爬虫都能够做到. 2 ...
随机推荐
- 在网页中嵌套网页的方法(frame)
在网页中嵌套网页目前通用的方法是通过 frame 框架来完成,该方法有实际的应用意义.也能很好的解决一些问题. 但是 JS 在操作的时候需要同源(不能跨域), 否则一切 js 相关的操作无法完成. 切 ...
- Pygame模块实现功能超赞的贪吃蛇
import pygame import random import sys import pygame.freetype import re import datetime pygame.ini ...
- CF1205C Palindromic Paths
题目链接 问题分析 首先可以想到,坐标和为奇数的位置可以被唯一确定.同样的,如果假定\((1,2)\)是\(0\),那么坐标和为偶数的位置也可以被唯一确定.这样总共使用了\(n^2-3\)次询问. 那 ...
- Codeforces Round #201 (Div. 2). E--Number Transformation II(贪心)
Time Limit:1000MS Memory Limit:262144KB 64bit IO Format:%I64d & %I64u Description You ar ...
- MySQ彻底删除与安装配置
彻底删除 1.查看 MySQL 安装了哪些东西 rpm -qa |grep -i mysql 2.卸载 -.el7.x86_64 -.el7.x86_64 .noarch -.el7.x86_64 - ...
- Linux环境下TomCat使用指定JDK的版本
服务器是web服务器,在上面安装了jdk1.7和jdk1.8.及多个tomcat应用,默认/etc/profile 配置的jdk1.7,大部分tomcat应用使用的也是jdk1.7, 但目前有一个新项 ...
- Python set 用法
(原文链接)http://blog.csdn.net/business122/article/details/7541486# python的set和其他语言类似, 是一个无序不重复元素集, 基本功能 ...
- Arch linux(UEFI+GPT)安装及后续优化教程
Arch Linux安装过程中需要从远程存储库获取软件包,电脑需要有效的互联网连接. 1.联网 查看是否有网 ping www.baidu.com 同步时间 timedatectl set-ntp t ...
- LeetCode 19. 删除链表的倒数第N个节点(Remove Nth Node From End Of List)
题目描述 给定一个链表,删除链表的倒数第 n 个节点,并且返回链表的头结点. 示例: 给定一个链表: 1->2->3->4->5, 和 n = 2. 当删除了倒数第二个节点后, ...
- 使用C#语言,将DataTable 转换成域模型
DataTable dt = SqlHelper.Query(strQuery); ) * size).Take(pagesize); List<Model> listData = new ...