
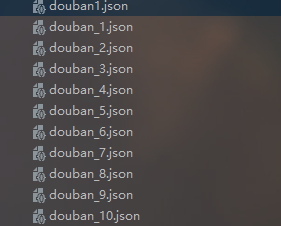
ajax的get方法获取豆瓣电影前10页的数据
# _*_ coding : utf-8 _*_

# @Time : 2021/11/2 11:45

# @Author : 秋泊酱

# 1页数据 电影条数20

# https://movie.douban.com/j/chart/top_list?type=5&interval_id=100%3A90&action=&

# start=0&limit=20

# 2页数据

# https://movie.douban.com/j/chart/top_list?type=5&interval_id=100%3A90&action=&

# start=20&limit=20

# 3页数据

# https://movie.douban.com/j/chart/top_list?type=5&interval_id=100%3A90&action=&

# start=40&limit=20

# 4页数据

# https://movie.douban.com/j/chart/top_list?type=5&interval_id=100%3A90&action=&

# start=60&limit=20

# page页      1  2   3   4

# start开始   0  20  40  60

# 算法

# start (page - 1)*20

# 下载豆瓣电影前10页的数据

# (1) 请求对象的定制

# (2) 获取响应的数据

# (3) 下载数据

import urllib.parse

import urllib.request

# 1) 请求对象的定制

def create_request(page):
  # 请求路径

    base_url = 'https://movie.douban.com/j/chart/top_list?type=5&interval_id=100%3A90&action=&'

  # 请求参数

    data = {

        'start': (page - 1) * 20,

        'limit': 20

    }

    # 常用 urllib.parse.urlencode(data) 解析data字典中的参数进行url拼接

    data = urllib.parse.urlencode(data)

   # 请求资源链接的拼接

    url = base_url + data

  # 请求头

    headers = {

        'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/92.0.4515.159 Safari/537.36'

    }

    # 请求对象的定制(url参数传递,headers参数传递)

    request = urllib.request.Request(url=url, headers=headers)

    # 函数返回

    return request

# 2) 获取响应的数据

def get_content(request):

    # 模拟浏览器B,向服务器S,发送请求

    response = urllib.request.urlopen(request)

    # 获取响应数据(read读方法返回字节形式二进制数据.decode解密)

    content = response.read().decode('utf-8')

    # 函数返回

    return content

# 3) 下载数据

def down_load(page,content):

    # python的字符串拼接,两边都要是str字符串类型

    with open('douban_' + str(page) + '.json', 'w', encoding='utf-8')as fp:
     # 向文件中写入

        fp.write(content)

# 程序的入口

if __name__ == '__main__':

    start_page = int(input('请输入起始的页码'))

    end_page = int(input('请输入结束的页面'))

    for page in range(start_page,end_page+1):

        #每一页都有自己的请求对象的定制

        request = create_request(page)

        #获取响应的数据

        content = get_content(request)
        #下载

        down_load(page,content)
ajax的get方法获取豆瓣电影前10页的数据的更多相关文章
- 如何获取豆瓣电影 API Key
如何获取豆瓣电影 API Key 豆瓣 API Key 不能使用了 ! solutions & !== ? https://frodo.douban.com/api/v2/subject_co ...
- python 获取当天和前几天时间数据
python 获取当天和前几天时间数据 import datetime from datetime import datetime, date, timedelta def dayDateRange( ...
- 解决 MySQL 比如我要拉取一个消息表中用户id为1的前10条最新数据
我们都知道,各种主流的社交应用或者阅读应用,基本都有列表类视图,并且都有滑到底部加载更多这一功能, 对应后端就是分页拉取数据.好处不言而喻,一般来说,这些数据项都是按时间倒序排列的,用户只关心最新的动 ...
- 【学习笔记】Python 3.6模拟输入并爬取百度前10页密切相关链接
[学习笔记]Python 3.6模拟输入并爬取百度前10页密切相关链接 问题描述 通过模拟网页,实现百度搜索关键词,然后获得网页中链接的文本,与准备的文本进行比较,如果有相似之处则代表相关链接. me ...
- python爬虫实战 获取豆瓣排名前250的电影信息--基于正则表达式
一.项目目标 爬取豆瓣TOP250电影的评分.评价人数.短评等信息,并在其保存在txt文件中,html解析方式基于正则表达式 二.确定页面内容 爬虫地址:https://movie.douban.co ...
- 利用AJAX JAVA 通过Echarts实现豆瓣电影TOP250的数据可视化
mysql表的结构 数据(数据是通过爬虫得来的,本篇文章不介绍怎么爬取数据,只介绍将数据库中的数据可视化): 下面就是写代码了: 首先看一下项目目录: 数据库层 业务逻辑层 pac ...
- 【Python爬虫】:使用高性能异步多进程爬虫获取豆瓣电影Top250
在本篇博文当中,将会教会大家如何使用高性能爬虫,快速爬取并解析页面当中的信息.一般情况下,如果我们请求网页的次数太多,每次都要发出一次请求,进行串行执行的话,那么请求将会占用我们大量的时间,这样得不偿 ...
- 获取豆瓣电影数据(R与API获取网页数据)
一般成熟的网站都会有反爬虫策略,例如限制访问次数,限制访问 IP,动态显示数据等.爬虫和反爬虫就是一直相爱相杀地互相钳制.如果要通过爬虫来获取某些大型网站的数据,那是一件很费时费力的活.小白总遭遇过在 ...
- sql分组(orderBy、GroupBy)获取每组前一(几)条数据
sql数据库实现分组并取每组的前1(几)条数据 测试数据准备工作: 根据某一个字段分组取最大(小)值所在行的数据: 创建表并且插入数据 ),Val )) , 'a1--a的第一个值') , 'b2b2 ...
随机推荐
- vector 的交换技巧
面试被问到如何解决 vector 有过多空闲内存的问题. 假定先有一 vector 容器 vec,它的容量是 10000,大小是 3. vector 的内存增长问题 vector 申请的是连续内存空间 ...
- MyBatis-Plus——实践篇
MyBatis-Plus--实践篇 MyBatis-Plus (简称 MP)是一个 MyBatis的增强工具,在 MyBatis 的基础上只做增强不做改变,为简化开发.提高效率而生.进行数据库操作常用 ...
- Windows下的程序及热键监视神器——Spy++
Windows下的程序及热键监视神器--Spy++ 背景 在使用Windows的时候,偶尔会发现某些应用程序的热键不生效了:又或是桌面弹出了弹框却并不知道这个弹框来自何处.例如,本人最近使用Vim的时 ...
- 洛谷4051 JSOI2007 字符加密(SA)
真是一道良好的SA模板题 首先,由于涉及到从左边移动到右边这个过程,我们不妨直接把字符串复制一遍,接在后面. 然后直接构造后缀数组,按排名从小到大,枚举所有的位置,如果这个后缀的起始点是在原串中的,那 ...
- Less-(1~4) union select
Less-1: 核心语句: 无任何防护:回显查询结果或错误内容. 输入单引号闭合语句中的单引号,#注释后面的内容,即可注入.由于有查询结果回显,直接联合注入即可. 1'order by x #(有些环 ...
- Kafka消息(存储)格式及索引组织方式
要深入学习Kafka,理解Kafka的存储机制是非常重要的.本文介绍Kafka存储消息的格式以及数据文件和索引组织方式,以便更好的理解Kafka是如何工作的. Kafka消息存储格式 Kafka为了保 ...
- Tekton+Argocd实现自动化流水线
目录 什么是tekton 安装tekton 安装Dashboard Tekton提供的CRD 安装argocd 创建argocd 安装客户端 连接argocd server 创建App 集群中查看效果 ...
- 240.搜索二维矩阵II
从左下角位置开始搜索 时间复杂度:O(行数+列数). 想法有点像二分法,大了往一个方向找,小了往另一个方向找.由于矩阵横向和纵向都是递增,如果从(0,0)位置开始找,往右和往下都是增大,因此不知道实际 ...
- 第五课第四周笔记1:Transformer Network Intuition 变压器网络直觉
目录 Transformer Network Intuition 变压器网络直觉 Transformer Network Intuition 变压器网络直觉 深度学习中最令人兴奋的发展之一是 Tran ...
- [no code][scrum meeting] Alpha 3
项目 内容 会议时间 2020-04-07 会议主题 技术规格说明书review 会议时长 1h30min 参会人员 产品经理+后端技术组长(伦泽标)+OCR竞品调研成员(叶开辉)+架构文档负责(黎正 ...