
python爬虫---requests库的用法
requests是python实现的简单易用的HTTP库,使用起来比urllib简洁很多
因为是第三方库,所以使用前需要cmd安装
pip install requests
安装完成后import一下,正常则说明可以开始使用了。
基本用法:
requests.get()用于请求目标网站,类型是一个HTTPresponse类型
import requests

response = requests.get('http://www.baidu.com')
print(response.status_code)  # 打印状态码
print(response.url)          # 打印请求url
print(response.headers)      # 打印头信息
print(response.cookies)      # 打印cookie信息

print(response.text)  #以文本形式打印网页源码
print(response.content) #以字节流形式打印
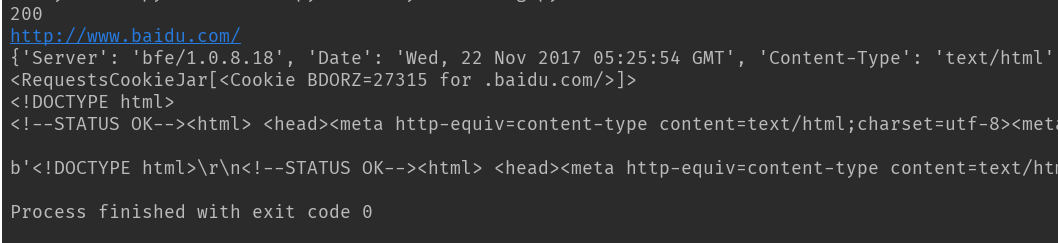
运行结果:
状态码:200
url:www.baidu.com
headers信息
各种请求方式:
import requests

requests.get('http://httpbin.org/get')

requests.post('http://httpbin.org/post')

requests.put('http://httpbin.org/put')

requests.delete('http://httpbin.org/delete')

requests.head('http://httpbin.org/get')

requests.options('http://httpbin.org/get')
基本的get请求
import requests

response = requests.get('http://httpbin.org/get')

print(response.text)
结果

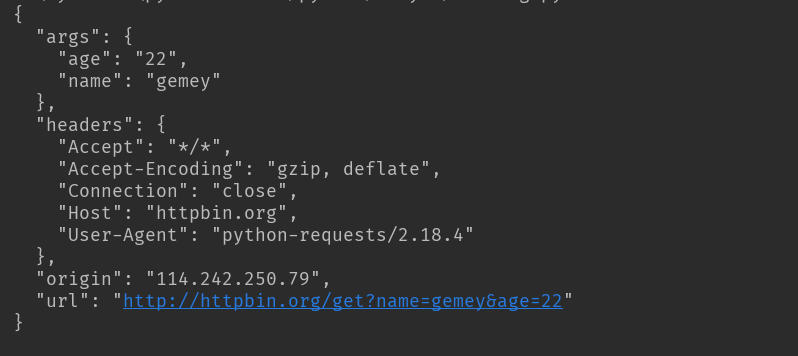
带参数的GET请求:
第一种直接将参数放在url内
import requests

response = requests.get(http://httpbin.org/get?name=gemey&age=22)

print(response.text)
结果
另一种先将参数填写在dict中,发起请求时params参数指定为dict
import requests

data = {

    'name': 'tom',

    'age': 20

}

response = requests.get('http://httpbin.org/get', params=data)

print(response.text)
结果同上
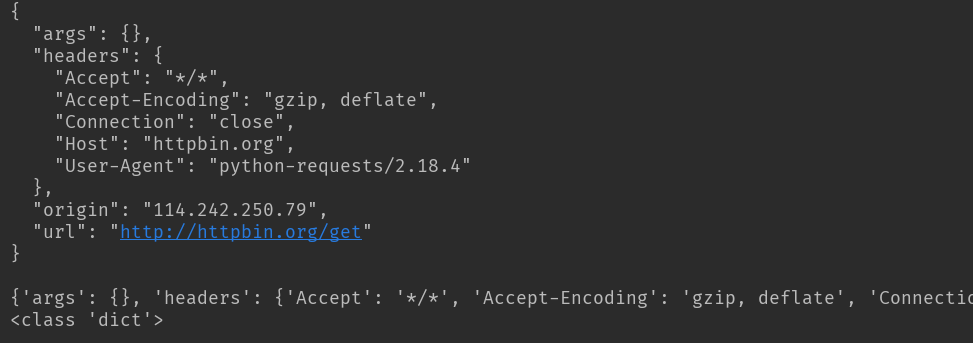
解析json
import requests

response = requests.get('http://httpbin.org/get')

print(response.text)

print(response.json())  #response.json()方法同json.loads(response.text)

print(type(response.json()))
结果
简单保存一个二进制文件
二进制内容为response.content
import requests

response = requests.get('http://img.ivsky.com/img/tupian/pre/201708/30/kekeersitao-002.jpg')

b = response.content

with open('F://fengjing.jpg','wb') as f:

    f.write(b)
为你的请求添加头信息
import requests
heads = {}
heads['User-Agent'] = 'Mozilla/5.0 ' \
                          '(Macintosh; U; Intel Mac OS X 10_6_8; en-us) AppleWebKit/534.50 ' \
                          '(KHTML, like Gecko) Version/5.1 Safari/534.50'
response = requests.get('http://www.baidu.com',headers=headers)
使用代理
同添加headers方法,代理参数也要是一个dict
这里使用requests库爬取了IP代理网站的IP与端口和类型
因为是免费的,使用的代理地址很快就失效了。
import requests

import re

def get_html(url):

    proxy = {

        'http': '120.25.253.234:812',

        'https' '163.125.222.244:8123'

    }

    heads = {}

    heads['User-Agent'] = 'Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/49.0.2623.221 Safari/537.36 SE 2.X MetaSr 1.0'

    req = requests.get(url, headers=heads,proxies=proxy)

    html = req.text

    return html

def get_ipport(html):

    regex = r'<td data-title="IP">(.+)</td>'

    iplist = re.findall(regex, html)

    regex2 = '<td data-title="PORT">(.+)</td>'

    portlist = re.findall(regex2, html)

    regex3 = r'<td data-title="类型">(.+)</td>'

    typelist = re.findall(regex3, html)

    sumray = []

    for i in iplist:

        for p in portlist:

            for t in typelist:

                pass

            pass

        a = t+','+i + ':' + p

        sumray.append(a)

    print('高匿代理')

    print(sumray)

if __name__ == '__main__':

    url = 'http://www.kuaidaili.com/free/'

    get_ipport(get_html(url))
结果:

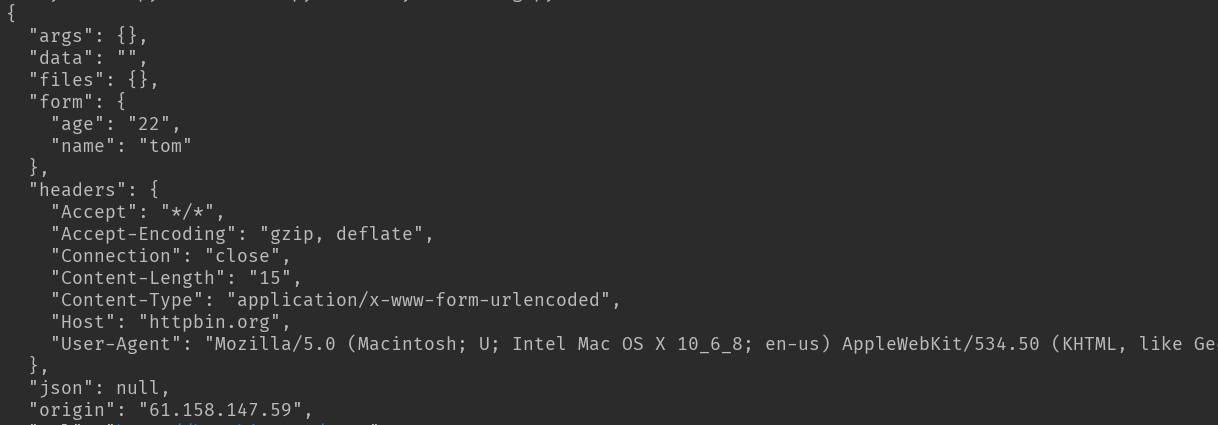
基本POST请求:
import requests

data = {'name':'tom','age':''}

response = requests.post('http://httpbin.org/post', data=data)
获取cookie
#获取cookie

import requests

response = requests.get('http://www.baidu.com')

print(response.cookies)

print(type(response.cookies))

for k,v in response.cookies.items():

    print(k+':'+v)
结果:

会话维持
import requests

session = requests.Session()

session.get('http://httpbin.org/cookies/set/number/12345')

response = session.get('http://httpbin.org/cookies')

print(response.text)
结果:

证书验证设置
import requests

from requests.packages import urllib3

urllib3.disable_warnings()  #从urllib3中消除警告

response = requests.get('https://www.12306.cn',verify=False)  #证书验证设为FALSE

print(response.status_code)

打印结果:200
超时异常捕获
import requests

from requests.exceptions import ReadTimeout

try:

    res = requests.get('http://httpbin.org', timeout=0.1)

    print(res.status_code)

except ReadTimeout:

    print(timeout)
异常处理
在你不确定会发生什么错误时,尽量使用try...except来捕获异常
所有的requests exception:
Exceptions
import requests

from requests.exceptions import ReadTimeout,HTTPError,RequestException

try:

    response = requests.get('http://www.baidu.com',timeout=0.5)

    print(response.status_code)

except ReadTimeout:

    print('timeout')

except HTTPError:

    print('httperror')

except RequestException:

    print('reqerror')
python爬虫---requests库的用法的更多相关文章
- python爬虫---selenium库的用法
python爬虫---selenium库的用法 selenium是一个自动化测试工具,支持Firefox,Chrome等众多浏览器 在爬虫中的应用主要是用来解决JS渲染的问题. 1.使用前需要安装这个 ...
- Python爬虫—requests库get和post方法使用
目录 Python爬虫-requests库get和post方法使用 1. 安装requests库 2.requests.get()方法使用 3.requests.post()方法使用-构造formda ...
- Python爬虫--Requests库
Requests Requests是用python语言基于urllib编写的,采用的是Apache2 Licensed开源协议的HTTP库,requests是python实现的最简单易用的HTTP库, ...
- 【Python成长之路】Python爬虫 --requests库爬取网站乱码(\xe4\xb8\xb0\xe5\xa)的解决方法【华为云分享】
[写在前面] 在用requests库对自己的CSDN个人博客(https://blog.csdn.net/yuzipeng)进行爬取时,发现乱码报错(\xe4\xb8\xb0\xe5\xaf\x8c\ ...
- Python爬虫 requests库基础
requests库简介 requests是使用Apache2 licensed 许可证的HTTP库. 用python编写. 比urllib2模块更简洁. Request支持HTTP连接保持和连接池,支 ...
- Python爬虫---requests库快速上手
一.requests库简介 requests是Python的一个HTTP相关的库 requests安装: pip install requests 二.GET请求 import requests # ...
- python爬虫——requests库使用代理
在看这篇文章之前,需要大家掌握的知识技能: python基础 html基础 http状态码 让我们看看这篇文章中有哪些知识点: get方法 post方法 header参数,模拟用户 data参数,提交 ...
- Python 爬虫-Requests库入门
2017-07-25 10:38:30 response = requests.get(url, params=None, **kwargs) url : 拟获取页面的url链接∙ params : ...
- (转)Python爬虫利器一之Requests库的用法
官方文档 以下内容大多来自于官方文档,本文进行了一些修改和总结.要了解更多可以参考 官方文档 安装 利用 pip 安装 $ pip install requests 或者利用 easy_install ...
随机推荐
- 使用CSS实现三栏自适应布局(两边宽度固定,中间自适应)
来源:http://blog.csdn.net/cinderella_hou/article/details/52156333 所谓三列自适应布局指的是两边定宽,中间block宽度自适应.这道题在今年 ...
- 3、Python函数详解(0601)
回顾: re search,findall,finditer.sub,subn function () 调用函数 def func_name(arg1,....) 生成函数对象 func_s ...
- Idea中配置Tomcat
配置步骤 在idea项目左上角选择‘Edit Configurations’ 2. 配置server 3. 配置项目 4. 配置成功后就可以在项目下面看到tomcat了 运行Tomcat遇到权限问题: ...
- 使用fiddler轻轻松松制造客户端接口time out的情况
1.打开fiddler,过滤出你想要的请求 2.复制出你想要中断的请求 3.设置中断这个请求,bpu+请求,回车(详情请百度fiddle默认命令) 4.ctrl+x(清楚所有的请求),刷新页面,重新获 ...
- 四: scrapy爬虫框架
5.爬虫系列之scrapy框架 一 scrapy框架简介 1 介绍 (1) 什么是Scrapy? Scrapy是一个为了爬取网站数据,提取结构性数据而编写的应用框架,非常出名,非常强悍.所谓的框架 ...
- Java技术——你真的了解String类的intern()方法吗
0.引言 什么都先不说,先看下面这个引入的例子: String str1 = new String("SEU")+ new String("Calvin") ...
- XML_CPP_libXml2_VC6_Code_ZC
ZC:iconv.dll.libxml2.dll.zlib1.dll 放到 exe所在目录下 1.代码来源于 帖子:XML_CPP_资料_libXml2_01_Code_ZC(?.pro) 2.代码: ...
- python测试相关小问题
实操中的小问题 pycharm 一次运行多个test configuration 项目分层,分包之后,tests也分到不同层的不同project里了,tests也分开. 为了防止基层模块改动,影响上层 ...
- 2017-2018 ACM-ICPC, Asia Tsukuba Regional Contest
2017-2018 ACM-ICPC, Asia Tsukuba Regional Contest A Secret of Chocolate Poles 思路:暴力枚举黑巧克力的个数和厚黑巧克力的个 ...
- Python 读写操作Excel —— 安装第三方库(xlrd、xlwt、xlutils、openpyxl)
数据处理是 Python 的一大应用场景,而 Excel 则是最流行的数据处理软件.因此用 Python 进行数据相关的工作时,难免要和 Excel 打交道. 如果仅仅是要以表单形式保存数据,可以借助 ...