
Python 爬虫-Requests库入门
2017-07-25 10:38:30
response = requests.get(url, params=None, **kwargs)
- url : 拟获取页面的url链接∙ params : url中的额外参数,字典或字节流格式,可选
- params参数是字典或字节序列,作为参数增加到url中
kv = {'key1': 'value1', 'key2': 'value2'}

>>> r = requests.request('GET', 'http://python123.io/ws', params=kv)

>>> print(r.url)

http://python123.io/ws?key1=value1&key2=value2
- **kwargs: 12个控制访问的参数
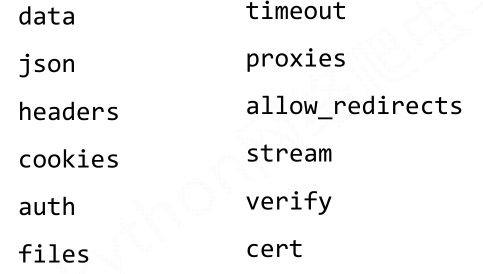
headers:字典,HTTP定制头
 hd = {'user‐agent': 'Chrome/10'}

 r = requests.request('POST', 'http://python123.io/ws', headers=hd)
timeout : 设定超时时间,秒为单位
r = requests.request('GET', 'http://www.baidu.com', timeout=10)
proxies : 字典类型,设定访问代理服务器,可以增加登录认证
>>> pxs = { 'http': 'http://user:pass@10.10.10.1:1234'

'https': 'https://10.10.10.1:4321' }

>>> r = requests.request('GET', 'http://www.baidu.com', proxies=pxs)
使用举例:
import requests

# r:response 右侧get: requests

r = requests.get('http://jwc.seu.edu.cn/')
一、返回值Response对象的属性
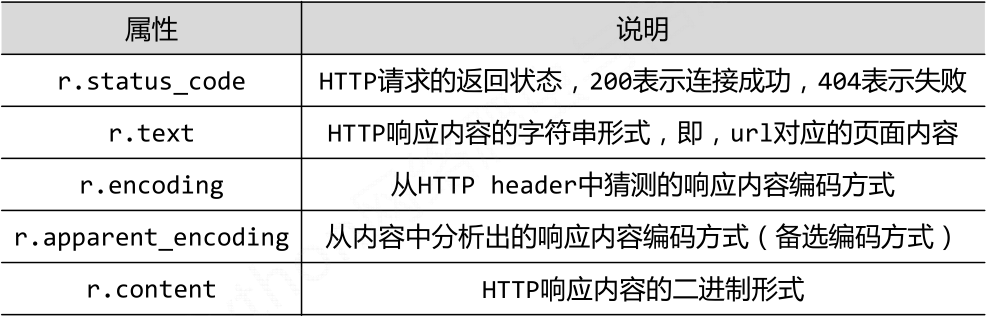

二、爬取网页的通用代码框架
import requests

def gethtml(url):

    # 打开网页有风险,需要使用try-except语句进行风险控制

    try:

        r = requests.get(url)

        r.raise_for_status()   # 如果打开失败,则会抛出一个HttpError异常

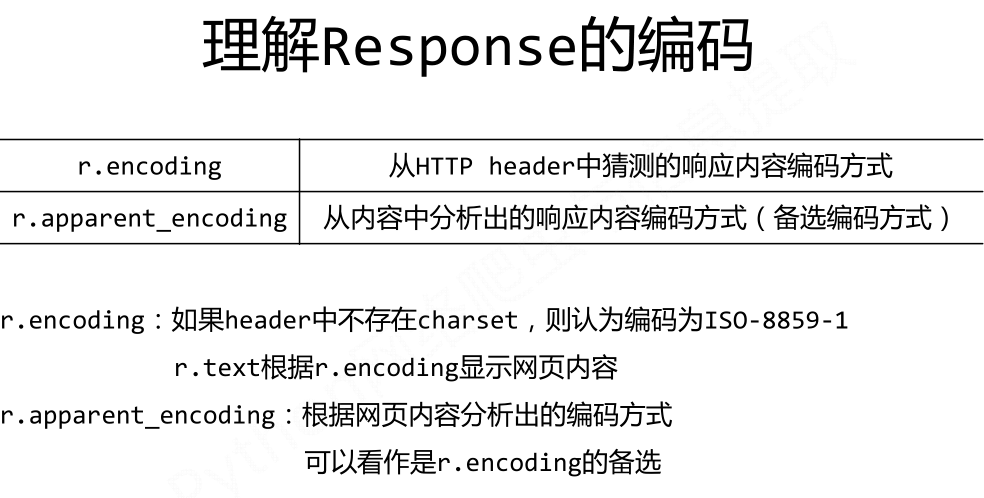
        # encoding是从header中分析出来的编码方式,apparent_encoding是 从内容分析出的编码方式

        r.encoding=r.apparent_encoding

        return r.text

    except:

        print("打开失败")
三、requests库的方法和HTTP协议
- HTTP协议:超文本传输协议
HTTP是一个基于“请求与响应”模式的、无状态的应用层协议。
HTTP协议采用URL作为定位网络资源的标识,URL格式如下:http://host[:port][path]
HTTP协议对资源的操作方法:

其中get,head方法是从服务器取回数据,post,put,patch,delete方法是向服务器写入或者修改数据。
patch 和 put 的区别:patch 是局部更新,而put 是全部更新。patch节省网络带宽,是HTTP协议改良后的新增指令。
HTTP的指令和requests 的方法一一对应。
- Requests 的七个主要方法

Python 爬虫-Requests库入门的更多相关文章
- Python爬虫—requests库get和post方法使用
目录 Python爬虫-requests库get和post方法使用 1. 安装requests库 2.requests.get()方法使用 3.requests.post()方法使用-构造formda ...
- Python爬虫--Requests库
Requests Requests是用python语言基于urllib编写的,采用的是Apache2 Licensed开源协议的HTTP库,requests是python实现的最简单易用的HTTP库, ...
- 【Python成长之路】Python爬虫 --requests库爬取网站乱码(\xe4\xb8\xb0\xe5\xa)的解决方法【华为云分享】
[写在前面] 在用requests库对自己的CSDN个人博客(https://blog.csdn.net/yuzipeng)进行爬取时,发现乱码报错(\xe4\xb8\xb0\xe5\xaf\x8c\ ...
- Python爬虫 requests库基础
requests库简介 requests是使用Apache2 licensed 许可证的HTTP库. 用python编写. 比urllib2模块更简洁. Request支持HTTP连接保持和连接池,支 ...
- python爬虫---requests库的用法
requests是python实现的简单易用的HTTP库,使用起来比urllib简洁很多 因为是第三方库,所以使用前需要cmd安装 pip install requests 安装完成后import一下 ...
- Python爬虫---requests库快速上手
一.requests库简介 requests是Python的一个HTTP相关的库 requests安装: pip install requests 二.GET请求 import requests # ...
- python爬虫——requests库使用代理
在看这篇文章之前,需要大家掌握的知识技能: python基础 html基础 http状态码 让我们看看这篇文章中有哪些知识点: get方法 post方法 header参数,模拟用户 data参数,提交 ...
- Python爬虫的简单入门(一)
Python爬虫的简单入门(一) 简介 这一系列教学是基于Python的爬虫教学在此之前请确保你的电脑已经成功安装了Python(本教程使用的是Python3).爬虫想要学的精通是有点难度的,尤其是遇 ...
- python爬虫---selenium库的用法
python爬虫---selenium库的用法 selenium是一个自动化测试工具,支持Firefox,Chrome等众多浏览器 在爬虫中的应用主要是用来解决JS渲染的问题. 1.使用前需要安装这个 ...
随机推荐
- MFC六大核心机制之五、六:消息映射和命令传递
作为C++程序员,我们总是希望自己程序的所有代码都是自己写出来的,如果使用了其他的一些库,也总是千方百计想弄清楚其中的类和函数的原理,否则就会感觉不踏实.所以,我们对于在进行MFC视窗程序设计时经常要 ...
- jquery ui draggable,droppable 学习总结
刚接触的时候,分不清draggable和droppable的区别,瞎弄了一会,其实很简单,draggable就是“拖”的功能,droppable就是“放”的功能. draggable()是被拖动的元素 ...
- python退出多重循环
假设一段python程序有多重循环,我们都知道在一个循环当中,用break是退出当前的循环,然后继续下一次循环,但是如何才能跳出多重循环呢,实际就是结束所有的循环. 思路1::可以定义一个异常类,在需 ...
- 由浅入深之Tensorflow(3)----数据读取之TFRecords
转载自http://blog.csdn.net/u012759136/article/details/52232266 原文作者github地址 概述 关于Tensorflow读取数据,官网给出了三种 ...
- linux服务器---代理认证
代理认证 proxy代理服务被广泛的使用,为了安全起见,可以在服务器上增加一层安全认证机制.这里使用htpasswd建立认证账号和密码 1.创建认证账号和密码 [root@localhost wj]# ...
- 如何在Qt Creator中创建pri文件,以及pri文件的说明
初学Qt的人可还不会接触到这个问题,但是一旦你开始编写某个较大项目的时候,这个问题就不可避免需要解决. 对于大神们来讲可能这是个很简单的问题,但是对于新手来说,想要搞清楚需要下很大功夫. 怎么创建pr ...
- MySQL数据库----完整性约束
一.介绍 约束条件与数据类型的宽度一样,都是可选参数 作用:用于保证数据的完整性和一致性主要分为: PRIMARY KEY (PK) 标识该字段为该表的主键,可以唯一的标识记录 FOREIGN KEY ...
- 20145216史婧瑶 《网络对抗》 MSF基础应用
20145216史婧瑶 <网络对抗> MSF基础应用 实验回答问题 用自己的话解释什么是exploit,payload,encode. exploit:渗透攻击模块,测试者利用它来攻击一个 ...
- 20165310 Java实验四 《Android程序设计》
20165310 实验四 <Android程序设计> 第24章:初识Android 任务一:改写res目录中的内容,Hello World后要显示自己的学号,自己学号前后一名同学的学号 首 ...
- 微内核VS宏内核【转】
本文转载自:https://segmentfault.com/a/1190000002711544 内核按照体系结构分为两类 : 微内核(microkernel)与宏内核(macrokernel). ...