
linux -- 基于zookeeper搭建yarn的HA高可用集群
linux -- 基于zookeeper搭建yarn的HA高可用集群
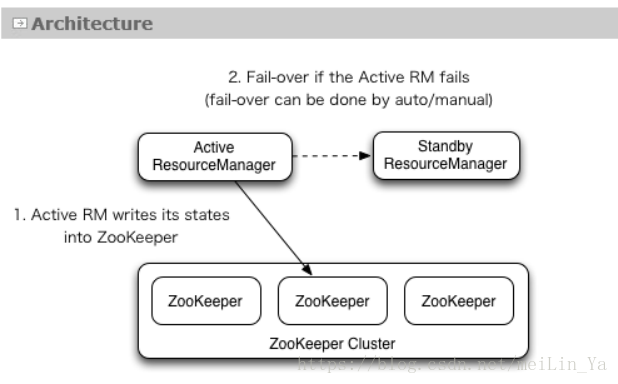
实现方式:配置yarn-site.xml配置文件
<configuration>

 <property>

   <name>yarn.resourcemanager.connect.retry-interval.ms</name>

   <value>2000</value>

 </property>

 <property>

   <name>yarn.resourcemanager.ha.enabled</name>

   <value>true</value>

 </property>

 <property>

   <name>yarn.resourcemanager.ha.automatic-failover.enabled</name>

   <value>true</value>

 </property>

 <property>

   <name>yarn.resourcemanager.ha.automatic-failover.embedded</name>

   <value>true</value>

 </property>

 <property>

   <name>yarn.resourcemanager.cluster-id</name>

   <value> beiwangyarn</value>

 </property>

 <property>

   <name>yarn.resourcemanager.ha.rm-ids</name>

   <value>rm1,rm2</value>

 </property>

 <property>

   <name>yarn.resourcemanager.hostname.rm1</name>

   <value>1707a-hadoop1</value>

 </property>

  <property>

   <name>yarn.resourcemanager.hostname.rm2</name>

   <value>1707a-hadoop2</value>

 </property>

 <property>

   <name>yarn.resourcemanager.scheduler.class</name>

  <value>org.apache.hadoop.yarn.server.resourcemanager.scheduler.fair.FairScheduler</value>

 </property>

 <property>

   <name>yarn.resourcemanager.recovery.enabled</name>

   <value>true</value>

 </property>

  <property>

   <name>yarn.resourcemanager.store.class</name>

   <value>org.apache.hadoop.yarn.server.resourcemanager.recovery.ZKRMStateStore</value>

 </property>

 <property>

   <name>yarn.resourcemanager.zk.state-store.address</name>

   <value>1707a-hadoop1:2181,1707a-hadoop2:2181,1707a-hadoop3:2181</value>

 </property>

 <property>

   <name>yarn.app.mapreduce.am.scheduler.connection.wait.interval-ms</name>

   <value>5000</value>

 </property>

 <property>

   <name>yarn.resourcemanager.address.rm1</name>

   <value>1707a-hadoop1:8032</value>

 </property>

 <property>

   <name>yarn.resourcemanager.scheduler.address.rm1</name>

   <value>1707a-hadoop1:8030</value>

 </property>

 <property>

   <name>yarn.resourcemanager.webapp.https.address.rm1</name>

   <value>1707a-hadoop1:23189</value>

 </property>

 <property>

   <name>yarn.resourcemanager.webapp.address.rm1</name>

   <value>1707a-hadoop1:8088</value>

 </property>

 <property>

   <name>yarn.resourcemanager.resource-tracker.address.rm1</name>

   <value>1707a-hadoop1:8031</value>

 </property>

 <property>

   <name>yarn.resourcemanager.admin.address.rm1</name>

   <value>1707a-hadoop1:8033</value>

 </property>

 <property>

   <name>yarn.resourcemanager.address.rm2</name>

   <value>1707a-hadoop2:8032</value>

 </property>

 <property>

   <name>yarn.resourcemanager.scheduler.address.rm2</name>

   <value>1707a-hadoop2:8030</value>

 </property>

 <property>

   <name>yarn.resourcemanager.webapp.https.address.rm2</name>

   <value>1707a-hadoop2:23189</value>

 </property>

 <property>

   <name>yarn.resourcemanager.webapp.address.rm2</name>

   <value>1707a-hadoop2:8088</value>

 </property>

 <property>

   <name>yarn.resourcemanager.resource-tracker.address.rm2</name>

   <value>1707a-hadoop2:8031</value>

 </property>

 <property>

   <name>yarn.resourcemanager.admin.address.rm2</name>

   <value>1707a-hadoop2:8033</value>

 </property>

 <property>

   <description>Address where the localizer IPC is.</description>

   <name>yarn.nodemanager.localizer.address</name>

   <value>0.0.0.0:23344</value>

 </property>

 <property>

   <description>NM Webapp address.</description>

   <name>yarn.nodemanager.webapp.address</name>

   <value>0.0.0.0:23999</value>

 </property>

 <property>

   <name>yarn.nodemanager.aux-services</name>

   <value>mapreduce_shuffle</value>

 </property>

 <property>

   <name>yarn.nodemanager.aux-services.mapreduce_shuffle.class</name>

   <value>org.apache.hadoop.mapred.ShuffleHandler</value>

 </property>

 <property>

   <name>yarn.nodemanager.local-dirs</name>

   <value>/tmp/pseudo-dist/yarn/local</value>

 </property>

 <property>

   <name>yarn.nodemanager.log-dirs</name>

   <value>/tmp/pseudo-dist/yarn/log</value>

 </property>

 <property>

   <name>mapreduce.shuffle.port</name>

   <value>23080</value>

 </property>

 <property>

   <name>yarn.resourcemanager.zk-address</name>

   <value>1707a-hadoop1:2181,1707a-hadoop2:2181,1707a-hadoop3:2181</value>

 </property>

</configuration>
将mapred-site.xml.template改为:mapred-site.xml
<configuration>

<property>

    <name>mapreduce.framework.name</name>

    <value>yarn</value>

    <final>true</final>

    </property>

    <property>

    <name>mapreduce.jobhistory.address</name>

    <value>hu-hadoop1:10020</value>

    </property>

    <property>

    <name>mapreduce.jobhistory.webapp.address</name>

    <value>hu-hadoop1:19888</value>

    </property>

</configuration>
同步数据
scp * hu-hadoop3:/`pwd`

启动:
start-yarn.sh
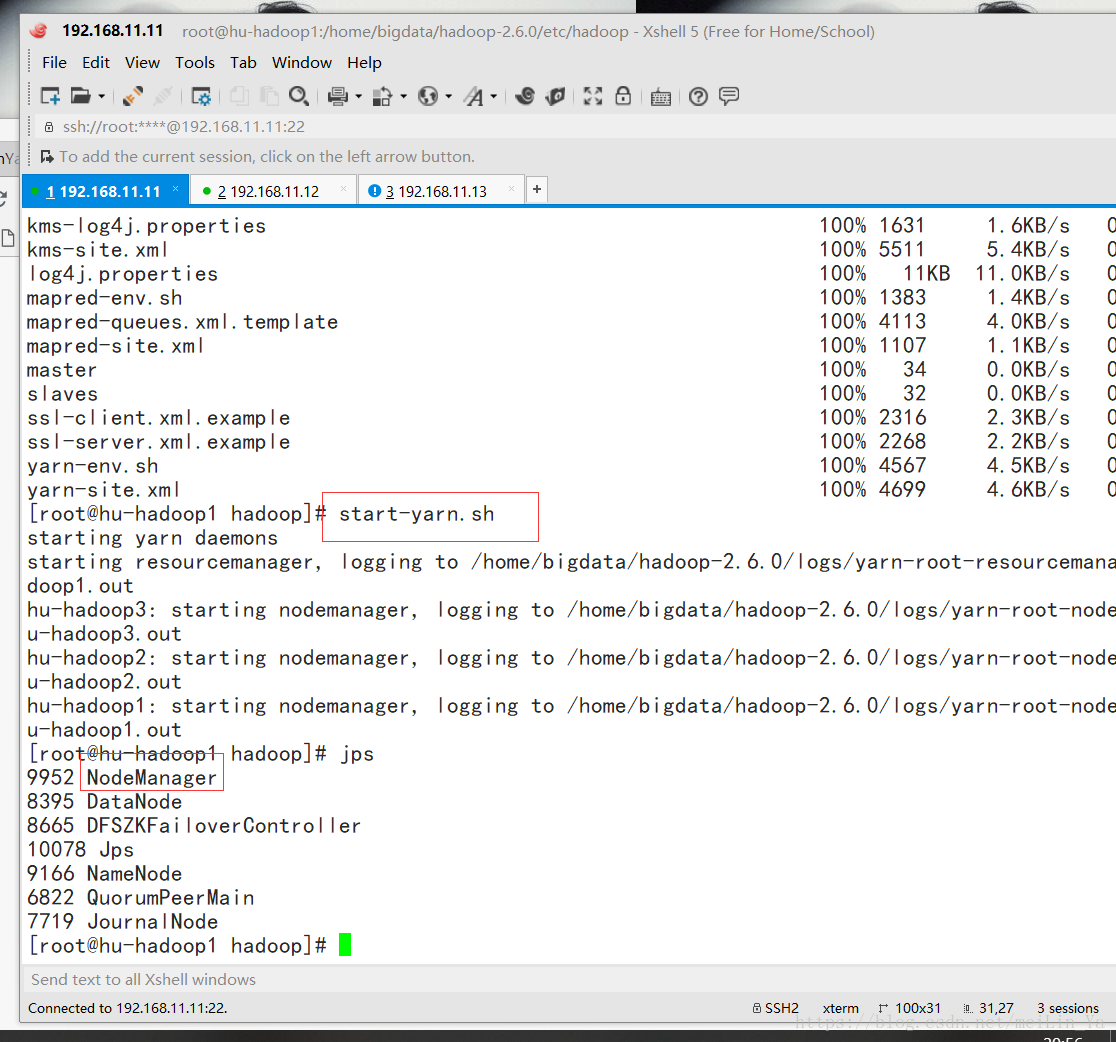
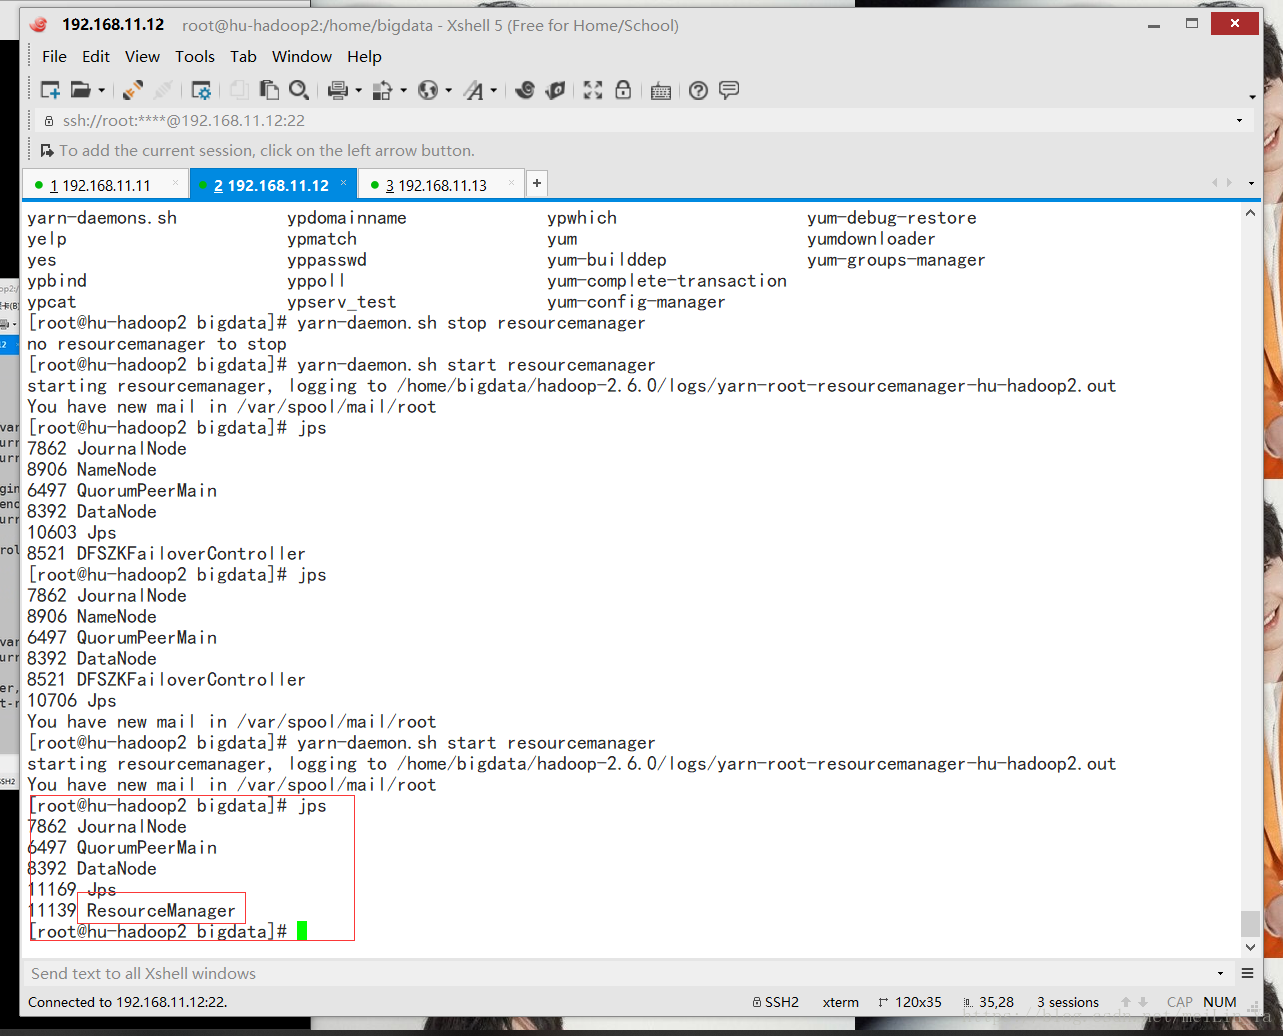
手动在hu-hadoop2中启动ResourceManager
yarn-daemon.sh start resourcemanager

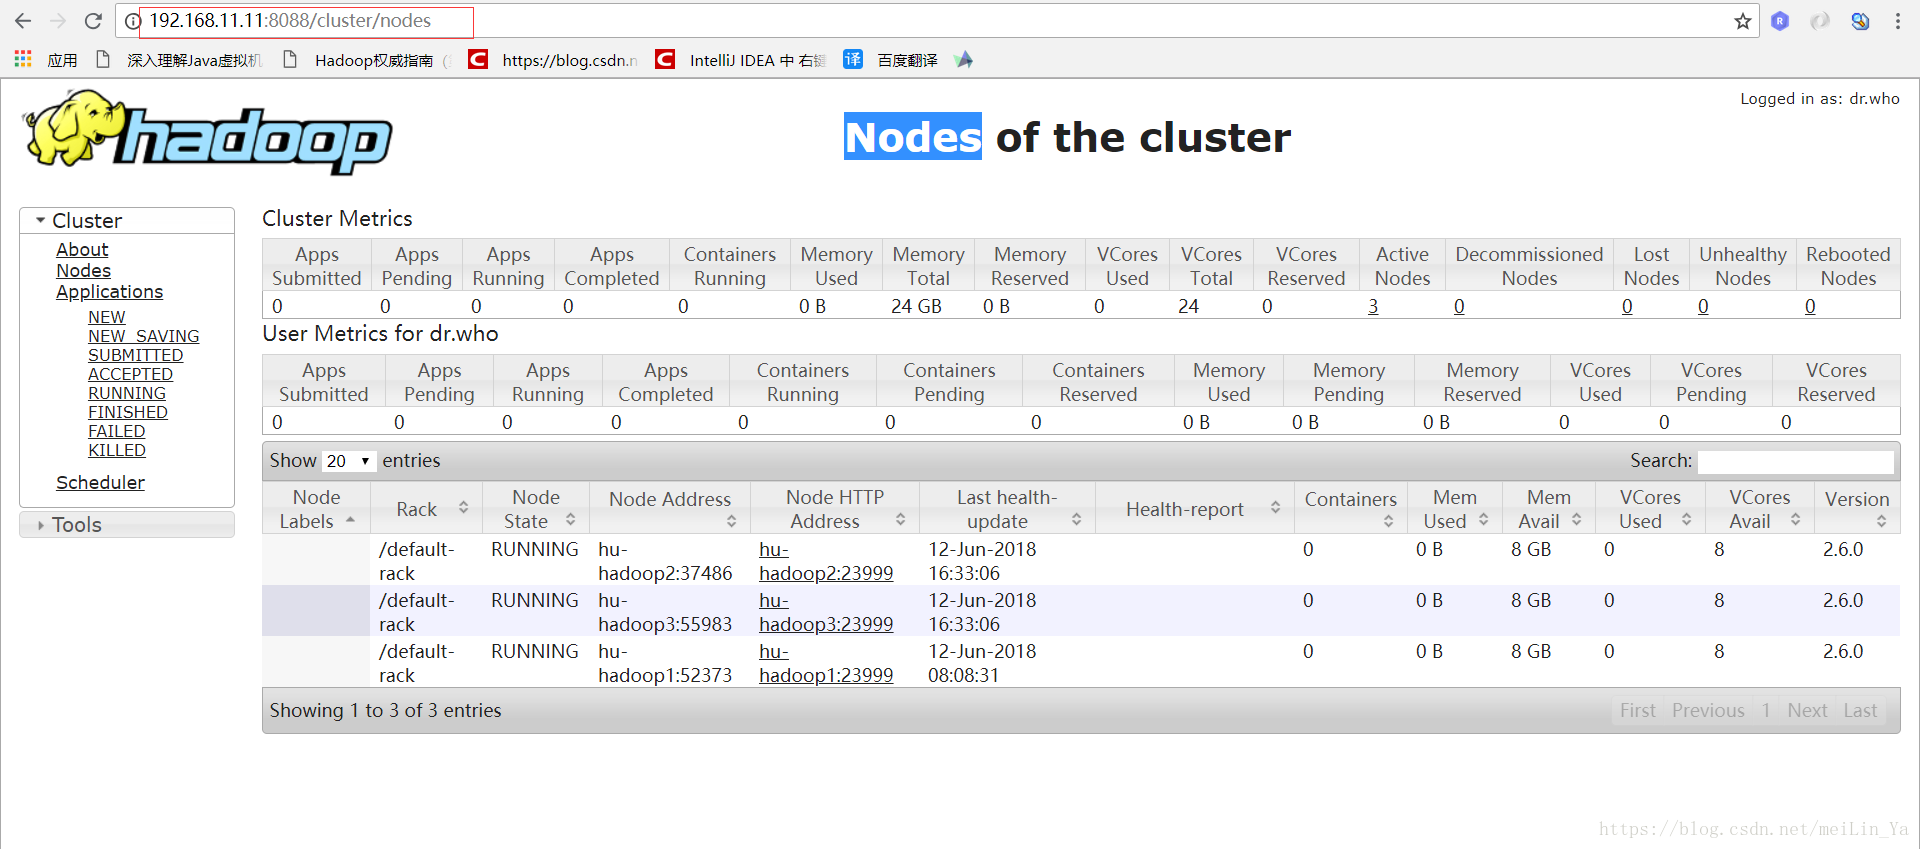
看看网页吧!!!
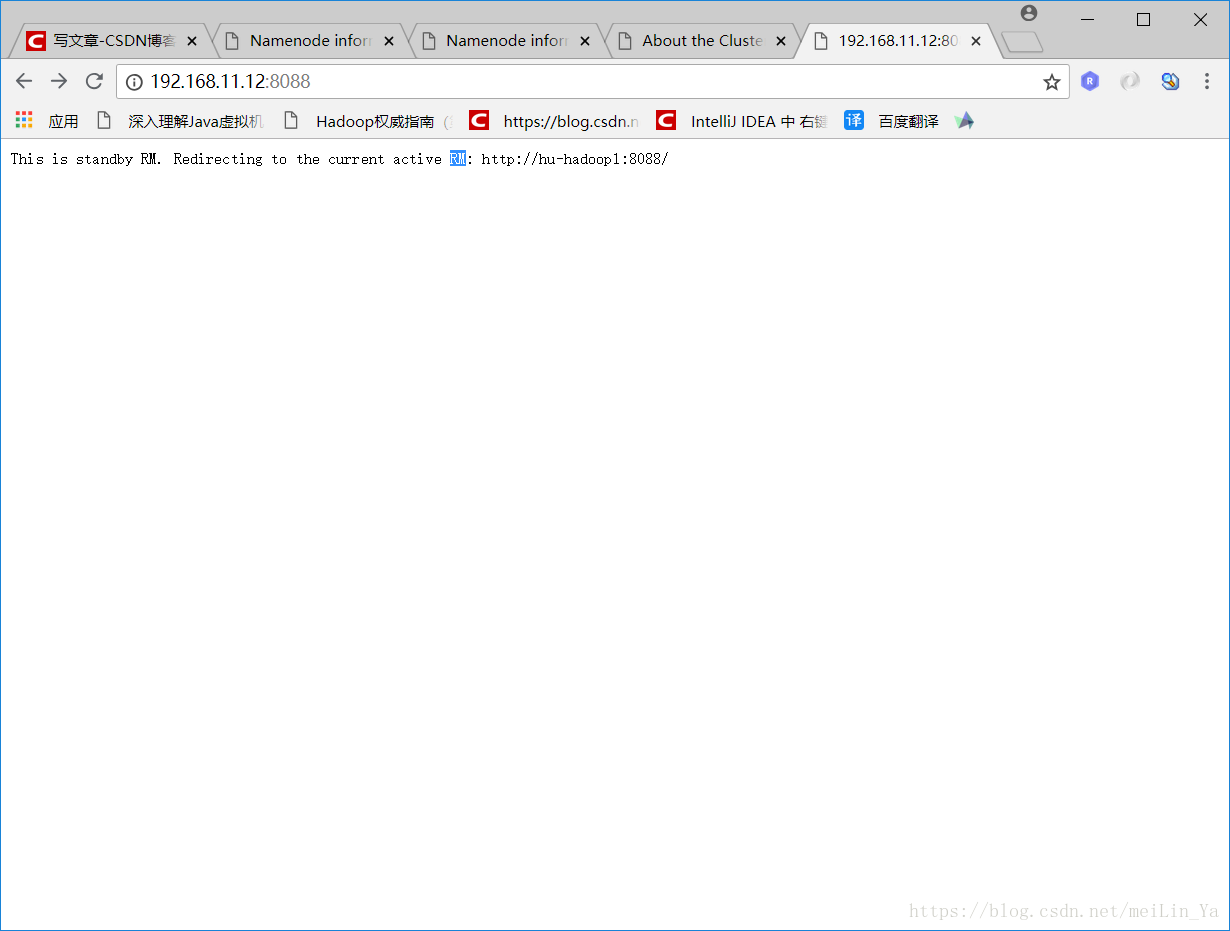
之后他会跳到主的页面中:
linux -- 基于zookeeper搭建yarn的HA高可用集群的更多相关文章
- 七、Hadoop3.3.1 HA 高可用集群QJM (基于Zookeeper,NameNode高可用+Yarn高可用)
目录 前文 Hadoop3.3.1 HA 高可用集群的搭建 QJM 的 NameNode HA Hadoop HA模式搭建(高可用) 1.集群规划 2.Zookeeper集群搭建: 3.修改Hadoo ...
- Hadoop HA高可用集群搭建(Hadoop+Zookeeper+HBase)
声明:作者原创,转载注明出处. 作者:帅气陈吃苹果 一.服务器环境 主机名 IP 用户名 密码 安装目录 master188 192.168.29.188 hadoop hadoop /home/ha ...
- Hadoop 3.1.2(HA)+Zookeeper3.4.13+Hbase1.4.9(HA)+Hive2.3.4+Spark2.4.0(HA)高可用集群搭建
目录 目录 1.前言 1.1.什么是 Hadoop? 1.1.1.什么是 YARN? 1.2.什么是 Zookeeper? 1.3.什么是 Hbase? 1.4.什么是 Hive 1.5.什么是 Sp ...
- centos HA高可用集群 heartbeat搭建 heartbeat测试 主上停止heartbeat服务 测试脑裂 两边都禁用ping仲裁 第三十二节课
centos HA高可用集群 heartbeat搭建 heartbeat测试 主上停止heartbeat服务 测试脑裂 两边都禁用ping仲裁 第三十二节课 heartbeat是Linu ...
- HA 高可用集群概述及其原理解析
HA 高可用集群概述及其原理解析 1. 概述 1)所谓HA(High Available),即高可用(7*24小时不中断服务). 2)实现高可用最关键的策略是消除单点故障.HA严格来说应该分成各个组件 ...
- 基于Keepalived实现LVS双主高可用集群
Reference: https://mp.weixin.qq.com/s?src=3×tamp=1512896424&ver=1&signature=L1C7us ...
- Kubeadm 1.9 HA 高可用集群本地离线镜像部署【已验证】
k8s介绍 k8s 发展速度很快,目前很多大的公司容器集群都基于该项目,如京东,腾讯,滴滴,瓜子二手车,易宝支付,北森等等. kubernetes1.9版本发布2017年12月15日,每三个月一个迭代 ...
- [K8s 1.9实践]Kubeadm 1.9 HA 高可用 集群 本地离线镜像部署
k8s介绍 k8s 发展速度很快,目前很多大的公司容器集群都基于该项目,如京东,腾讯,滴滴,瓜子二手车,北森等等. kubernetes1.9版本发布2017年12月15日,每是那三个月一个迭代, W ...
- Zookeeper(四)Hadoop HA高可用集群搭建
一.高可就集群搭建 1.集群规划 2.集群服务器准备 (1) 修改主机名(2) 修改 IP 地址(3) 添加主机名和 IP 映射(4) 同步服务器时间(5) 关闭防火墙(6) 配置免密登录(7) 安装 ...
随机推荐
- python学习之re库
正则表达式库re是非常重要的一个库. 首先正则表达式有两种表示类型,一种是raw string类型(原生字符串类型),也就是我们经常看到的r' '的写法,另一种是不带r的写法,称为string类型. ...
- openlayers空间点查询之GetFeatureInfo
在map对象上注册点击方法监听, 这里我用的是wms,当然你也可以查询wfs map.events.register('click', map, function (e) { ...
- Spring依赖
<project xmlns="http://maven.apache.org/POM/4.0.0" xmlns:xsi="http://www.w3.org/20 ...
- [从零开始搭网站六]为域名申请免费SSL证书(https),并为Tomcat配置https域名所用的多SSL证书
点击下面连接查看从零开始搭网站全系列 从零开始搭网站 由于国内的网络环境比较恶劣,运营商流量劫持的情况比较严重,一般表现为别人打开你的网站的时候会弹一些莫名其妙的广告...更过分的会跳转至别的网站. ...
- Redux基础使用
Redux基础使用: 简介:这里是从需求来响应的执行操作redux,所以理解起来更加的容易铭记在心的三点:action/reducer/store 除此之外就是react/react native的基 ...
- [HTML]js读取XML文件并解析
xml文件:test.xml <?xml version="1.0"?> <note> <to>George</to> <fr ...
- 前端实现实时通讯-----ajax长连接
因为web运行模式为请求-响应,服务端无法主动发起通讯,所以通讯实时性存在各种问题,ajax轮询可以模拟及时通讯,但连接太频繁将给服务端带来很大压力,不频繁则实时性很差. 下面介绍在web上真正实现实 ...
- 控制 datetimepicker 显示位置
1. datetimepicker 位置 pickerPosition 有以下几个属性值,望文生义不解释 $('.form_datetime').datetimepicker({ pickerPo ...
- react点滴
1.<SubSubComp {...this.props } /> 传递属性,{...props}的方式为组件传递了这两个属性,这就是JSX中的延展属性,"..."成为 ...
- Day3-scrapy爬虫下载图片自定义名称
学习Scrapy过程中发现用Scrapy下载图片时,总是以他们的URL的SHA1 hash值为文件名,如: 图片URL:http://www.example.com/image.jpg 它的SHA1 ...