
大数据系列之Kafka安装

先简单说下安装kafka的流程。。(可配置多个zookeeper,这篇文只说一个zookeeper场景)
1.环境配置:jdk1.7+ (LZ用的是jdk1.8)
2.资料准备:下载 kafka_2.10-0.10.1.1.tgz ,官网链接为https://www.apache.org/dyn/closer.cgi?path=/kafka/0.10.1.1/kafka_2.10-0.10.1.1.tgz
3.单机版安装步骤:
a.将tgz放入目录: /app/
b.解压:
tar -xzvf kafka_2.-0.10.1.1.tgz
c.修改配置:(暂时可不修改)
d.启动zookeeper:在kafka文件夹下操作命令
bin/zookeeper-server-start.sh -daemon config/zookeeper.properties &
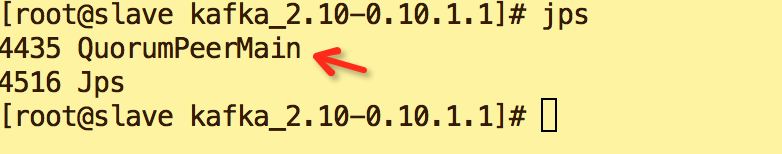
e.验证启动状态: jps,出现红色尖头部分表示启动成功
f.启动kafka
bin/kafka-server-start.sh -daemon config/server.properties &
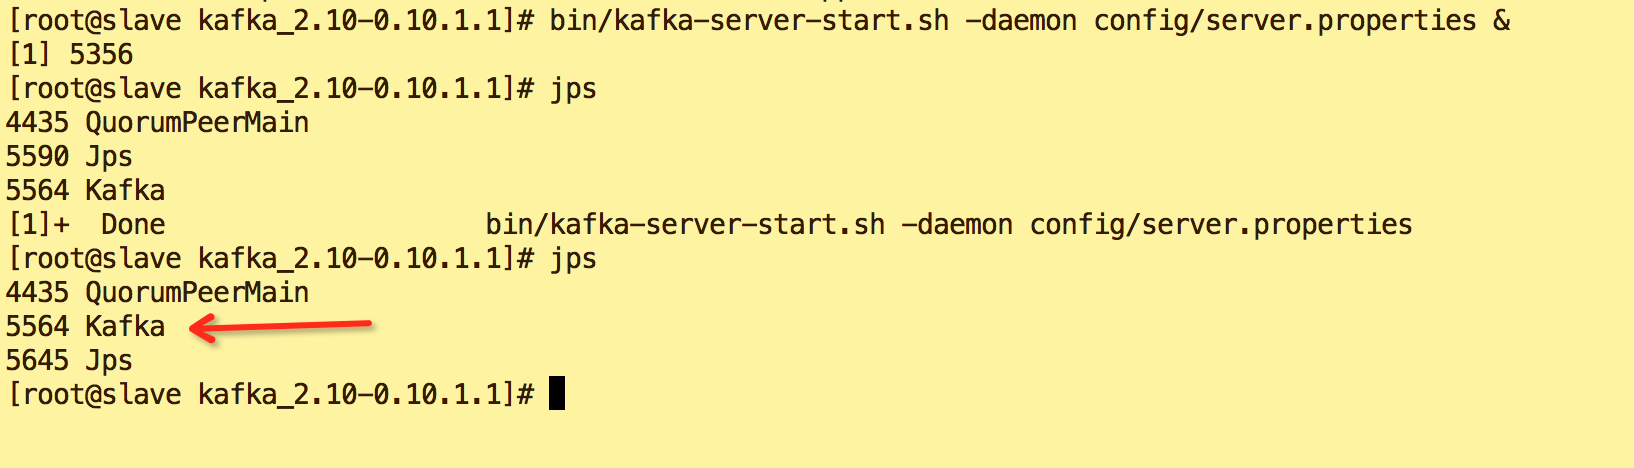
g.验证kafka启动状态: jps
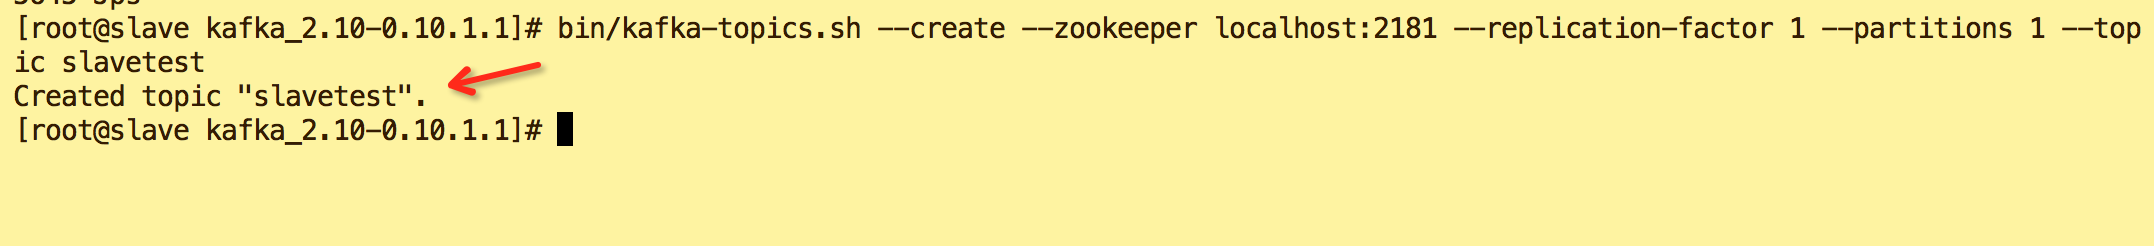
h.创建topic,名为slavetest
bin/kafka-topics.sh --create --zookeeper localhost: --replication-factor --partitions --topic slavetest
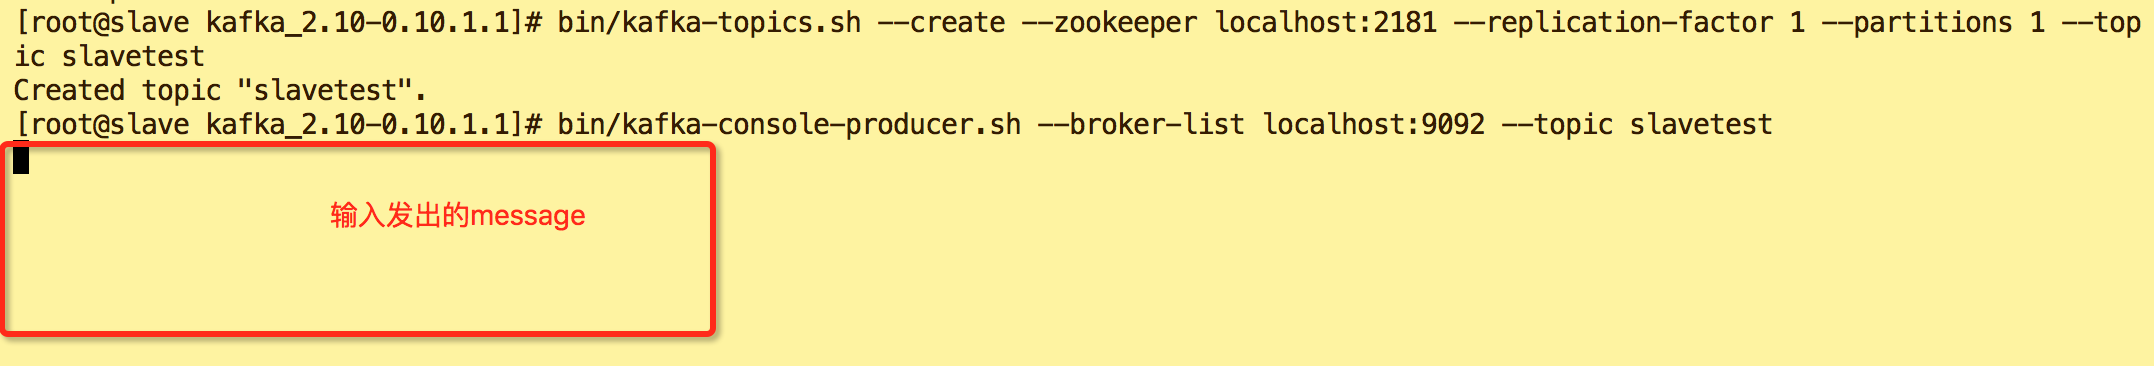
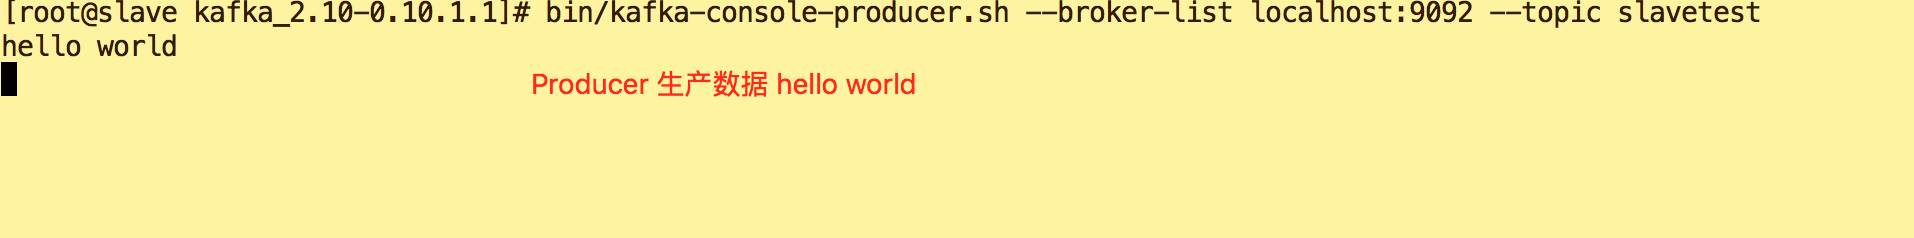
i.topic为slavetest ,生产数据
bin/kafka-console-producer.sh --broker-list localhost: --topic slavetest
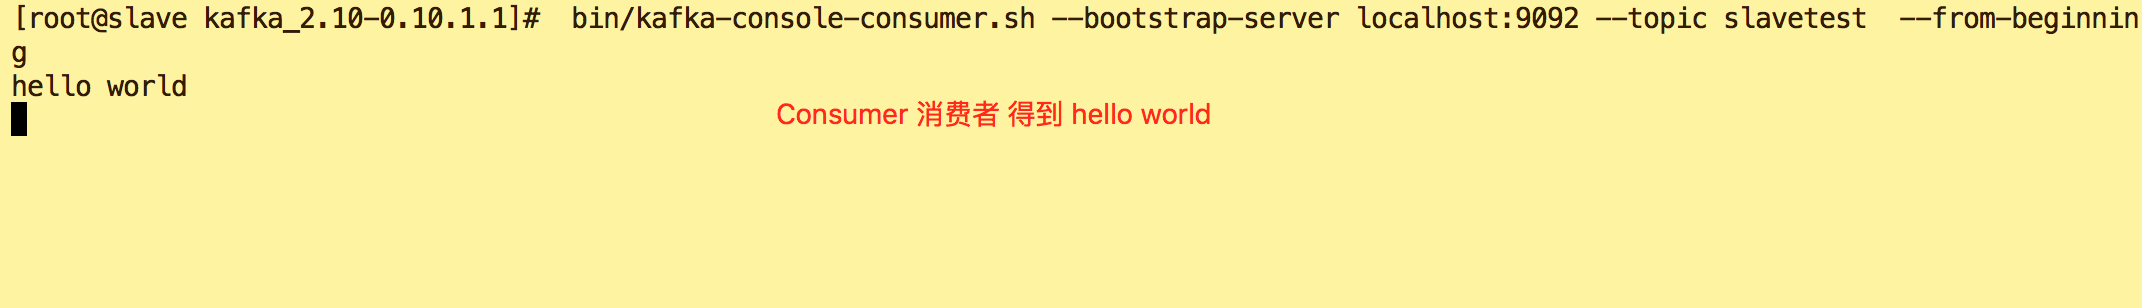
j.另打开一个终端连接操作,消费数据
bin/kafka-console-consumer.sh --bootstrap-server localhost:9092 --topic slavetest --from-beginning
k.验证(Producer-Consumer)
l.End
4.分布式版安装步骤:
与单机版不同的是在于
注意事项
1.修改配置:config/server.properties
a.master节点上
broker.id=0

zookeeper.connect=master:2181
b.slave节点上
broker.id=1

zookeeper.connect=master:2181
2.slave不启动zk,可直接启动kafka
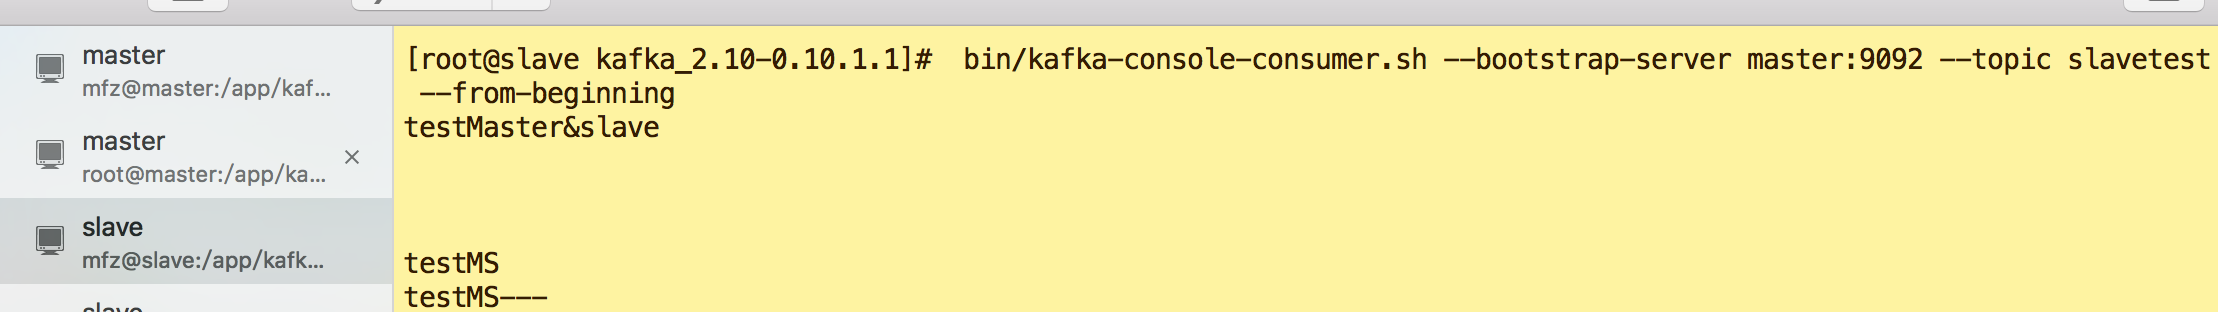
3.slave节点上开启消费命令时将localhost改为master
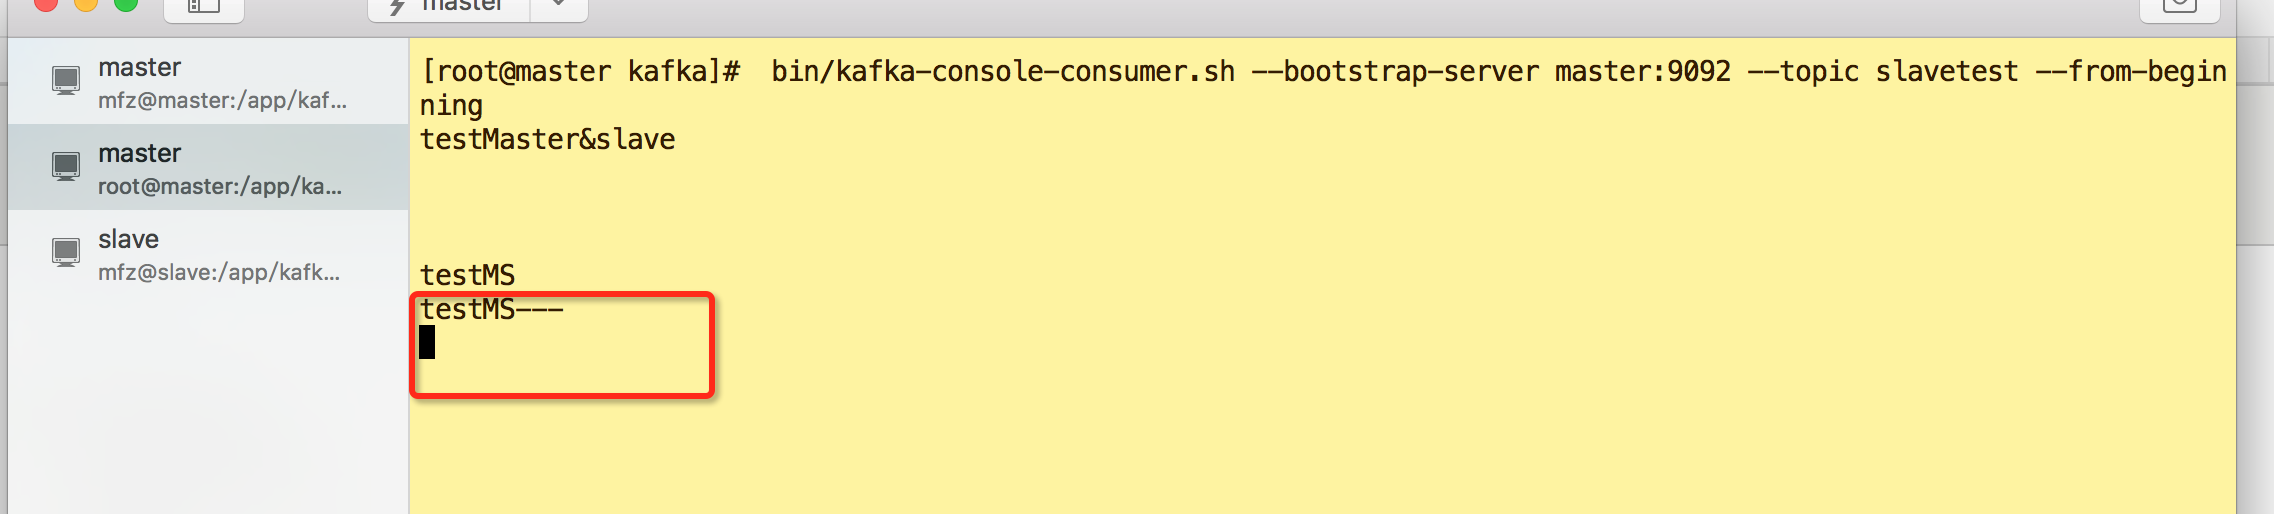
bin/kafka-console-consumer.sh --bootstrap-server master:9092 --topic slavetest --from-beginning
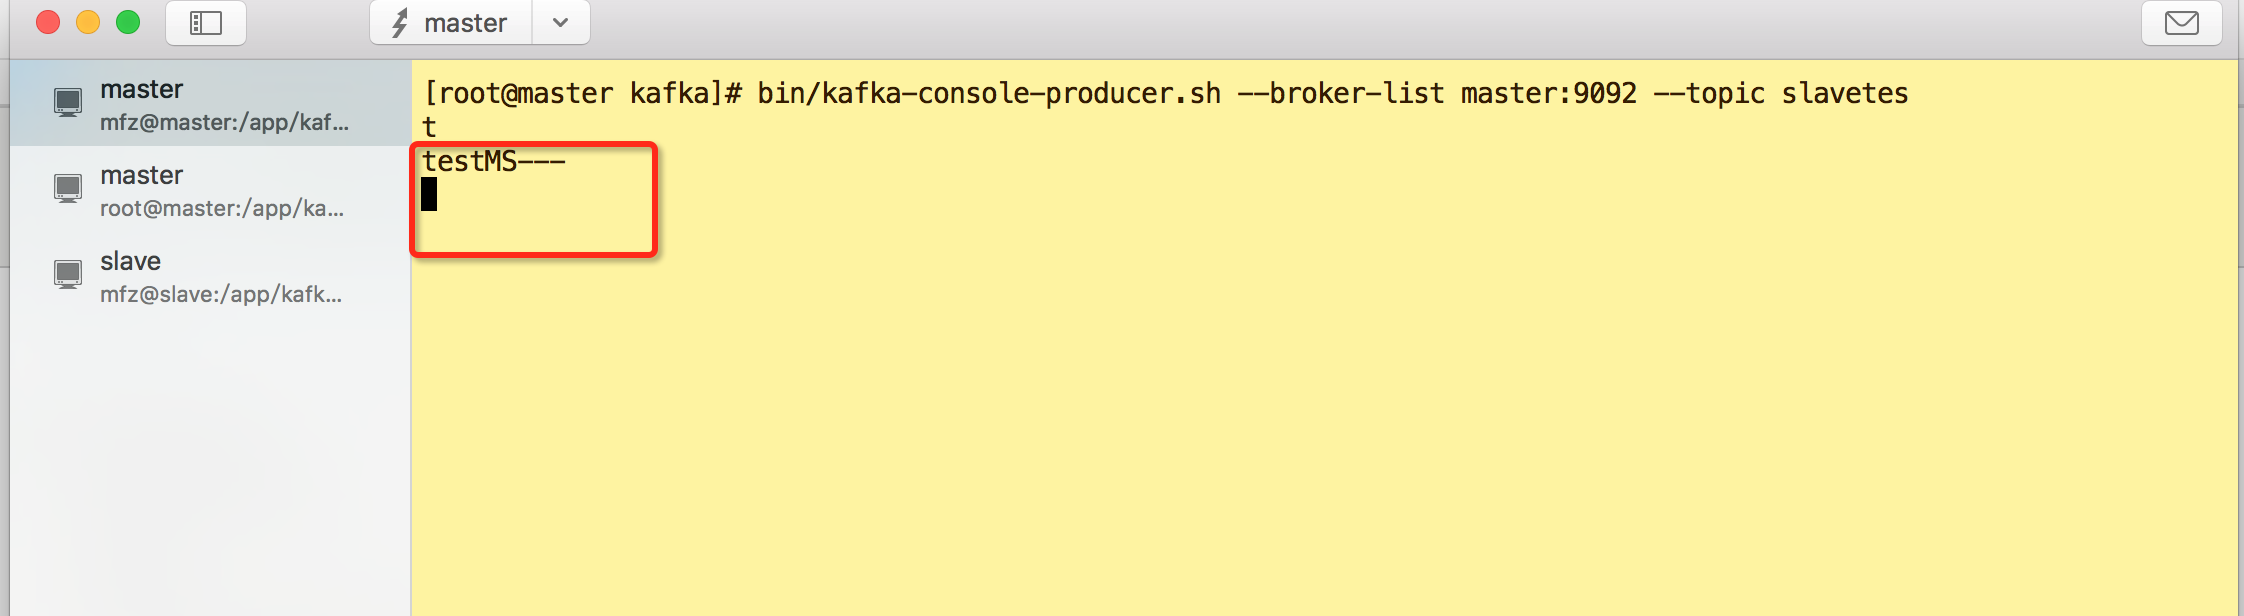
验证:
1.master 节点生产者
2.master节点上消费者
3.slave节点上消费者
大数据系列之Kafka安装的更多相关文章
- 大数据系列之kafka监控kafkaoffsetmonitor安装
1.下载kafkaoffsetmonitor的jar包,可以到github搜索kafkaoffsetmonitor,第一个就是,里面可以下载编译好了的包. KafkaOffsetMonitor-ass ...
- 【大数据系列】Hive安装及web模式管理
一.什么是Hive Hive是建立在Hadoop基础常的数据仓库基础架构,,它提供了一系列的工具,可以用了进行数据提取转化加载(ETL),这是一种可以存储.查询和分析存储在Hadoop中的按规模数据的 ...
- 【大数据系列】hive安装及启动
一.安装好jdk和hadoop 二.下载apache-hive https://mirrors.tuna.tsinghua.edu.cn/apache/hive/hive-2.3.0/ 三.解压到安装 ...
- 大数据系列之Flume+kafka 整合
相关文章: 大数据系列之Kafka安装 大数据系列之Flume--几种不同的Sources 大数据系列之Flume+HDFS 关于Flume 的 一些核心概念: 组件名称 功能介绍 Agent ...
- 12.Linux软件安装 (一步一步学习大数据系列之 Linux)
1.如何上传安装包到服务器 有三种方式: 1.1使用图形化工具,如: filezilla 如何使用FileZilla上传和下载文件 1.2使用 sftp 工具: 在 windows下使用CRT 软件 ...
- 大数据系列(5)——Hadoop集群MYSQL的安装
前言 有一段时间没写文章了,最近事情挺多的,现在咱们回归正题,经过前面四篇文章的介绍,已经通过VMware安装了Hadoop的集群环境,相关的两款软件VSFTP和SecureCRT也已经正常安装了. ...
- 大数据系列(4)——Hadoop集群VSFTP和SecureCRT安装配置
前言 经过前三篇文章的介绍,已经通过VMware安装了Hadoop的集群环境,当然,我相信安装的过程肯定遇到或多或少的问题,这些都需要自己解决,解决的过程就是学习的过程,本篇的来介绍几个Hadoop环 ...
- 大数据系列(2)——Hadoop集群坏境CentOS安装
前言 前面我们主要分析了搭建Hadoop集群所需要准备的内容和一些提前规划好的项,本篇我们主要来分析如何安装CentOS操作系统,以及一些基础的设置,闲言少叙,我们进入本篇的正题. 技术准备 VMwa ...
- 大数据系列之数据仓库Hive安装
Hive系列博文,持续更新~~~ 大数据系列之数据仓库Hive原理 大数据系列之数据仓库Hive安装 大数据系列之数据仓库Hive中分区Partition如何使用 大数据系列之数据仓库Hive命令使用 ...
随机推荐
- js 变量定义的注意点
- 【BZOJ2437】【NOI2011】兔兔与蛋蛋(博弈论,二分图匹配)
[BZOJ2437][NOI2011]兔兔与蛋蛋(博弈论,二分图匹配) 题面 BZOJ 题解 考虑一下暴力吧. 对于每个状态,无非就是要考虑它是否是必胜状态 这个直接用\(dfs\)爆搜即可. 这样子 ...
- Last Position of Target
For a given sorted array (ascending order) and a target number, find the first index of this number ...
- linux服务之NTP时间服务器
1. NTP简介 NTP(Network Time Protocol,网络时间协议)是用来使网络中的各个计算机时间同步的一种协议.它的用途是把计算机的时钟同步到世界协调时UTC,其精度在局域网内可达0 ...
- kotlin Hello World 以及关键字
hello world:(支持函数式编程,不需要放到 class 中) fun main(args: Array<String>) { println("Hello World& ...
- u3d摄像机截图
using System; using UnityEngine; using System.Collections; public class TestCamreaCapture1 : MonoBeh ...
- 从一个集合中过滤另一个集合中存在的项(类似in)
直接贴代码出来: List<PriceMark> list = PriceMarkDAL.m_PriceMarkDAL.GetList("Erp_ProName='TLC7528 ...
- mysql数据库使用sql命令窗口查询的数据,改成sql语句导入到mysql数据库中
1.查询语句为select * from t_table;导出的数据格式如下: 2.将数据文本备份,然后使用NOTEPAD++打开,然后只拷贝数据到新建txt中,然后进行如下替换: 1)将“ | ”分 ...
- 计算方法 -- 解线性方程组直接法(LU分解、列主元高斯消元、追赶法)
#include <iostream> #include <cstdio> #include <algorithm> #include <cstdlib> ...
- Anniversary party(树形dp入门)
Anniversary party Time Limit: 2000/1000 MS (Java/Others) Memory Limit: 65536/32768 K (Java/Others ...