
网络爬虫: 从allitebooks.com抓取书籍信息并从amazon.com抓取价格(3): 抓取amazon.com价格
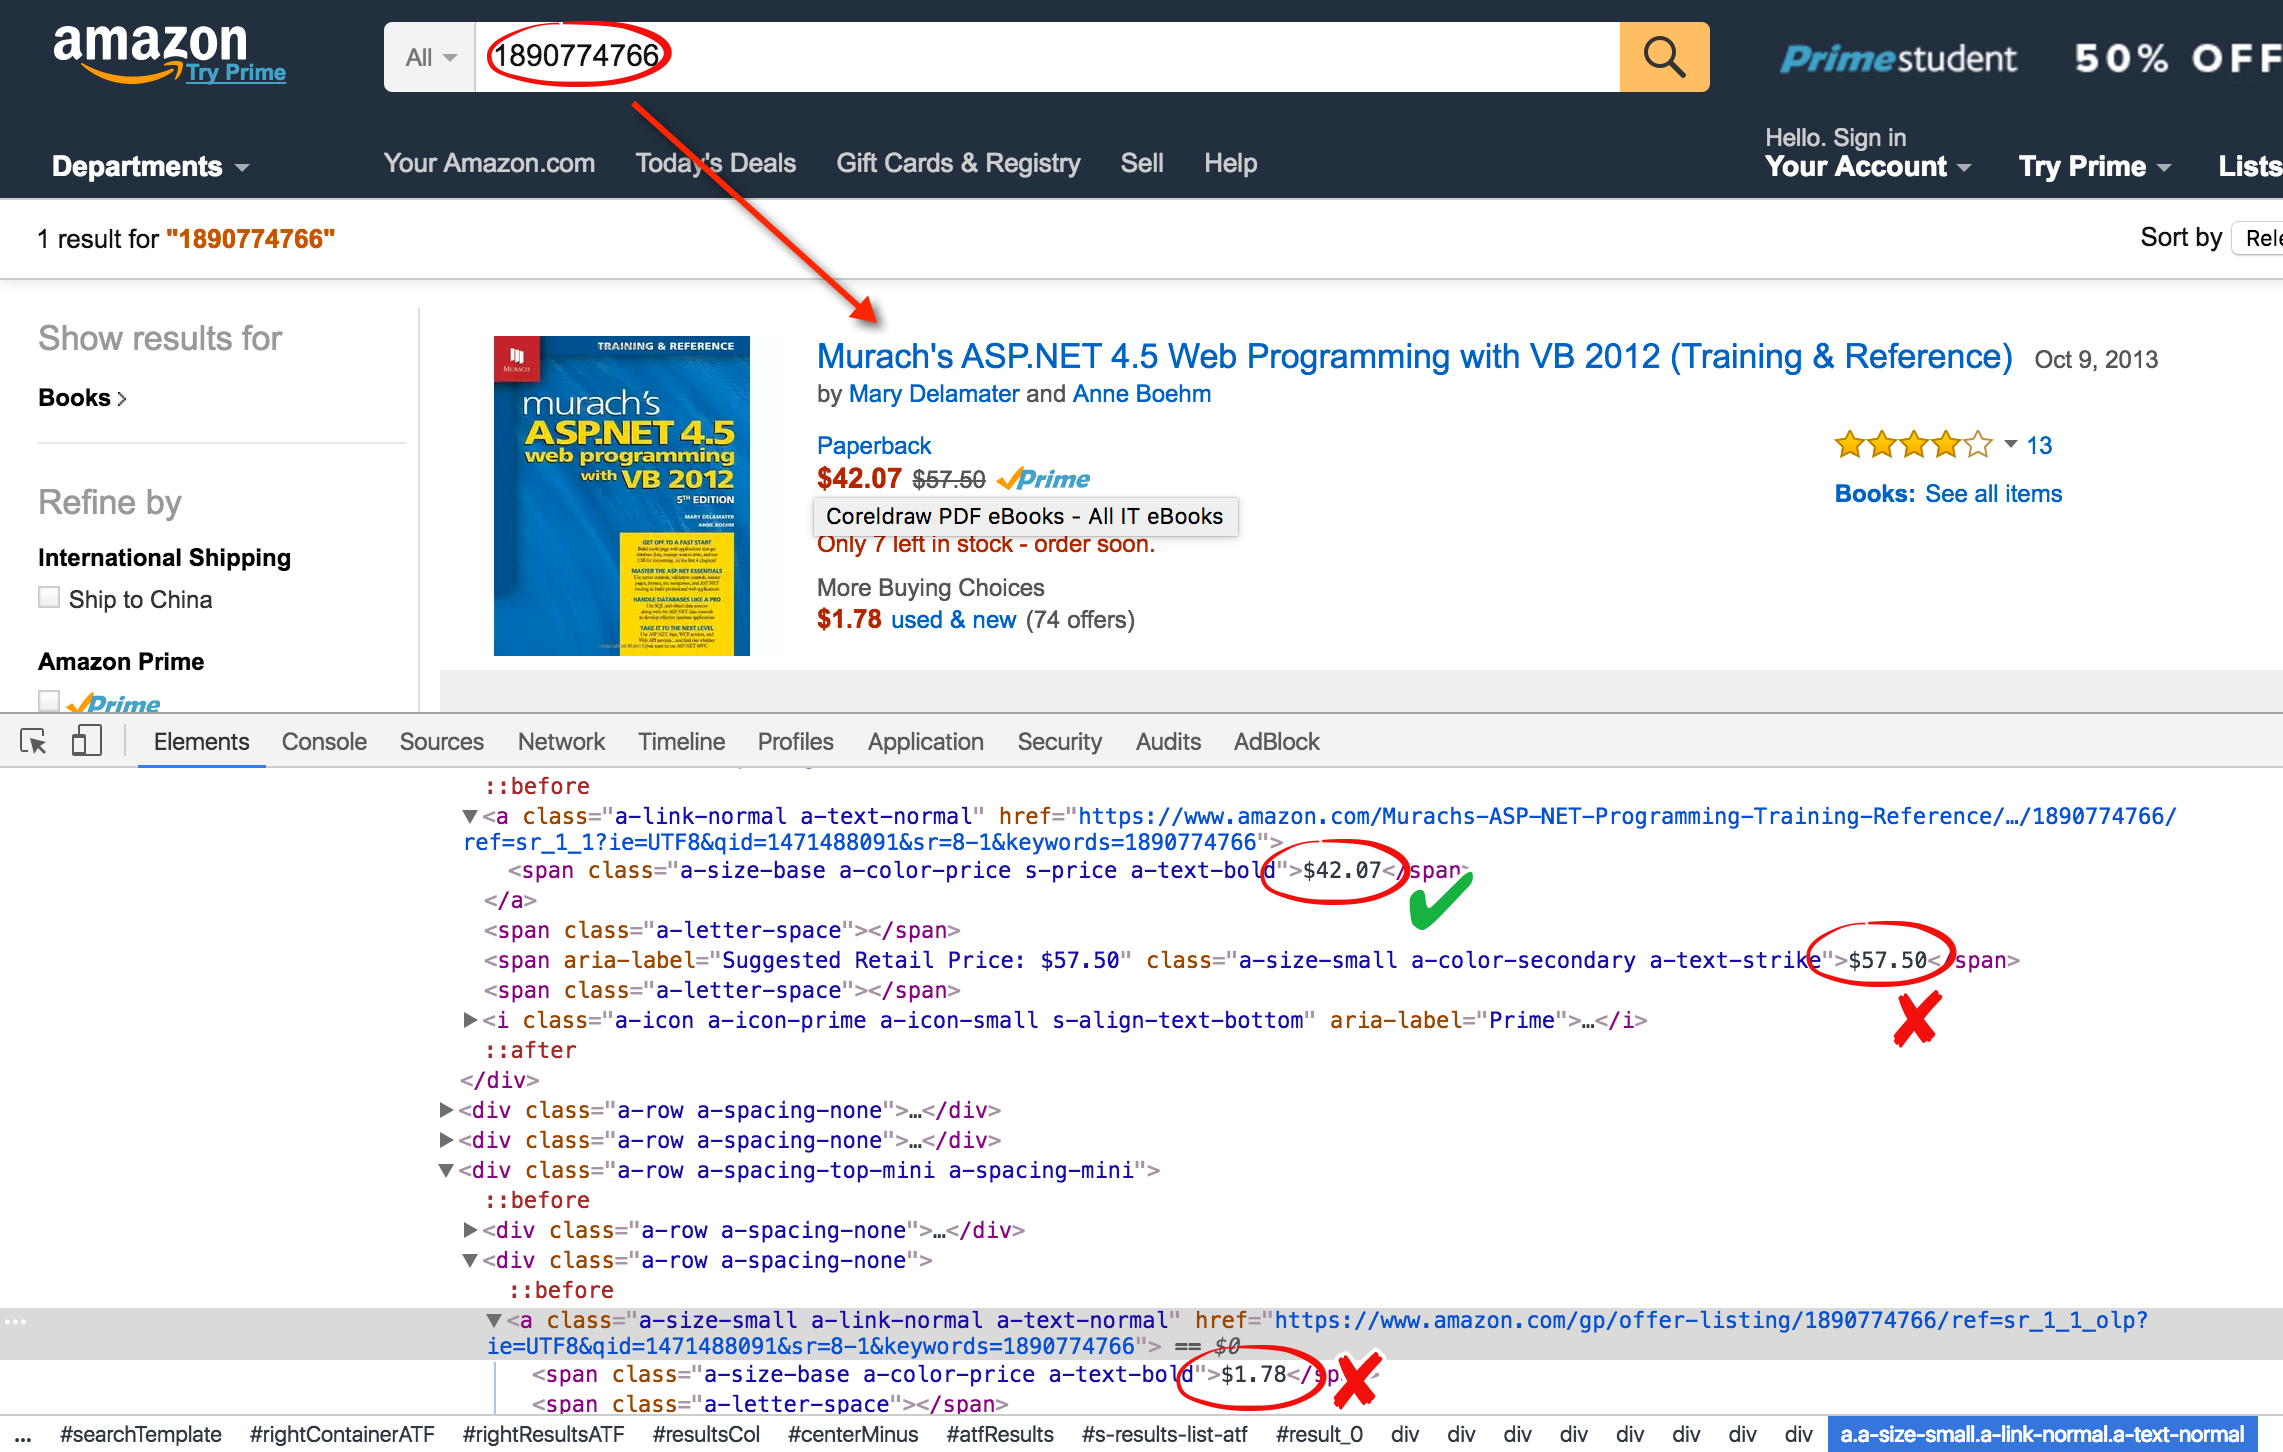
接下来将通过ISBN码去amazon.com获取每本书对应的价格。
一、了解需要和分析网站
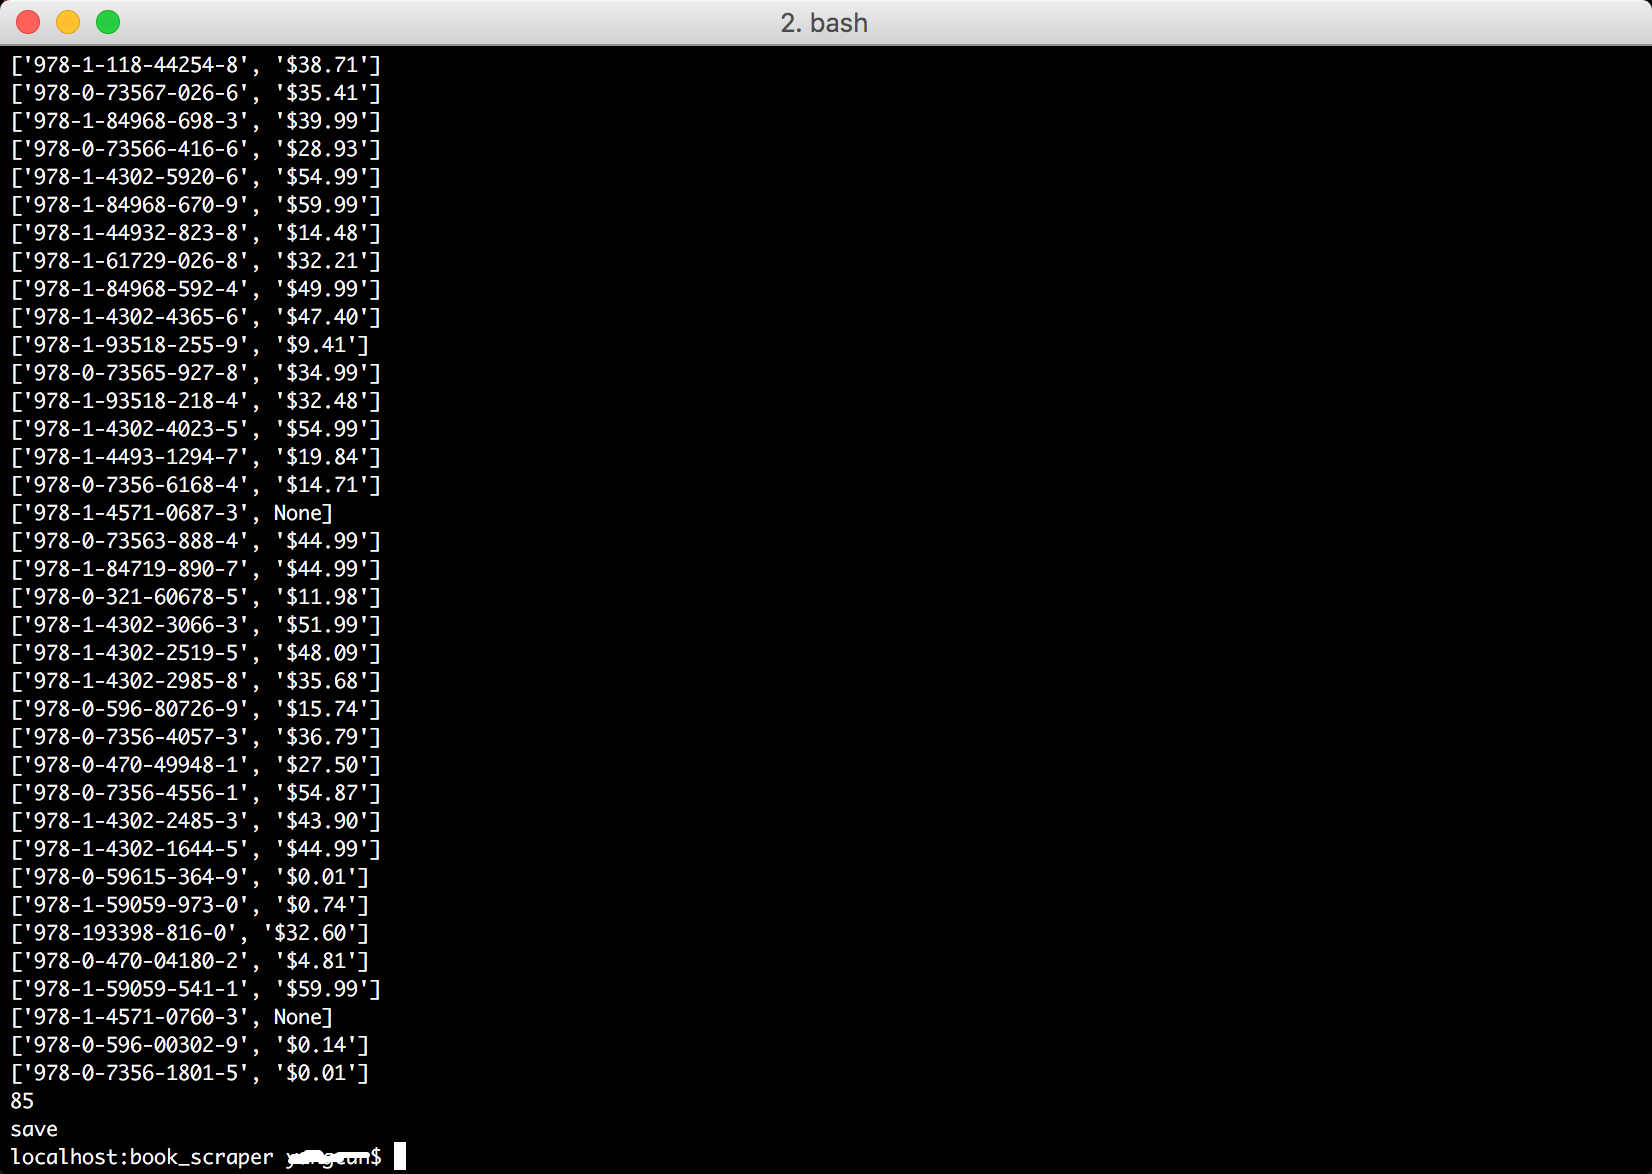
def get_price_amazon(isbn):

    base_url = "https://www.amazon.com/s/ref=nb_sb_noss?url=search-alias%3Daps&field-keywords="

    url = base_url + str(isbn)

    page = urlopen(url)

    soup = BeautifulSoup(page, 'lxml')

    page.close()

    price_regexp = re.compile("\$[0-9]+(\.[0-9]{2})?")

    price = soup.find(text=price_regexp)

    return [isbn, price]
二、将两部分结果数据合并
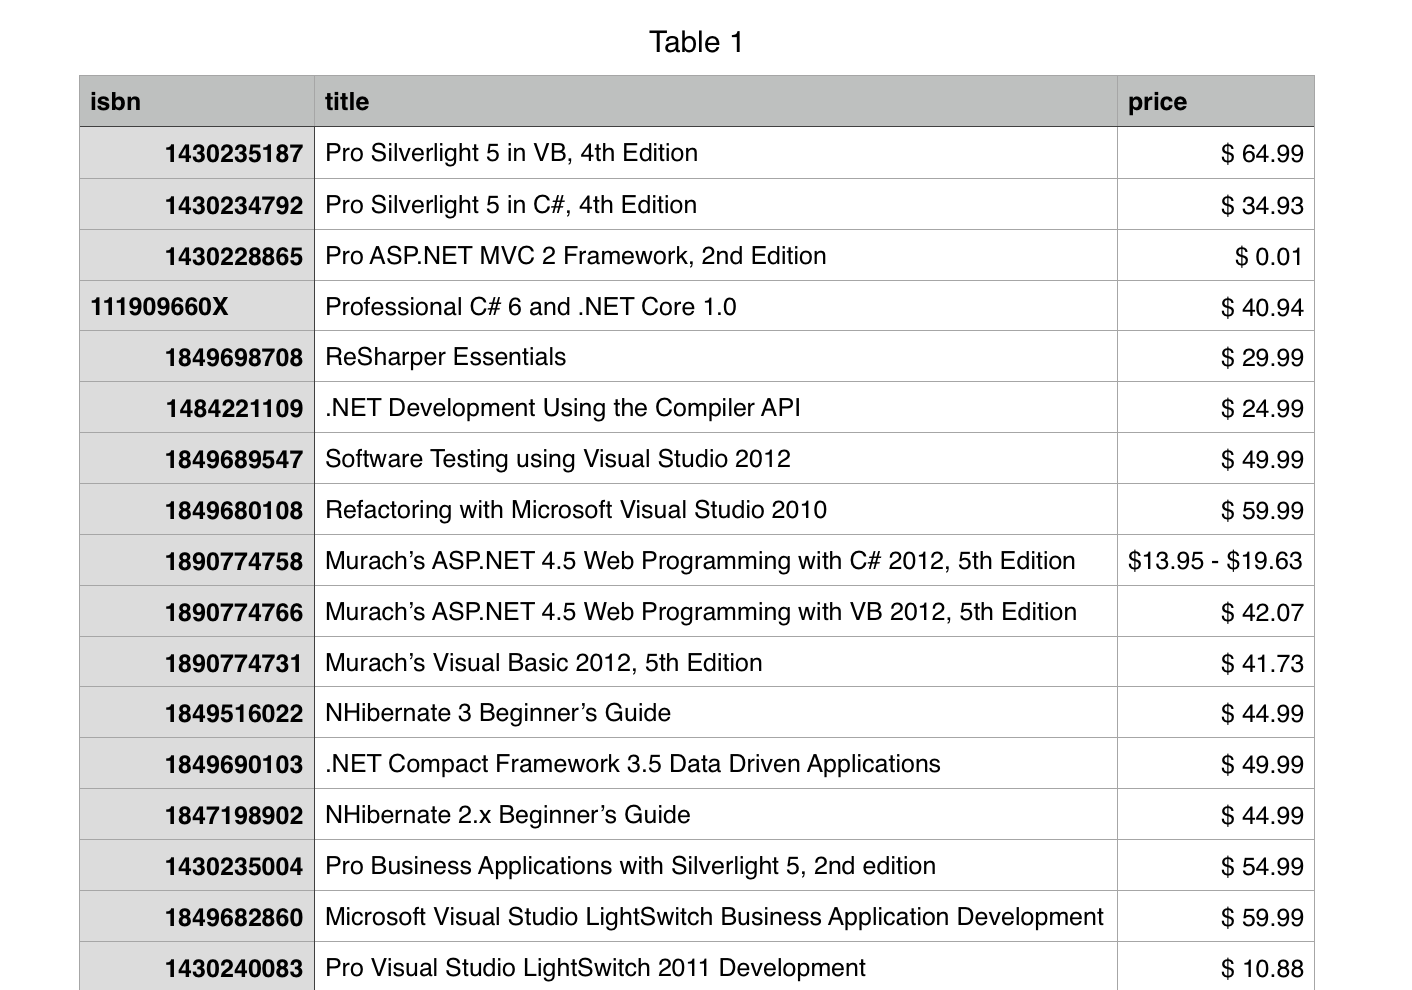
book_info_data = pd.read_csv('books.csv')

price_data = pd.read_csv('prices.csv')

result = pd.merge(book_info_data, price_data, on='isbn')

result.to_csv('result.csv', index=False, header=True, columns=['isbn', 'title', 'price'])
大数据,大数据分析、BeautifulSoup,Beautiful Soup入门,数据挖掘,数据分析,数据处理,pandas,网络爬虫,web scraper,python excel,python写入excel数据,python处理csv文件 python操作Excel,excel读写 通过上一篇随笔的处理,我们已经拿到了书的书名和ISBN码。(网络爬虫: 从allitebooks.com抓取书籍信息并从amazon.com抓取价格(2): 抓取allitebooks.com书籍信息及ISBN码)
接下来将通过ISBN码去amazon.com获取每本书对应的价格。
一、了解需要和分析网站
通过分析amazon.com得知,以ISBN码作为搜索关键字可查找到对应的书。
结果页码就有这本书的价格,既然价格是以$符号开头,那就可以通过正则表达式得到价格。通过上一篇随笔的处理,我们已经拿到了书的书名和ISBN码。(网络爬虫: 从allitebooks.com抓取书籍信息并从amazon.com抓取价格(2): 抓取allitebooks.com书籍信息及ISBN码)
接下来将通过ISBN码去amazon.com获取每本书对应的价格。
一、了解需要和分析网站
通过分析amazon.com得知,以ISBN码作为搜索关键字可查找到对应的书。
结果页码就有这本书的价格,既然价格是以$符号开头,那就可以通过正则表达式得到价格。通过上一篇随笔的处理,我们已经拿到了书的书名和ISBN码。(网络爬虫: 从allitebooks.com抓取书籍信息并从amazon.com抓取价格(2): 抓取allitebooks.com书籍信息及ISBN码)
接下来将通过ISBN码去amazon.com获取每本书对应的价格。
一、了解需要和分析网站
通过分析amazon.com得知,以ISBN码作为搜索关键字可查找到对应的书。
结果页码就有这本书的价格,既然价格是以$符号开头,那就可以通过正则表达式得到价格。通过上一篇随笔的处理,我们已经拿到了书的书名和ISBN码。(网络爬虫: 从allitebooks.com抓取书籍信息并从amazon.com抓取价格(2): 抓取allitebooks.com书籍信息及ISBN码)
接下来将通过ISBN码去amazon.com获取每本书对应的价格。
一、了解需要和分析网站
通过分析amazon.com得知,以ISBN码作为搜索关键字可查找到对应的书。
结果页码就有这本书的价格,既然价格是以$符号开头,那就可以通过正则表达式得到价格。通过上一篇随笔的处理,我们已经拿到了书的书名和ISBN码。(网络爬虫: 从allitebooks.com抓取书籍信息并从amazon.com抓取价格(2): 抓取allitebooks.com书籍信息及ISBN码)
接下来将通过ISBN码去amazon.com获取每本书对应的价格。
一、了解需要和分析网站
通过分析amazon.com得知,以ISBN码作为搜索关键字可查找到对应的书。
结果页码就有这本书的价格,既然价格是以$符号开头,那就可以通过正则表达式得到价格。通过上一篇随笔的处理,我们已经拿到了书的书名和ISBN码。(网络爬虫: 从allitebooks.com抓取书籍信息并从amazon.com抓取价格(2): 抓取allitebooks.com书籍信息及ISBN码)
接下来将通过ISBN码去amazon.com获取每本书对应的价格。
一、了解需要和分析网站
通过分析amazon.com得知,以ISBN码作为搜索关键字可查找到对应的书。
结果页码就有这本书的价格,既然价格是以$符号开头,那就可以通过正则表达式得到价格。
网络爬虫: 从allitebooks.com抓取书籍信息并从amazon.com抓取价格(3): 抓取amazon.com价格的更多相关文章
- 网络爬虫: 从allitebooks.com抓取书籍信息并从amazon.com抓取价格(2): 抓取allitebooks.com书籍信息及ISBN码
这一篇首先从allitebooks.com里抓取书籍列表的书籍信息和每本书对应的ISBN码. 一.分析需求和网站结构 allitebooks.com这个网站的结构很简单,分页+书籍列表+书籍详情页. ...
- Python 3网络爬虫开发实战中文PDF+源代码+书籍软件包(免费赠送)+崔庆才
Python 3网络爬虫开发实战中文PDF+源代码+书籍软件包+崔庆才 下载: 链接:https://pan.baidu.com/s/1H-VrvrT7wE9-CW2Dy2p0qA 提取码:35go ...
- Python简单网络爬虫实战—下载论文名称,作者信息(下)
在Python简单网络爬虫实战—下载论文名称,作者信息(上)中,学会了get到网页内容以及在谷歌浏览器找到了需要提取的内容的数据结构,接下来记录我是如何找到所有author和title的 1.从sou ...
- 网络爬虫: 从allitebooks.com抓取书籍信息并从amazon.com抓取价格(1): 基础知识Beautiful Soup
开始学习网络数据挖掘方面的知识,首先从Beautiful Soup入手(Beautiful Soup是一个Python库,功能是从HTML和XML中解析数据),打算以三篇博文纪录学习Beautiful ...
- 网络爬虫:使用Scrapy框架编写一个抓取书籍信息的爬虫服务
上周学习了BeautifulSoup的基础知识并用它完成了一个网络爬虫( 使用Beautiful Soup编写一个爬虫 系列随笔汇总 ), BeautifulSoup是一个非常流行的Python网 ...
- java之网络爬虫介绍
文章大纲 一.网络爬虫基本介绍二.java常见爬虫框架介绍三.WebCollector实战四.项目源码下载五.参考文章 一.网络爬虫基本介绍 1. 什么是网络爬虫 网络爬虫(又被称为网页蜘蛛, ...
- Java网络爬虫 HttpClient
简介 : HttpClient是Apache Jakarta Common下的子项目,用于提供高效的,功能丰富的支持HTTP协议的客户编程工具包,其主要功能如下: 实现了所有HTTP的方法 : GET ...
- 《精通Python网络爬虫》|百度网盘免费下载|Python爬虫实战
<精通Python网络爬虫>|百度网盘免费下载|Python爬虫实战 提取码:7wr5 内容简介 为什么写这本书 网络爬虫其实很早就出现了,最开始网络爬虫主要应用在各种搜索引擎中.在搜索引 ...
- Day01_WebCrawler(网络爬虫)
学于黑马和传智播客联合做的教学项目 感谢 黑马官网 传智播客官网 微信搜索"艺术行者",关注并回复关键词"webcrawler"获取视频和教程资料! b站在线视 ...
随机推荐
- JavaScript Array对象
介绍Js的Array 数组对象. 目录 1. 介绍:介绍 Array 数组对象的说明.定义方式以及属性. 2. 实例方法:介绍 Array 对象的实例方法:concat.every.filter.fo ...
- IIC驱动移植在linux3.14.78上的实现和在linux2.6.29上实现对比(deep dive)
首先说明下为什么写这篇文章,网上有许多博客也是介绍I2C驱动在linux上移植的实现,但是笔者认为他们相当一部分没有分清所写的驱动时的驱动模型,是基于device tree, 还是基于传统的Platf ...
- SAP CRM 用户界面对象类型和设计对象
在CRM中的用户界面对象类型的帮助下,我们可以做这些工作: 进行不同的视图配置 创建动态导航 从设计层控制字段标签.值帮助 控制BOL对象的属性的可视性 从导航栏访问自定义组件 一个用户界面对象类型之 ...
- Kotlin类:功能更强、而更简洁(KAD 03)
作者:Antonio Leiva 时间:Dec 7, 2016 原文链接:http://antonioleiva.com/classes-kotlin/ Kotlin类尽可能简单,这样用较少的代码完成 ...
- MySQL Workbench建表时 PK NN UQ BIN UN ZF AI 的含义
[转自网络]https://my.oschina.net/cers/blog/292191 PK Belongs to primary key 作为主键 NN Not Null 非空 UQ Uniqu ...
- mysql 赋予用户权限
# 赋予权限MySQL> grant 权限参数 on 数据库名称.表名称 to 用户名@用户地址 identified by '用户密码'; # 立即生效权限MySQL> flush pr ...
- Linux基础介绍【第六篇】
定时任务crond介绍 crond是什么? crond是linux系统中用来定期执行命令或指定程序任务的一种服务或软件.一般情况下,安装完CentOS5/6 linux操作系统之后,默认便会启动cro ...
- php+websocket搭建简易聊天室实践
1.前言 公司游戏里面有个简单的聊天室,了解了之后才知道是node+websocket做的,想想php也来做个简单的聊天室.于是搜集各种资料看文档.找实例自己也写了个简单的聊天室. http连接分为短 ...
- 简单Linux命令学习笔记
1.查看进程 ps -ef | grep 关键字 /*关键字为服务名*/ netstat -unltp | grep 关键字 /*关键字为服务名或者是端口均可*/ 2.杀死进 ...
- closure
什么是闭包?百度的答案: 闭包是指可以包含自由(未绑定到特定对象)变量的代码块:这些变量不是在这个代码块内或者任何全局上下文中定义的,而是在定义代码块的环境中定义(局部变量)."闭包&quo ...