
HanLP中文分词Lucene插件
基于HanLP,支持包括Solr(7.x)在内的任何基于Lucene(7.x)的系统。
Maven
<dependency>
<groupId>com.hankcs.nlp</groupId>
<artifactId>hanlp-lucene-plugin</artifactId>
<version>1.1.6</version>
</dependency>
Solr快速上手
1.将hanlp-portable.jar和hanlp-lucene-plugin.jar共两个jar放入${webapp}/WEB-INF/lib下。(或者使用mvn package对源码打包,拷贝target/hanlp-lucene-plugin-x.x.x.jar到${webapp}/WEB-INF/lib下)
2. 修改solr core的配置文件${core}/conf/schema.xml:
<fieldType name="text_cn" class="solr.TextField">
<analyzer type="index">
<tokenizer class="com.hankcs.lucene.HanLPTokenizerFactory" enableIndexMode="true"/>
</analyzer>
<analyzer type="query">
<!-- 切记不要在query中开启index模式 -->
<tokenizer class="com.hankcs.lucene.HanLPTokenizerFactory" enableIndexMode="false"/>
</analyzer>
</fieldType>
<!-- 业务系统中需要分词的字段都需要指定type为text_cn -->
<field name="my_field1" type="text_cn" indexed="true" stored="true"/>
<field name="my_field2" type="text_cn" indexed="true" stored="true"/>
· 如果你的业务系统中有其他字段,比如location,summary之类,也需要一一指定其type="text_cn"。切记,否则这些字段仍旧是solr默认分词器。
· 另外,切记不要在query中开启indexMode,否则会影响PhaseQuery。indexMode只需在index中开启一遍即可。
高级配置
目前本插件支持如下基于schema.xml的配置:
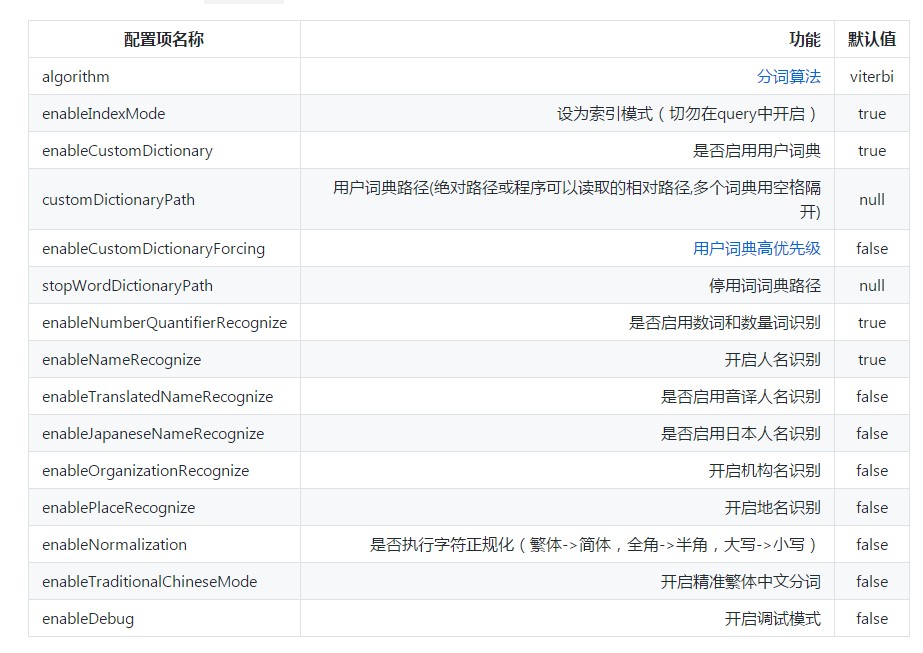
更高级的配置主要通过class path下的hanlp.properties进行配置,请阅读HanLP自然语言处理包文档以了解更多相关配置,如:
0.用户词典
1.词性标注
2.简繁转换
3.……
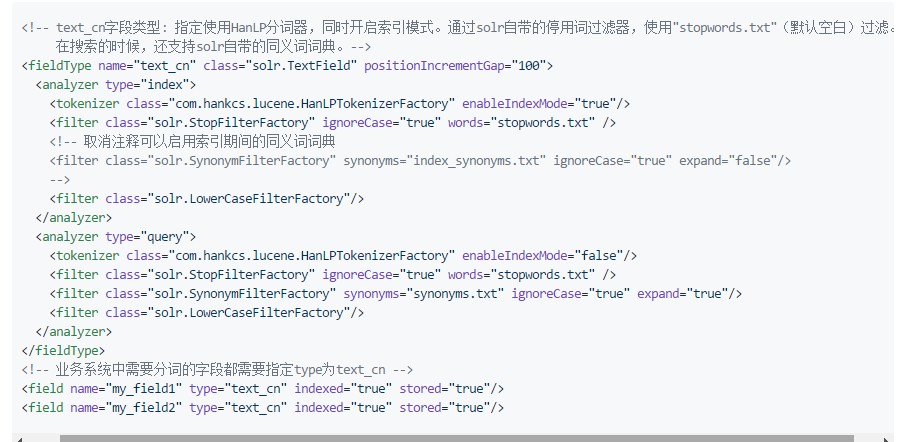
停用词与同义词
推荐利用Lucene或Solr自带的filter实现,本插件不会越俎代庖。 一个示例配置如下:
调用方法
在Query改写的时候,可以利用HanLPAnalyzer分词结果中的词性等属性,如
String text = "中华人民共和国很辽阔";
for (int i = 0; i < text.length(); ++i)
{
System.out.print(text.charAt(i) + "" + i + " ");
}
System.out.println();
Analyzer analyzer = new HanLPAnalyzer();
TokenStream tokenStream = analyzer.tokenStream("field", text);
tokenStream.reset();
while (tokenStream.incrementToken())
{
CharTermAttribute attribute = tokenStream.getAttribute(CharTermAttribute.class);
// 偏移量
OffsetAttribute offsetAtt = tokenStream.getAttribute(OffsetAttribute.class);
// 距离
PositionIncrementAttribute positionAttr = tokenStream.getAttribute(PositionIncrementAttribute.class);
// 词性
TypeAttribute typeAttr = tokenStream.getAttribute(TypeAttribute.class);
System.out.printf("[%d:%d %d] %s/%s\n", offsetAtt.startOffset(), offsetAtt.endOffset(), positionAttr.getPositionIncrement(), attribute, typeAttr.type());
}
在另一些场景,支持以自定义的分词器(比如开启了命名实体识别的分词器、繁体中文分词器、CRF分词器等)构造HanLPTokenizer,比如:
tokenizer = new HanLPTokenizer(HanLP.newSegment()
.enableJapaneseNameRecognize(true)
.enableIndexMode(true), null, false);
tokenizer.setReader(new StringReader("林志玲亮相网友:确定不是波多野结衣?"));
文章摘自:2019 github
HanLP中文分词Lucene插件的更多相关文章
- 全文检索Solr集成HanLP中文分词
以前发布过HanLP的Lucene插件,后来很多人跟我说其实Solr更流行(反正我是觉得既然Solr是Lucene的子项目,那么稍微改改配置就能支持Solr),于是就抽空做了个Solr插件出来,开源在 ...
- 全文检索Solr集成HanLP中文分词【转】
以前发布过HanLP的Lucene插件,后来很多人跟我说其实Solr更流行(反正我是觉得既然Solr是Lucene的子项目,那么稍微改改配置就能支持Solr),于是就抽空做了个Solr插件出来,开源在 ...
- Elasticsearch:hanlp 中文分词器
HanLP 中文分词器是一个开源的分词器,是专为Elasticsearch而设计的.它是基于HanLP,并提供了HanLP中大部分的分词方式.它的源码位于: https://github.com/Ke ...
- 【自定义IK词典】Elasticsearch之中文分词器插件es-ik的自定义词库
Elasticsearch之中文分词器插件es-ik 针对一些特殊的词语在分词的时候也需要能够识别 有人会问,那么,例如: 如果我想根据自己的本家姓氏来查询,如zhouls,姓氏“周”. 如 ...
- Elasticsearch之中文分词器插件es-ik(博主推荐)
前提 什么是倒排索引? Elasticsearch之分词器的作用 Elasticsearch之分词器的工作流程 Elasticsearch之停用词 Elasticsearch之中文分词器 Elasti ...
- Elasticsearch之中文分词器插件es-ik的自定义热更新词库
不多说,直接上干货! 欢迎大家,关注微信扫码并加入我的4个微信公众号: 大数据躺过的坑 Java从入门到架构师 人工智能躺过的坑 Java全栈大联盟 ...
- elasticsearch安装中文分词器插件smartcn
原文:http://blog.java1234.com/blog/articles/373.html elasticsearch安装中文分词器插件smartcn elasticsearch默认分词器比 ...
- lucene6+HanLP中文分词
1.前言 前一阵把博客换了个模版,模版提供了一个搜索按钮,这让我想起一直以来都想折腾的全文搜索技术,于是就用lucene6.2.1加上HanLP的分词插件做了这么一个模块CSearch.效果看这里:h ...
- 搜索引擎ElasticSearch系列(五): ElasticSearch2.4.4 IK中文分词器插件安装
一:IK分词器简介 IK Analyzer是一个开源的,基于java语言开发的轻量级的中文分词工具包.从2006年12月推出1.0版开始, IKAnalyzer已经推出了4个大版本.最初,它是以开源 ...
随机推荐
- 区间dp之四边形不等式优化详解及证明
看了那么久的四边形不等式优化的原理,今天终于要写一篇关于它的证明了. 在平时的做题中,我们会遇到这样的区间dp问题 它的状态转移方程形式一般为dp[i][j]=min(dp[i][k]+dp[k+1] ...
- wps实现自动编码
1.打开wps,点击“开始”菜单,选择“标题1”样式,右键选择“修改样式” 2.在修改样式界面,左键点击“格式”选择“编号”选项 3.在打开的界面选择“多级编码”,选中一个样式,点击“自定义”按钮 4 ...
- Unity more efficient find
Unity caches GameObjects based on their tags, so in a big scene with lots of objects, GameObject.Fin ...
- nginx——优化 Nginx 连接超时时间
1. 什么是连接超时 (1) 举个例子,某饭店请了服务员招待顾客,但是现在饭店不景气,因此要解雇掉一些服务员,这里的服务员就相当于 Nginx 服务建立的连接 (2) 当服务器建立的连接没有接收处理请 ...
- 基于Zynq的GNULinux在线编译调试记录
--20171228 1.实验环境 硬件环境:联想ThinkPad E430(内存加到10G).显示屏×2.VGA线×1.HDMI线×1 .鼠标×2.键盘×1.USB分线器×1.ZedBoard开发板 ...
- 编译原理子cygwin的使用
目的:熟悉cygwin环境的使用,学习使用lex写简单的词法分析程序,会在cygwin环境下使用flex调试lex写的程序 内容:使用cygwin下的flex工具将exam1.l和exam2.l编译并 ...
- 编辑器测试-TinyMCE
一级标签 二级便签 引用段落1231456456 普通段落 链接 简书 https://www.jianshu.com/p/edee77363855 import pygame WINWIDTH = ...
- 十分钟搞定 pandas
原文:http://pandas.pydata.org/pandas-docs/stable/10min.html 译者:ChaoSimple 校对:飞龙 官方网站上<10 Minutes to ...
- Knut重排算法
/// <summary> /// 这是Knut重排算法的实现 /// </summary> /// <param name="number"> ...
- Python基础学习总结(持续更新)
https://www.cnblogs.com/jin-xin/articles/7459977.html 嗯,学完一天,白天上班,眼睛要瞎了= = DAY1 1,计算机基础. CPU:相当于人的大脑 ...