
2003031120—廖威—Python数据分析五一假期作业
| 项目 | 要求 |
| 课程班级博客链接 | 20级数据班(本) |
| 这个作业要求链接 | Python数据分析五一假期作业 |
| 博客名称 | 2003031120—廖威—Python数据分析五一假期作业 |
| 要求 | 每道题要有题目,代码(使用插入代码,不会插入代码的自己查资料解决,不要直接截图代码!!),截图(只截运行结果)。 |
一、分析1996~2015年人口数据特征间的关系(1题50分,共50分)
考查知识点:掌握pyplot常用的绘图参数的调节方法;掌握子图的绘制方法;掌握绘制图形的保存与展示方法;掌握散点图和折线图的作用与绘制方法。
需求说明:
人口数据总共拥有6个特征,分别为年末总人口、男性人口、女性人口、城镇人口、乡村人口和年份。查看各个特征随着时间推移发生的变化情况可以分析出未来男女人口比例、城乡人口变化的方向。
截图如下:
要求:
(1)使用NumPy库读取人口数据。
(2)创建画布,并添加子图。
(3)在两个子图上分别绘制散点图和折线图。
(4)保存,显示图片。
(5)分析未来人口变化趋势
代码:
#导入模块

import numpy as np

import matplotlib.pyplot as plt

#使⽤numpy库读取⼈⼝数据

data=np.load("D:/Users/ASUS/Desktop/populations.npz",allow_pickle=True)#读取文件,返回输入数组

print(data.files)#查看⽂件中的数组

print(data['data'])

print(data['feature_names'])

plt.rcParams['font.sans-serif'] = 'SimHei' # 设置中文显示

plt.rcParams['axes.unicode_minus'] = False# 防止字符无法显示

name=data['feature_names']#提取其中的feature_names数组,视为数据的标签

values=data['data']#提取其中的data数组,视为数据的存在位置

#设置画布

p1=plt.figure(figsize=(12,12))#确定画布⼤⼩

pip1=p1.add_subplot(2,1,1)#创建⼀个两⾏⼀列的⼦图并开始绘制

#在⼦图上绘制散点图

plt.scatter(values[0:20,0],values[0:20,1])#,marker='8',color='red'

plt.ylabel('总人口(万⼈)')

plt.legend('年末')

plt.title('1996~2015年末与各类人口散点图')

pip2=p1.add_subplot(2,1,2)#绘制⼦图2

plt.scatter(values[0:20,0],values[0:20,2])#,marker='o',color='yellow'

plt.scatter(values[0:20,0],values[0:20,3])#,marker='D',color='green'

plt.scatter(values[0:20,0],values[0:20,4])#,marker='p',color='blue'

plt.scatter(values[0:20,0],values[0:20,5])#,marker='s',color='purple'

plt.xlabel('时间')

plt.ylabel('总人口(万人)')

plt.xticks(values[0:20,0])

plt.legend(['男性','女性','城镇','乡村'])

#在⼦图上绘制折线图

p2=plt.figure(figsize=(12,12))

p1=p2.add_subplot(2,1,1)

plt.plot(values[0:20,0],values[0:20,1])#,linestyle = '-',color='r',marker='8'

plt.ylabel('总人口(万人)')

plt.xticks(range(0,20,1),values[range(0,20,1),0],rotation=45)#rotation设置倾斜度

plt.legend('年末')

plt.title('1996~2015年末总与各类人口折线图')

p2=p2.add_subplot(2,1,2)

plt.plot(values[0:20,0],values[0:20,2])#,'y-'

plt.plot(values[0:20,0],values[0:20,3])#,'g-.'

plt.plot(values[0:20,0],values[0:20,4])#,'b-'

plt.plot(values[0:20,0],values[0:20,5])#,'p-'

plt.xlabel('时间')

plt.ylabel('总人口(万人)')

plt.xticks(values[0:20,0])

plt.legend(['男性','女性','城镇','乡村'])

#显⽰图⽚

plt.show()
结果:
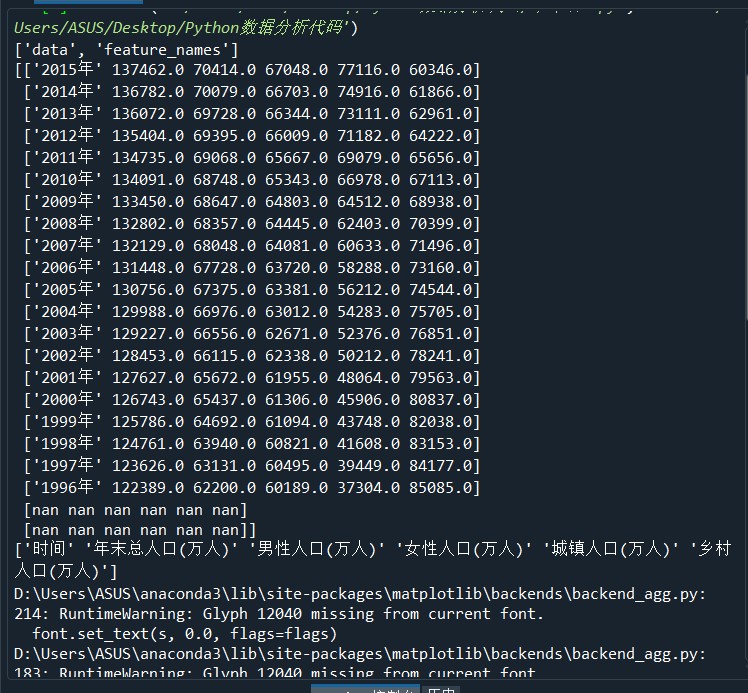
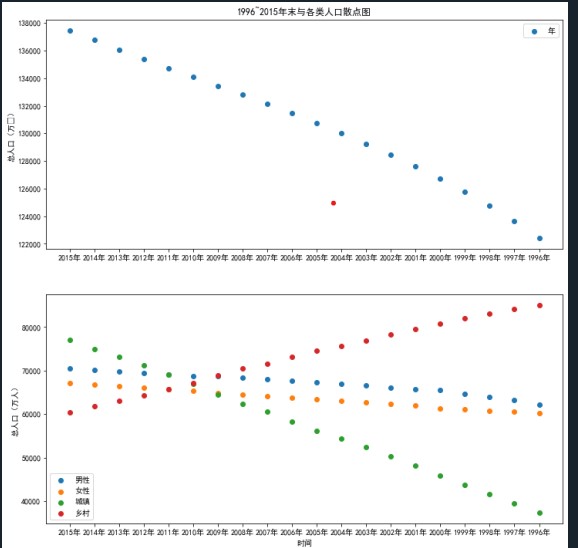
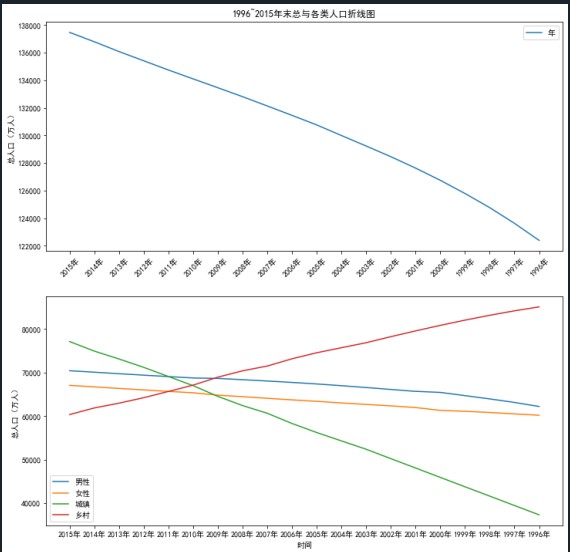
(5)
根据各个特征随着时间推移发生的变化情况可以分析出未来男女人口比例将逐渐趋于平衡状态,城乡人口变化方向将逐渐城镇化。
二、读取并查看P2P网络贷款数据主表的基本信息(1题10分,共10分)
考查知识点:掌握常见的数据读取方式;掌握DataFrame常用属性与方法;掌握基础时间数据处理方法;掌握分组聚合的原理与方法;掌握透视表与交叉表的制作。
需求说明:
P2P贷款主表数据主要存放了网贷用户的基本信息。探索数据的基本信息,能够洞察数据的整体分布、数据的类属关系、从而发现数据间的关联。
要求:
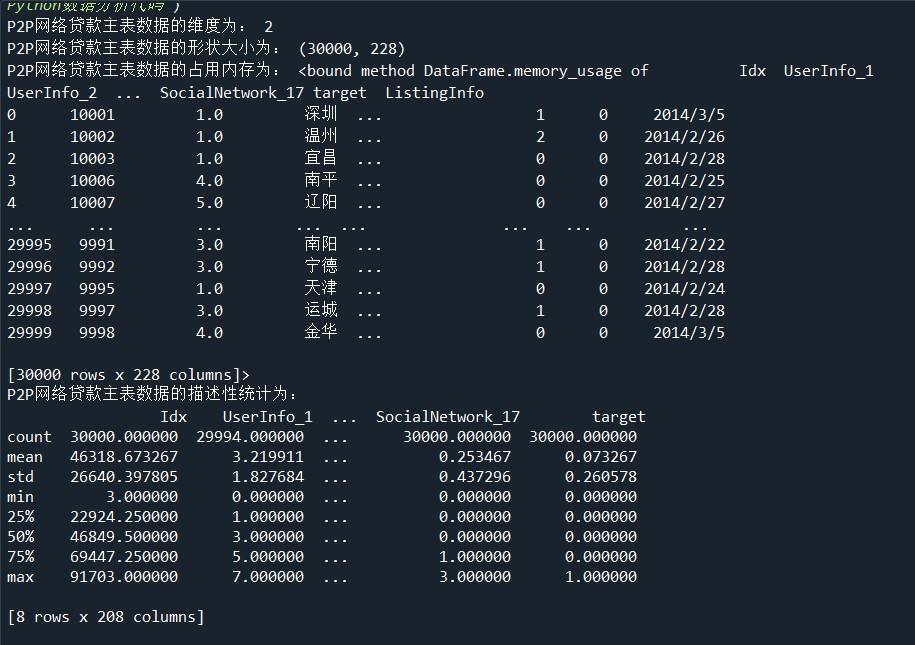
(1)使用ndim、shape、memory_usage属性分别查看维度、大小、占用内存信息。
代码:
#导入模块

import os

import pandas as pd

master = pd.read_csv('D:/Users/ASUS/Desktop/Training_Master.csv',encoding='gbk')#读取csv文件

print('P2P网络贷款主表数据的维度为:',master.ndim)

print('P2P网络贷款主表数据的形状大小为:',master.shape)

print('P2P网络贷款主表数据的占用内存为:',master.memory_usage)

#代码16-2

print('P2P网络贷款主表数据的描述性统计为:\n',master.describe())
结果:
三、提取用户信息更新表和登录信息表的时间信息(1题10分,共10分)
考查知识点:掌握常见的数据读取方式;掌握DataFrame常用属性与方法;掌握基础时间数据处理方法;掌握分组聚合的原理与方法;掌握透视表与交叉表的制作。
需求说明:
用户信息更新表和登录信息表汇总均存在大量的时间数据,提取时间数据内存在的信息,一方面可以加深对数据的理解,另一方面能够探索这部分信息和目标的关联程度。同时用户登录时间、借款成交时间、用户信息更新时间这些时间的时间差信息冶能反映出P2P网络贷款不同用户的行为信息。
要求:
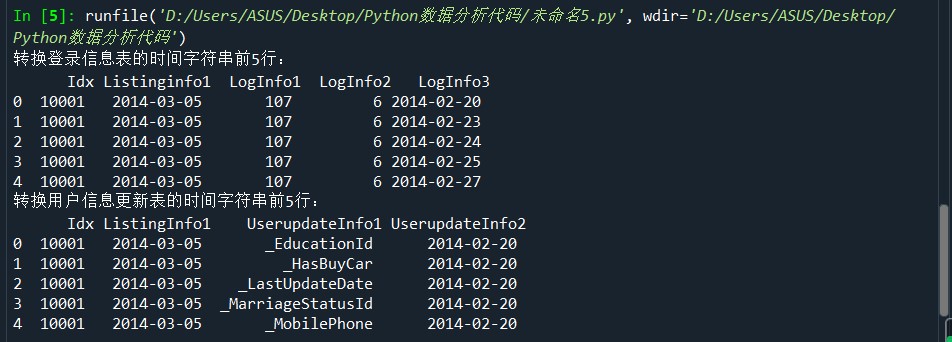
(1)使用to_datetime函数转换用户信息更新表和登录信息表的时间字符串。
代码:
import pandas as pd

#读取文件

LogInfo  = pd.read_csv('D:/Users/ASUS/Desktop/Training_LogInfo(1).csv',encoding='gbk')

Userupdate   = pd.read_csv('D:/Users/ASUS/Desktop/Training_Userupdate.csv',encoding='gbk')

# 转换时间字符串

LogInfo['Listinginfo1']=pd.to_datetime(LogInfo['Listinginfo1'])

LogInfo['LogInfo3']=pd.to_datetime(LogInfo['LogInfo3'])

print('转换登录信息表的时间字符串前5行:\n',LogInfo.head())

Userupdate['ListingInfo1']=pd.to_datetime(Userupdate['ListingInfo1'])

Userupdate['UserupdateInfo2']=pd.to_datetime(Userupdate['UserupdateInfo2'])

print('转换用户信息更新表的时间字符串前5行:\n',Userupdate.head())
结果:
四、使用分组聚合方法进一步分析用户信息更新表和登录信息表(1题30分,共30分)
考查知识点:掌握常见的数据读取方式;掌握DataFrame常用属性与方法;掌握基础时间数据处理方法;掌握分组聚合的原理与方法;掌握透视表与交叉表的制作。
需求说明:
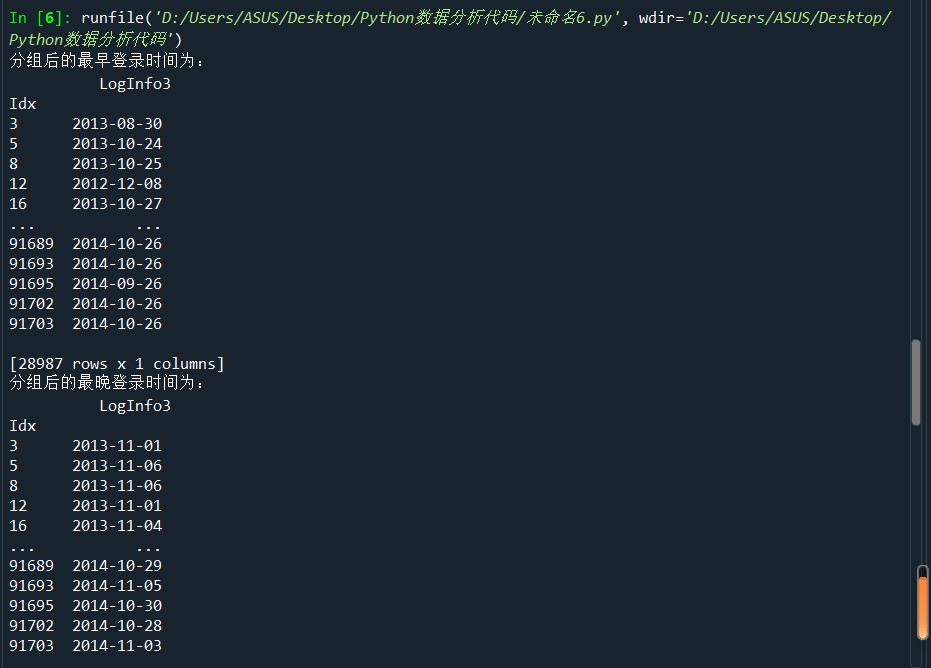
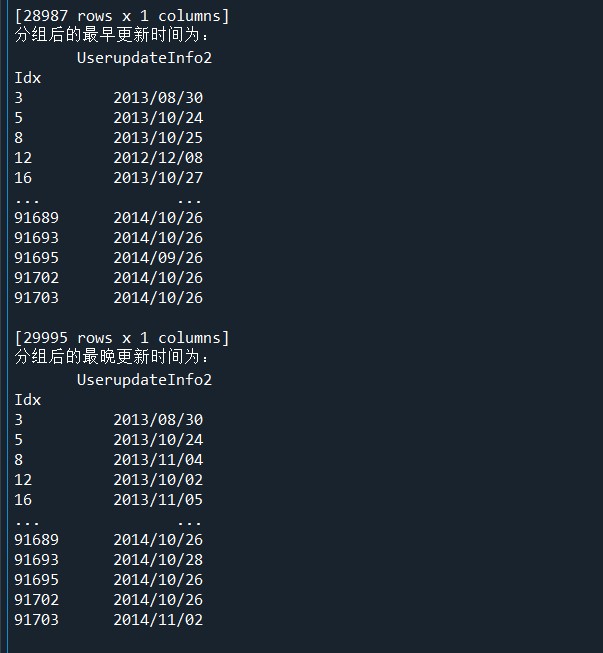
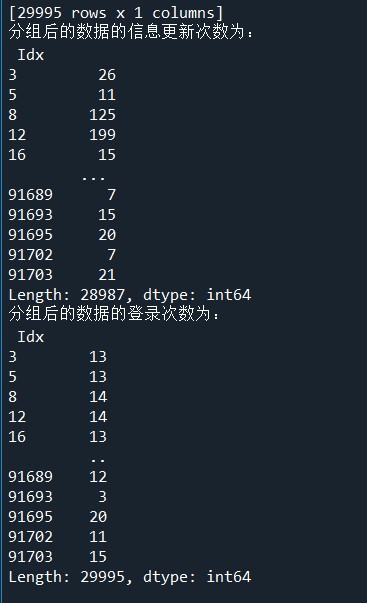
分析用户信息更新表和登录信息表时,除了提取时间本身的信息外,还可以结合用户编号进行分组聚合,然后进行组内分析。通过组内分析可以得出每组组内的最早和最晚信息更新时间、最早和最晚登录时间、信息更新的次数、登录的次数等信息。
要求:
(1)使用groupby方法对用户信息更新表和登录信息表进行分组。
(2)使用agg方法求取分组后的最早和最晚更新及登录时间。
(3)使用size方法求取分组后的数据的信息更新次数与登录次数。
代码:
import pandas as pd

import numpy as np

LogInfo  = pd.read_csv('D:/Users/ASUS/Desktop/Training_LogInfo(1).csv',encoding='gbk')

Userupdate   = pd.read_csv('D:/Users/ASUS/Desktop/Training_Userupdate.csv',encoding='gbk')

# 使用groupby方法对用户信息更新表和登录信息表进行分组

LogGroup = LogInfo[['Idx','LogInfo3']].groupby(by = 'Idx')

UserGroup = Userupdate[['Idx','UserupdateInfo2']].groupby(by = 'Idx')

# 使用agg方法求取分组后的最早,最晚,更新登录时间

print('分组后的最早登录时间为:\n',LogGroup.agg(np.min))

print('分组后的最晚登录时间为:\n',LogGroup.agg(np.max))

print('分组后的最早更新时间为:\n',UserGroup.agg(np.min))

print('分组后的最晚更新时间为:\n',UserGroup.agg(np.max))

# 使用size方法求取分组后的数据的信息更新次数与登录次数

print('分组后的数据的信息更新次数为:\n',LogGroup.size())

print('分组后的数据的登录次数为:\n',UserGroup.size())
结果:
2003031120—廖威—Python数据分析五一假期作业的更多相关文章
- 2003031121-浦娟-python数据分析五一假期作业
项目 内容 课程班级博客链接 20级数据班(本) 这个作业要求链接 Python作业 博客名称 2003031121-浦娟-python数据分析五一假期作业 要求 每道题要有题目,代码(使用插入代码, ...
- 2003031121-浦娟-python数据分析第四周作业-第二次作业
项目 内容 课程班级博客链接 20级数据班(本) 作业链接 Python第四周作业第二次作业 博客名称 2003031121-浦娟-python数据分析第四周作业-matolotlib的应用 要求 每 ...
- 2003031121——浦娟——Python数据分析第七周作业——MySQL的安装及使用
项目 要求 课程班级博客链接 20级数据班(本) 作业要求链接 Python第七周作业 博客名称 2003031121--浦娟--Python数据分析第七周作业--MySQL的安装及使用 要求 每道题 ...
- 2003031121-浦娟-python数据分析第三周作业-第一次作业
项目 内容 课程班级博客链接 https://edu.cnblogs.com/campus/pexy/20sj 作业链接 https://edu.cnblogs.com/campus/pexy/20s ...
- 零基础学习Python数据分析
网上虽然有很多Python学习的教程,但是大多是围绕Python网页开发等展开.数据分析所需要的Python技能和网页开发等差别非常大,本人就是浪费了很多时间来看这些博客.书籍.所以就有了本文,希望能 ...
- Python 数据分析(二 本实验将学习利用 Python 数据聚合与分组运算,时间序列,金融与经济数据应用等相关知识
Python 数据分析(二) 本实验将学习利用 Python 数据聚合与分组运算,时间序列,金融与经济数据应用等相关知识 第1节 groupby 技术 第2节 数据聚合 第3节 分组级运算和转换 第4 ...
- Python数据分析(二): Numpy技巧 (2/4)
numpy.pandas.matplotlib(+seaborn)是python数据分析/机器学习的基本工具. numpy的内容特别丰富,我这里只能介绍一下比较常见的方法和属性. 昨天晚上发了第一 ...
- Python数据分析(二): Numpy技巧 (3/4)
numpy.pandas.matplotlib(+seaborn)是python数据分析/机器学习的基本工具. numpy的内容特别丰富,我这里只能介绍一下比较常见的方法和属性. 昨天晚上发了第一 ...
- Python数据分析与挖掘所需的Pandas常用知识
Python数据分析与挖掘所需的Pandas常用知识 前言Pandas基于两种数据类型:series与dataframe.一个series是一个一维的数据类型,其中每一个元素都有一个标签.series ...
- [Python数据分析]新股破板买入,赚钱几率如何?
这是本人一直比较好奇的问题,网上没搜到,最近在看python数据分析,正好自己动手做一下试试.作者对于python是零基础,需要从头学起. 在写本文时,作者也没有完成这个小分析目标,边学边做吧. == ...
随机推荐
- 第一个helloworld程序
; hello.asm section .data msg db "hello, world",13,10,0 section .bss section .text global ...
- SpringBoot(十五)单个以及多个跨域的配置方法
同源策略是浏览器的一个安全限制,要求域名.协议.端口相同,如果不同则没办法进行数据交互.而跨域配置,则是为了解除这方面的限制.前后端分离的情况下,因为需要分开部署,后台开发基本都需要进行跨域配置了.( ...
- 記錄一下oracle数据库系统的comment數據字典(轉載)
一.comment是oracle数据库系统的关键字,所以不能用来命名表明或字段名 二.comment关键字用于对表,字段添加注释,有利于用户对表结构以及数据库对象含义的理解. 三.用户可以通过数据字典 ...
- 记一个在线工具网站,程序员必备,json格式化、压缩、转义,加解密 编码解码
简用-在线工具箱-简单易用-工具大全 提供 json格式化,json代码压缩,json校验解析,json数组解析,json转xml,xml转json,json解析,json在线解析,json在线解析及 ...
- 关于 echarts 使用 geo 制作地图 tooltip 不显示问题(转)
原文地址 我之前遇到过这问题,单独设置 tooltip 没效果,geo 下面也有 tooltip 属性,但是也不管用,网上查了一下说 geo 不支持 tooltip 提示框显示,就自己根据 echar ...
- 嵌入式开发er的C语言能力自测(面试)题---top 16
准备面试刷到的,链接里是原文和答案: (a-c-test-the-0x10-best-questions-for-would-be-embedded-programmers) 这里我先只给出问题,可以 ...
- DataTable操作汇总
1.排序 DataTable dt = new DataTable(); dt.Columns.Add("Name"); dt.Columns.Add("Age" ...
- egg开发系列--模板语法
在这里列一下 nunjucks 常用的模板内容 首先需要在plugin.js 当中引入 exports.nunjucks = { enable: true, package: 'egg-view-nu ...
- Word09 会计电算化节节高升office真题
1.课程的讲解之前,先来对题目进行分析,首先需要在考生文件夹下,将Wrod素材.docx文件另存为Word.docx,后续操作均基于此文件,否则不得分. 2.这一步非常的简单,打开下载素材文件,在[文 ...
- Java流程控制之Scanner的进阶使用
Scanner的进阶使用 import java.util.Scanner; public class Demo04 { public static void main(String[] args) ...