
Apache Spark源码走读之15 -- Standalone部署模式下的容错性分析
欢迎转载,转载请注明出处,徽沪一郎。
概要
本文就standalone部署方式下的容错性问题做比较细致的分析,主要回答standalone部署方式下的包含哪些主要节点,当某一类节点出现问题时,系统是如何处理的。
Standalone部署的节点组成
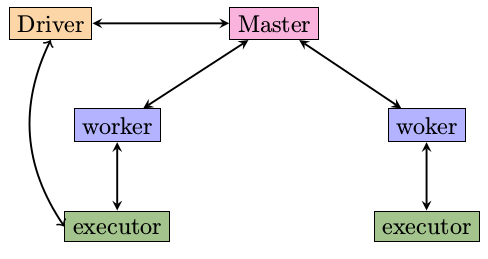
介绍Spark的资料中对于RDD这个概念涉及的比较多,但对于RDD如何运行起来,如何对应到进程和线程的,着墨的不是很多。
在实际的生产环境中,Spark总是会以集群的方式进行运行的,其中standalone的部署方式是所有集群方式中最为精简的一种,另外是Mesos和YARN,要理解其内部运行机理,显然要花更多的时间才能了解清楚。
standalone cluster的组成
standalone集群由三个不同级别的节点组成,分别是
- Master 主控节点,可以类比为董事长或总舵主,在整个集群之中,最多只有一个Master处在Active状态
- Worker 工作节点 ,这个是manager,是分舵主, 在整个集群中,可以有多个worker,如果worker为零,什么事也做不了
- Executor 干苦力活的,直接受worker掌控,一个worker可以启动多个executor,启动的个数受限于机器中的cpu核数
这三种不同类型的节点各自运行于自己的JVM进程之中。
Driver Application
提交到standalone集群的应用程序称之为Driver Applicaton。
Standalone集群启动及任务提交过程详解
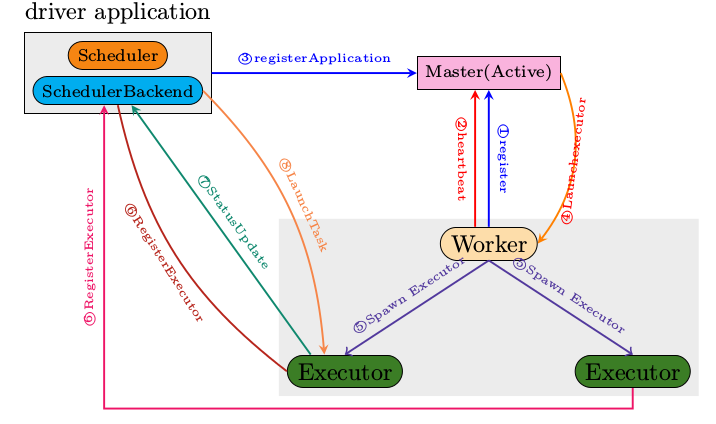
上图总结了正常情况下Standalone集群的启动以及应用提交时,各节点之间有哪些消息交互。下面分集群启动和应用提交两个过程来作详细说明。
集群启动过程
正常启动过程如下所述
step 1: 启动master
$SPARK_HOME/sbin/start-master.sh
step 2: 启动worker
./bin/spark-class org.apache.spark.deploy.worker.Worker spark://localhost:7077
worker启动之后,会做两件事情
- 将自己注册到Master, RegisterWorker
- 定期发送心跳消息给Master
任务提交过程
step 1: 提交application
利用如下指令来启动spark-shell
MASTER=spark://127.0.0.1:7077 $SPARK_HOME/bin/spark-shell
运行spark-shell时,会向Master发送RegisterApplication请求
日志位置: master运行产生的日志在$SPARK_HOME/logs目录下
step 2: Master处理RegisterApplication的请求之后
收到RegisterApplication请求之后,Mastet会做如下处理
- 如果有worker已经注册上来,发送LaunchExecutor指令给相应worker
- 如果没有,则什么事也不做
step 3: 启动Executor
Worker在收到LaunchExecutor指令之后,会启动Executor进程
step 4: 注册Executor
启动的Executor进程会根据启动时的入参,将自己注册到Driver中的SchedulerBackend
日志位置: executor的运行日志在$SPARK_HOME/work目录下
step 5: 运行Task
SchedulerBackend收到Executor的注册消息之后,会将提交到的Spark Job分解为多个具体的Task,然后通过LaunchTask指令将这些Task分散到各个Executor上真正的运行
如果在调用runJob的时候,没有任何的Executor注册到SchedulerBackend,相应的处理逻辑是什么呢?
- SchedulerBackend会将Task存储在TaskManager中
- 一旦有Executor注册上来,就将TaskManager管理的尚未运行的task提交到executor中
- 如果有多个job处于pending状态,默认调度策略是FIFO,即先提交的先运行
测试步骤
- 启动Master
- 启动spark-shell
- 执行 sc.textFile("README.md").count
- 启动worker
- 注意worker启动之后,spark-shell中打印出来的日志消息
Job执行结束
任务运行结束时,会将相应的Executor停掉。
可以做如下的试验
- 停止spark-shell
- 利用ps -ef|grep -i java查看java进程,可以发现CoarseGrainedExecutorBackend进程已经退出
小结
通过上面的控制消息原语之间的先后顺序可以看出
- Master和worker进程必须显式启动
- executor是被worker隐式的带起
- 集群的启动顺序
- Master必须先于其它节点启动
- worker和driver哪个先启动,无所谓
- 但driver提交的job只有在有相应的worker注册到Master之后才可以被真正的执行
异常场景分析
上面说明的是正常情况下,各节点的消息分发细节。那么如果在运行中,集群中的某些节点出现了问题,整个集群是否还能够正常处理Application中的任务呢?
异常分析1: worker异常退出
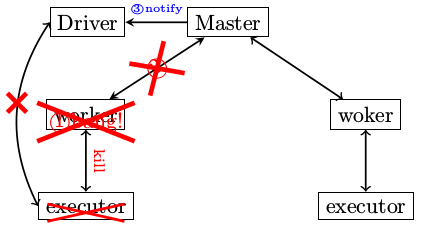
在Spark运行过程中,经常碰到的问题就是worker异常退出,当worker退出时,整个集群会有哪些故事发生呢? 请看下面的具体描述
- worker异常退出,比如说有意识的通过kill指令将worker杀死
- worker在退出之前,会将自己所管控的所有小弟executor全干掉
- worker需要定期向master改善心跳消息的,现在worker进程都已经玩完了,哪有心跳消息,所以Master会在超时处理中意识到有一个“分舵”离开了
- Master非常伤心,伤心的Master将情况汇报给了相应的Driver
- Driver通过两方面确认分配给自己的Executor不幸离开了,一是Master发送过来的通知,二是Driver没有在规定时间内收到Executor的StatusUpdate,于是Driver会将注册的Executor移除
后果分析
worker异常退出会带来哪些影响
- executor退出导致提交的task无法正常结束,会被再一次提交运行
- 如果所有的worker都异常退出,则整个集群不可用
- 需要有相应的程序来重启worker进程,比如使用supervisord或runit
测试步骤
- 启动Master
- 启动worker
- 启动spark-shell
- 手工kill掉worker进程
- 用jps或ps -ef|grep -i java来查看启动着的java进程
异常退出的代码处理
定义于ExecutorRunner.scala的start函数
def start() {

    workerThread = new Thread("ExecutorRunner for " + fullId) {

      override def run() { fetchAndRunExecutor() }

    }

    workerThread.start()

    // Shutdown hook that kills actors on shutdown.

    shutdownHook = new Thread() {

      override def run() {

        killProcess(Some("Worker shutting down"))

      }

    }

    Runtime.getRuntime.addShutdownHook(shutdownHook)

  }
killProcess的过程就是停止相应CoarseGrainedExecutorBackend的过程。
worker停止的时候,一定要先将自己启动的Executor停止掉。这是不是很像水浒中宋江的手段,李逵就是这样不明不白的把命给丢了。
小结
需要特别指出的是,当worker在启动Executor的时候,是通过ExecutorRunner来完成的,ExecutorRunner是一个独立的线程,和Executor是一对一的关系,这很重要。Executor作为一个独立的进程在运行,但会受到ExecutorRunner的严密监控。
异常分析2: executor异常退出
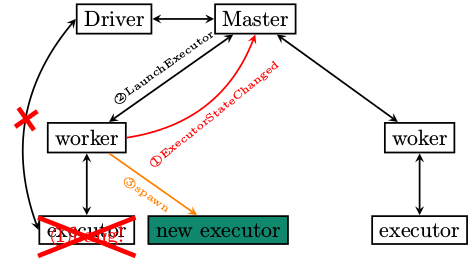
Executor作为Standalone集群部署方式下的最底层员工,一旦异常退出,其后果会是什么呢?
- executor异常退出,ExecutorRunner注意到异常,将情况通过ExecutorStateChanged汇报给Master
- Master收到通知之后,非常不高兴,尽然有小弟要跑路,那还了得,要求Executor所属的worker再次启动
- Worker收到LaunchExecutor指令,再次启动executor
作为一名底层员工,想轻易摞挑子不干是不成的。"人在江湖,身不由己“啊。
测试步骤
- 启动Master
- 启动Worker
- 启动spark-shell
- 手工kill掉CoarseGrainedExecutorBackend
fetchAndRunExecutor
fetchAndRunExecutor负责启动具体的Executor,并监控其运行状态,具体代码逻辑如下所示
def fetchAndRunExecutor() {

    try {

      // Create the executor's working directory

      val executorDir = new File(workDir, appId + "/" + execId)

      if (!executorDir.mkdirs()) {

        throw new IOException("Failed to create directory " + executorDir)

      }

      // Launch the process

      val command = getCommandSeq

      logInfo("Launch command: " + command.mkString("\"", "\" \"", "\""))

      val builder = new ProcessBuilder(command: _*).directory(executorDir)

      val env = builder.environment()

      for ((key, value)  {

        logInfo("Runner thread for executor " + fullId + " interrupted")

        state = ExecutorState.KILLED

        killProcess(None)

      }

      case e: Exception => {

        logError("Error running executor", e)

        state = ExecutorState.FAILED

        killProcess(Some(e.toString))

      }

    }

  }
异常分析3: master 异常退出
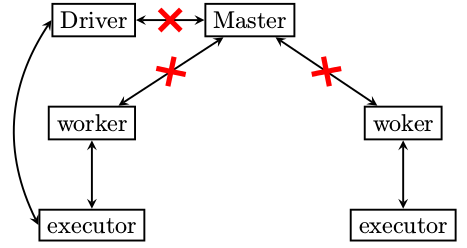
worker和executor异常退出的场景都讲到了,我们剩下最后一种情况了,master挂掉了怎么办?
带头大哥如果不在了,会是什么后果呢?
- worker没有汇报的对象了,也就是如果executor再次跑飞,worker是不会将executor启动起来的,大哥没给指令
- 无法向集群提交新的任务
- 老的任务即便结束了,占用的资源也无法清除,因为资源清除的指令是Master发出的
怎么样,知道后果很严重了吧?别看老大平时不干活,要真的不在,仅凭小弟们是不行的。
Master单点失效问题的解决
那么怎么解决Master单点失效的问题呢?
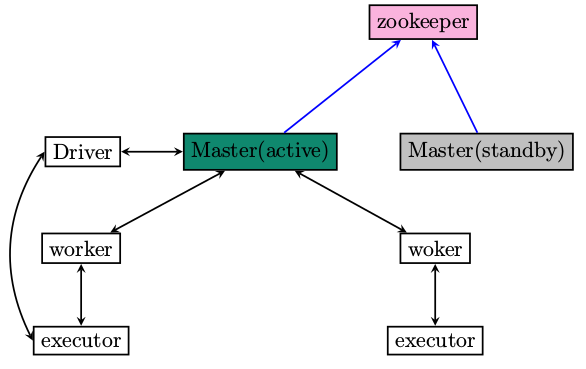
你说再加一个Master就是了,两个老大。两个老大如果同时具有指挥权,结果也将是灾难性的。设立一个副职人员,当目前的正职挂掉之后,副职接管。也就是同一时刻,有且只有一个active master。
注意不错,如何实现呢?使用zookeeper的ElectLeader功能,效果图如下
配置细节
如何搭建zookeeper集群,这里不再废话,哪天有空的话再整一整,或者可以参考写的storm系列中谈到的zookeeper的集群安装步骤。
假设zookeeper集群已经设置成功,那么如何启动standalone集群中的节点呢?有哪些特别的地方?
conf/spark-env.sh
在conf/spark-env.sh中,为SPARK_DAEMON_JAVA_OPTS添加如下选项
| System property | Meaning |
| spark.deploy.recoveryMode | Set to ZOOKEEPER to enable standby Master recovery mode (default: NONE). |
| spark.deploy.zookeeper.url | The ZooKeeper cluster url (e.g., 192.168.1.100:2181,192.168.1.101:2181). |
| spark.deploy.zookeeper.dir | The directory in ZooKeeper to store recovery state (default: /spark). |
设置SPARK_DAEMON_JAVA_OPTS的实际例子
SPARK_DAEMON_JAVA_OPTS="$SPARK_DAEMON_JAVA_OPTS -Dspark.deploy.recoveryMode=ZOOKEEPER"
应用程序启动
应用程序运行的时候,指定多个master地址,用逗号分开,如下所示
MASTER=spark://192.168.100.101:7077,spark://192.168.100.102:7077 bin/spark-shell
小结
Standalone集群部署方式下的容错性分析让我们对于Spark的任务分发过程又有了进一处的认识。前面的篇章从整体上匆匆过了一遍Spark所涉及的知识点,分析的不够深,不够细。
此篇尝试着就某一具体问题做深入的分析。套用书画中的说法,在框架分析的时候,我们可以”大开大合,疏可走马,计白当黑“,在细节分析的时候,又要做到“密不透风,条分缕析,层层递进”。
Apache Spark源码走读之15 -- Standalone部署模式下的容错性分析的更多相关文章
- Apache Spark源码走读之19 -- standalone cluster模式下资源的申请与释放
欢迎转载,转载请注明出处,徽沪一郎. 概要 本文主要讲述在standalone cluster部署模式下,Spark Application在整个运行期间,资源(主要是cpu core和内存)的申请与 ...
- Apache Spark源码走读之7 -- Standalone部署方式分析
欢迎转载,转载请注明出处,徽沪一郎. 楔子 在Spark源码走读系列之2中曾经提到Spark能以Standalone的方式来运行cluster,但没有对Application的提交与具体运行流程做详细 ...
- Apache Spark技术实战之8:Standalone部署模式下的临时文件清理
未经本人同意严禁转载,徽沪一郎. 概要 在Standalone部署模式下,Spark运行过程中会创建哪些临时性目录及文件,这些临时目录和文件又是在什么时候被清理,本文将就这些问题做深入细致的解答. 从 ...
- Apache Spark源码走读之3 -- Task运行期之函数调用关系分析
欢迎转载,转载请注明出处,徽沪一郎. 概要 本篇主要阐述在TaskRunner中执行的task其业务逻辑是如何被调用到的,另外试图讲清楚运行着的task其输入的数据从哪获取,处理的结果返回到哪里,如何 ...
- Apache Spark源码走读之16 -- spark repl实现详解
欢迎转载,转载请注明出处,徽沪一郎. 概要 之所以对spark shell的内部实现产生兴趣全部缘于好奇代码的编译加载过程,scala是需要编译才能执行的语言,但提供的scala repl可以实现代码 ...
- Apache Spark源码走读之13 -- hiveql on spark实现详解
欢迎转载,转载请注明出处,徽沪一郎 概要 在新近发布的spark 1.0中新加了sql的模块,更为引人注意的是对hive中的hiveql也提供了良好的支持,作为一个源码分析控,了解一下spark是如何 ...
- Apache Spark源码走读之1 -- Spark论文阅读笔记
欢迎转载,转载请注明出处,徽沪一郎. 楔子 源码阅读是一件非常容易的事,也是一件非常难的事.容易的是代码就在那里,一打开就可以看到.难的是要通过代码明白作者当初为什么要这样设计,设计之初要解决的主要问 ...
- Apache Spark源码走读之23 -- Spark MLLib中拟牛顿法L-BFGS的源码实现
欢迎转载,转载请注明出处,徽沪一郎. 概要 本文就拟牛顿法L-BFGS的由来做一个简要的回顾,然后就其在spark mllib中的实现进行源码走读. 拟牛顿法 数学原理 代码实现 L-BFGS算法中使 ...
- Apache Spark源码走读之18 -- 使用Intellij idea调试Spark源码
欢迎转载,转载请注明出处,徽沪一郎. 概要 上篇博文讲述了如何通过修改源码来查看调用堆栈,尽管也很实用,但每修改一次都需要编译,花费的时间不少,效率不高,而且属于侵入性的修改,不优雅.本篇讲述如何使用 ...
随机推荐
- CUDA学习笔记(一)——CUDA编程模型
转自:http://blog.sina.com.cn/s/blog_48b9e1f90100fm56.html CUDA的代码分成两部分,一部分在host(CPU)上运行,是普通的C代码:另一部分在d ...
- 如何用OpenCV自带的adaboost程序训练并检测目标
参考博文: 1.http://blog.csdn.net/wuxiaoyao12/article/details/39227189 2.http://www.cnblogs.com/easymind2 ...
- .NET委托解析
委托这个概念其实我们都很熟悉了,但是在使用的时候很多人还是无法去把控它,我们可以试想一下,在平时编码的时候,你是直接按照业务逻辑直接创建类,new出一个对象来进行操作的还是说有用到委托来更高效的完成一 ...
- [转]ThreadPoolExecutor线程池的分析和使用
1. 引言 合理利用线程池能够带来三个好处. 第一:降低资源消耗.通过重复利用已创建的线程降低线程创建和销毁造成的消耗. 第二:提高响应速度.当任务到达时,任务可以不需要等到线程创建就能立即执行. 第 ...
- js 默认行为取消
js 默认行为取消 可以简单的 return false; 看需求吧 <!DOCTYPE html PUBLIC "-//W3C//DTD HTML 4.01 Transit ...
- SAE Java相关问题小结
转自:http://blog.csdn.net/bhq2010/article/details/8580412 Sae中使用的servlet容器是jetty7.4.x 我想在web.xml中配置一个自 ...
- java错题本
1.判断题: Java程序一般应当含有main方法,因为它是所有JaVa程序执行的入口(错) 解析:applet(java小程序)不用,application(java应用程序)需要.(见java a ...
- BZOJ 1072: [SCOI2007]排列perm 状态压缩DP
1072: [SCOI2007]排列perm Description 给一个数字串s和正整数d, 统计s有多少种不同的排列能被d整除(可以有前导0).例如123434有90种排列能被2整除,其中末位为 ...
- 10692 XYM-入门之道
Description 在华农的ACM界中,也有一对闻名古今的双胖师徒组合—XYM和BM. BM师父有一个特殊的癖好,BM肚子很大,因为他很 喜欢吃西瓜,但是BM的嘴很小,一次只能吃下大小不超过K的西 ...
- Lazy Load, 延迟加载图片的 jQuery 插件【备忘】
http://www.neoease.com/lazy-load-jquery-plugin-delay-load-image/ jQuery Unveil – 另一款非常轻量的延迟加载插件 http ...