
使用selenium再次爬取疫情数据(链接数据库)
爬取网页地址:
数据库连接代码:
def db_connect():

    try:

        db=pymysql.connect('localhost','root','zzm666','payiqing')

        print('database connect success')

        return db

    except Exception as e:

        raise e

    return 0
爬取代码:
def pa_website(db):

    driver = webdriver.Chrome()

    driver.get('https://ncov.dxy.cn/ncovh5/view/pneumonia?from=timeline&isappinstalled=0')

    time.sleep(5)#页面渲染等待,保证数据完整性

    driver.find_element_by_xpath('//*[@id="root"]/div/div[4]/div[9]/div[21]').click()#点击更多数据,页面数据未加载完

    divs=driver.find_elements_by_xpath('//*[@id="root"]/div/div[4]/div[9]/div[@class="fold___85nCd"]')#找到要爬取的数据上一次代码路径

    cursor = db.cursor()

    for div in divs:

        address=str(div.find_element_by_xpath('.//div[@class="areaBlock1___3qjL7"]/p[1]').text)

        confirm_issue=str(div.find_element_by_xpath('.//div[@class="areaBlock1___3qjL7"]/p[2]').text)

        all_confirm=str(div.find_element_by_xpath('.//div[@class="areaBlock1___3qjL7"]/p[3]').text)

        dead=str(div.find_element_by_xpath('.//div[@class="areaBlock1___3qjL7"]/p[4]').text)

        cure=str(div.find_element_by_xpath('.//div[@class="areaBlock1___3qjL7"]/p[5]').text)

        with open('data.csv','a',newline="") as csvfile:#创建data.csv文件,(推荐采用这种方式)

            writer=csv.writer(csvfile,delimiter=',')

            writer.writerow([address,confirm_issue,all_confirm,dead,cure])

        sql="insert into info(id,address,confirm_issue,all_confirm,dead,cure)values ('%d','%s','%s','%s','%s','%s')"%(0,address,confirm_issue,all_confirm,dead,cure)

        try:

            cursor.execute(sql)

            db.commit()

            print('数据插入成功')

        except Exception as e:

            raise e

    db.close()
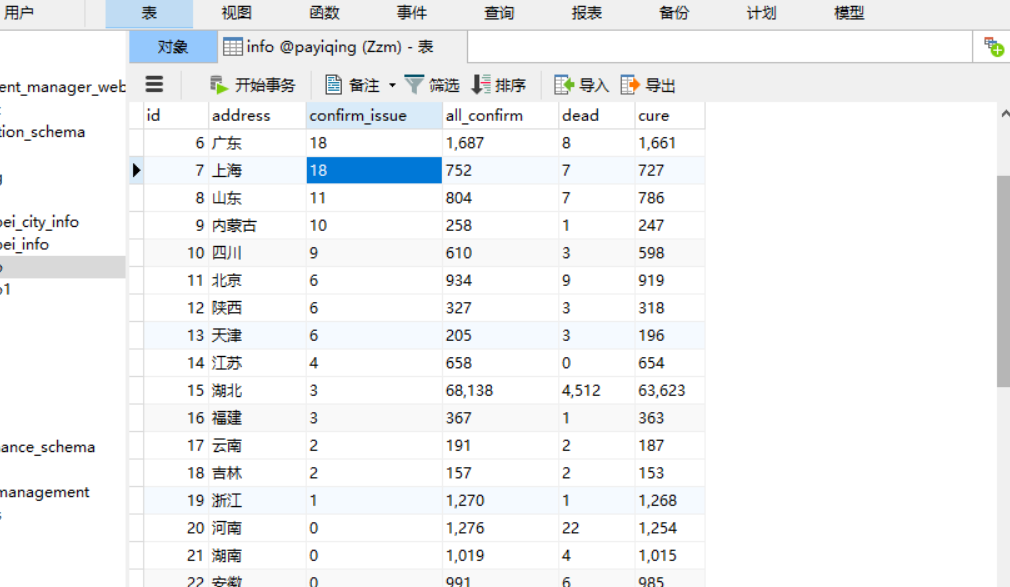
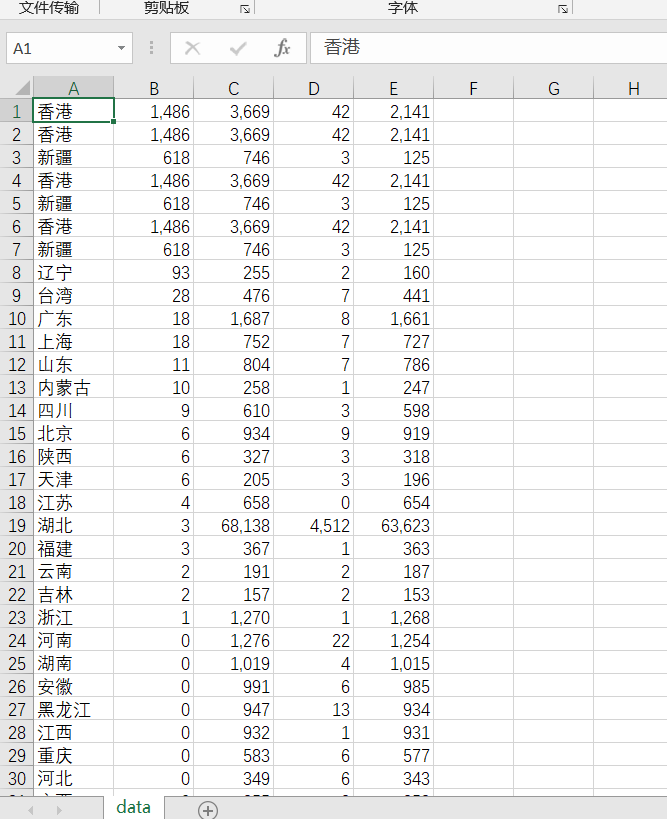
爬取流程:
1.获取目标网址
2.获取上一级目标路径
3.遍历路径下的目标
4.获取数据信息
5.生存csv文件展示(可以省略)
6.插入数据库
7.当数据全部插入后,关闭数据库
附(总源码+程序截图):
import csv

import requests

from selenium import webdriver

import pymysql

import time

from selenium.webdriver import  ActionChains  #动作链,滑动验证码登录

def db_connect():

    try:

        db=pymysql.connect('localhost','root','zzm666','payiqing')

        print('database connect success')

        return db

    except Exception as e:

        raise e

    return 0

def pa_website(db):

    driver = webdriver.Chrome()

    driver.get('https://ncov.dxy.cn/ncovh5/view/pneumonia?from=timeline&isappinstalled=0')

    time.sleep(5)

    driver.find_element_by_xpath('//*[@id="root"]/div/div[4]/div[9]/div[21]').click()

    divs=driver.find_elements_by_xpath('//*[@id="root"]/div/div[4]/div[9]/div[@class="fold___85nCd"]')

    cursor = db.cursor()

    for div in divs:

        address=str(div.find_element_by_xpath('.//div[@class="areaBlock1___3qjL7"]/p[1]').text)

        confirm_issue=str(div.find_element_by_xpath('.//div[@class="areaBlock1___3qjL7"]/p[2]').text)

        all_confirm=str(div.find_element_by_xpath('.//div[@class="areaBlock1___3qjL7"]/p[3]').text)

        dead=str(div.find_element_by_xpath('.//div[@class="areaBlock1___3qjL7"]/p[4]').text)

        cure=str(div.find_element_by_xpath('.//div[@class="areaBlock1___3qjL7"]/p[5]').text)

        with open('data.csv','a',newline="") as csvfile:

            writer=csv.writer(csvfile,delimiter=',')

            writer.writerow([address,confirm_issue,all_confirm,dead,cure])

        sql="insert into info(id,address,confirm_issue,all_confirm,dead,cure)values ('%d','%s','%s','%s','%s','%s')"%(0,address,confirm_issue,all_confirm,dead,cure)

        try:

            cursor.execute(sql)

            db.commit()

            print('数据插入成功')

        except Exception as e:

            raise e

    db.close()

def main():

    db = db_connect()

    pa_website(db)

if __name__=="__main__":

    main()

使用selenium再次爬取疫情数据(链接数据库)的更多相关文章
- 爬取疫情数据,以django+pyecharts实现数据可视化web网页
在家呆着也是呆着,不如做点什么消磨时间呗~ 试试用django+pyecharts实现疫情数据可视化web页面 这里要爬疫情数据 来自丁香园.搜狗及百度的疫情实时动态展示页 先看看劳动成果: 导航栏: ...
- selenium爬虫 | 爬取疫情实时动态(二)
'''@author:Billie更新说明:1-28 17:00 项目开始着手,spider方法抓取到第一条疫情数据,save_data_csv方法将疫情数据保存至csv文件1-29 13:12 目标 ...
- python爬取疫情数据详解
首先逐步分析每行代码的意思: 这是要引入的东西: from os import path import requests from bs4 import BeautifulSoup import js ...
- 利用Python爬取疫情数据并使用可视化工具展示
import requests, json from pyecharts.charts import Map, Page, Pie, Bar from pyecharts import options ...
- selenium爬虫 | 爬取疫情实时动态
import csvimport selenium.webdriverfrom selenium.webdriver.chrome.options import Optionsclass spider ...
- python爬取疫情数据存入MySQL数据库
import requests from bs4 import BeautifulSoup import json import time from pymysql import * def mes( ...
- 使用selenium进行爬取掘金前端小册的数据
Selenium 简介 百度百科介绍: Selenium [1] 是一个用于Web应用程序测试的工具.Selenium测试直接运行在浏览器中,就像真正的用户在操作一样.支持的浏览器包括IE(7, 8, ...
- 使用webdriver+urllib爬取网页数据(模拟登陆,过验证码)
urilib是python的标准库,当我们使用Python爬取网页数据时,往往用的是urllib模块,通过调用urllib模块的urlopen(url)方法返回网页对象,并使用read()方法获得ur ...
- [python爬虫] Selenium定向爬取PubMed生物医学摘要信息
本文主要是自己的在线代码笔记.在生物医学本体Ontology构建过程中,我使用Selenium定向爬取生物医学PubMed数据库的内容. PubMed是一个免费的搜寻引擎,提供生物医学方 ...
随机推荐
- 07 Vue常见插件
项目功能插件 1.vue-router { path: '/', name: 'home', // 路由的重定向 redirect: '/home' } { // 一级路由, 在根组件中被渲染, 替换 ...
- EM算法理论与推导
EM算法(Expectation-maximization),又称最大期望算法,是一种迭代算法,用于含有隐变量的概率模型参数的极大似然估计(或极大后验概率估计) 从定义可知,该算法是用来估计参数的,这 ...
- 数据可视化之分析篇(八)Power BI数据分析应用:结构百分比分析法
https://zhuanlan.zhihu.com/p/113113765 PowerBI数据分析02:结构百分比分析法 作者:海艳 结构百分比分析法,又称纵向分析,是指同一期间财务报表中不同项目间 ...
- bzoj3526[Poi2014]Card*
bzoj3526[Poi2014]Card 题意: 有n张卡片在桌上一字排开,每张卡片上有两个数,第i张卡片上,正面的数为a[i],反面的数为b[i].有m个操作,第i个操作会交换c[i]和d[i]两 ...
- 用maven打包java项目的pom文件配置
<project xmlns="http://maven.apache.org/POM/4.0.0" xmlns:xsi="http://www.w3.org/20 ...
- 详解TCP一:三次握手、四次挥手
TCP协议同样是运输层的协议,掌握TCP重点要关注这几个问题:顺序问题.丢包问题.连接维护.流量控制.拥塞控制.先解析下TCP报文段结构,相比于UDP要复杂很多. 首先还是两个端口号,对应着具体的应用 ...
- 0.9循环=lim(n趋于无穷大)(1-1/10的n次方),所以这是一个极限问题
0.9循环=lim(n趋于无穷大)(1-1/10的n次方),所以这是一个极限问题 因为lim(...)(1-1/10的n次方)=1 这意味着维尔斯特拉斯发明极限定义之前,这个等号是不成立的,因为没有极 ...
- transaction already active
这个问题是使用spring 事务管理时经常出现的错误,最开始时相当令我头疼,也不知道是哪里出现的问题.在网上找了一阵后,依然无解.意思就是说上一个事务处于激活状态中,不能开始新的数据库更新操作. // ...
- php iamp 接收邮件,收取邮件,获取邮件列表
每次想写的时候吧,提笔忘字.等到再次使用,又得想半天,,,,,好尴尬. 这次一边做一边写. 心得,程序员从菜鸟往老鸟转变的重要一步,学英语,看文档,在此我万分感谢鸟哥,,,,没他php哪有官方的中文注 ...
- stringsream用法
stringstream: 头文件: #include <sstream> 简单整理一下这玩意的作用,主要有三个吧. 类型转化 字符串拼接 字符串整合(这一个用处特别大!!!!!!!) 先 ...