
关于在scrapy中使用xpath
1. 还是以虎嗅为例,他给我返回的是一个json格式的json串
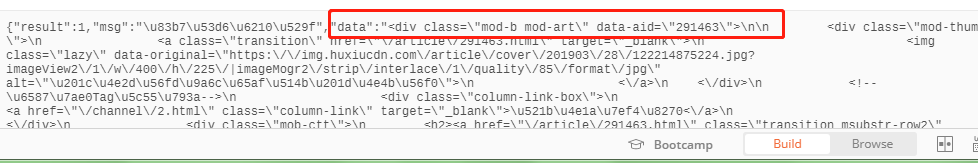
2.那么我需要操作的就是把json串转换成我们的字典格式再进行操作
str=json.loads(response.body)['data'] #这边是拿到响应体数据,然后进行序列化成字典,拿到字典中key为data的的值.是一个字符串
3.自己导入选择器
from scrapy.selector import Selector
4.使用Selector的xpath方法获取内容
result = Selector(text=你从json提取出来的str).xpath('你的xpath表达式').extract()
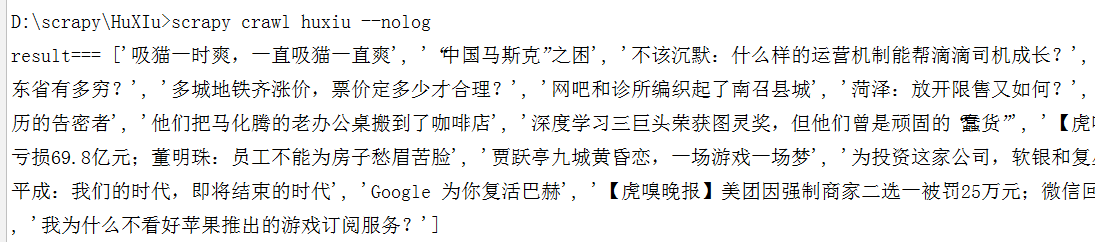
5.使用效果
我把上一篇虎嗅的在parse中修改了来示范一下
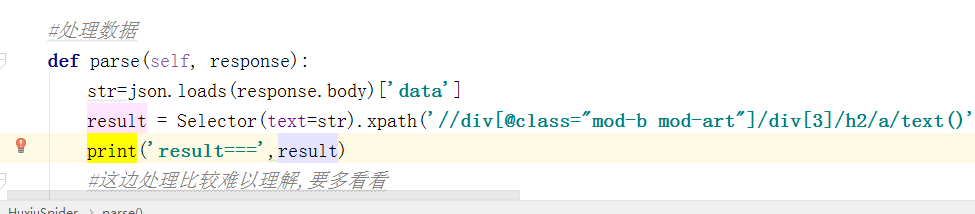
 #处理数据

    def parse(self, response):

        str=json.loads(response.body)['data']

        result = Selector(text=str).xpath('//div[@class="mod-b mod-art"]/div[3]/h2/a/text()').extract()

        print('result===',result)

        #这边处理比较难以理解,要多看看
5.文档
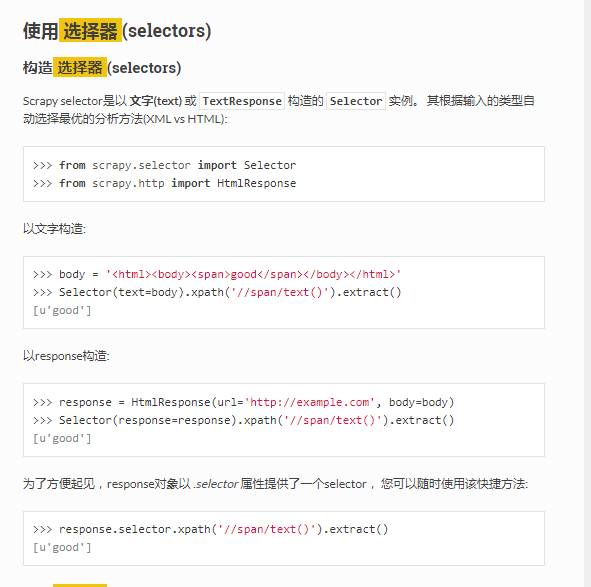
  当输入 response.selector 时, 您将获取到一个可以用于查询返回数据的selector(选择器),
以及映射到 response.selector.xpath() 、 response.selector.css() 的
快捷方法(shortcut): response.xpath() 和 response.css() 。
关于在scrapy中使用xpath的更多相关文章
- [ 转 ] scrapy 中解决 xpath 中的中文编码问题
1.问题描述: 实现定位<h2>品牌</h2>节点 brand_tag = sel.xpath("//h2[text()= '品牌']") 报错:Value ...
- scrapy中的xpath用法和css的用法
css 不包含那个类 response.css(".list-left dd:not(.page)") 获取属性和文本 img.css("a::text").e ...
- 使用scrapy中xpath选择器的一个坑点
情景如下: 一个网页下有一个ul,这个ur下有125个li标签,每个li标签下有我们想要的 url 字段(每个 url 是唯一的)和 price 字段,我们现在要访问每个li下的url并在生成的请求中 ...
- 在Scrapy中如何利用Xpath选择器从HTML中提取目标信息(两种方式)
前一阵子我们介绍了如何启动Scrapy项目以及关于Scrapy爬虫的一些小技巧介绍,没来得及上车的小伙伴可以戳这些文章: 手把手教你如何新建scrapy爬虫框架的第一个项目(上) 手把手教你如何新建s ...
- python的scrapy框架的使用 和xpath的使用 && scrapy中request和response的函数参数 && parse()函数运行机制
这篇博客主要是讲一下scrapy框架的使用,对于糗事百科爬取数据并未去专门处理 最后爬取的数据保存为json格式 一.先说一下pyharm怎么去看一些函数在源码中的代码实现 按着ctrl然后点击函数就 ...
- 论Scrapy中的数据持久化
引入 Scrapy的数据持久化,主要包括存储到数据库.文件以及内置数据存储. 那我们今天就来讲讲如何把Scrapy中的数据存储到数据库和文件当中. 终端指令存储 保证爬虫文件的parse方法中有可迭代 ...
- scrapy中对于item的把控
其实很简单,就是想要存储的位置发生改变.直接看例子,然后触类旁通. 以大众点评 评论的内容为例 ,位置:http://www.dianping.com/shop/77489519/review_mor ...
- 15,scrapy中selenium的应用
引入 在通过scrapy框架进行某些网站数据爬取的时候,往往会碰到页面动态数据加载的情况发生如果直接用scrapy对其url发请求,是获取不到那部分动态加载出来的数据值,但是通过观察会发现,通过浏览器 ...
- scrapy中的selenium
引入 在通过scrapy框架进行某些网站数据爬取的时候,往往会碰到页面动态数据加载的情况发生,如果直接使用scrapy对其url发请求,是绝对获取不到那部分动态加载出来的数据值.但是通过观察我们会发现 ...
随机推荐
- Ajax——三种数据传输格式
一.HTML HTML由一些普通文本组成.如果服务器通过XMLHTTPRequest发送HTML,文本将存储在responseText属性中. 从服务器端发送的HTML的代码在浏览器端不需要用Java ...
- LoadRunner使用问题
最近给客户做POC,为了测试大数据的框架的一个并发能力,使用loadrunner进行相关的测试,目前发现几个要注意的地方 1: loadrunner的Java脚本必须使用jdk1.6的32位版本 2: ...
- 简单基础路径配置(单用JSP)EASYUI
<%@ page language="java" import="java.util.*" pageEncoding="UTF-8"% ...
- Appium混合应用测试
Appium测试混合应用 混合应用即是原生应用中间混着html页面,需要在两种类型的页面之间跳转. 测试Android混合应用 前期设置 4.4以下版本使用automationName:Selendr ...
- [web] [vscode] 自定义语言缩进
vscode 默认的html 语言的缩进有点过,貌似一个tab6个space, html看起来太空了,所幸的是可以自己调整单个语言的缩进模式. 方法如下 Preferences: Open User ...
- .NET架构转Java开发必须了解的历史
终于不在职守在.NET领域 .NET的winform和webform项目也开发了很多了 尤其是WEB领域 从ASP -> ASP.NET 2.0 -> ASP.NET MVC 4.0 - ...
- ZED 常用资料汇总
Calibration file Location: /usr/local/zed/settings/SN10027507.conf I suggest the calibration file sh ...
- F - ACboy needs your help again! (模拟)
ACboy was kidnapped!! he miss his mother very much and is very scare now.You can't image how dark th ...
- 趣图:快下班了,剩一个bug,修复一下再走
趣图:当我给老板展示我修复了那个 bug 时 趣图:当我以为这是最后一个Bug时……
- 【转】检索 COM 类工厂中 CLSID 为 {00024500-0000-0000-C000-000000000046} 的组件失败,原因是出现以下错误: 80070005 拒绝访问
源地址:https://www.cnblogs.com/love522/p/4462253.html 最近在做一个网站时,有一个下载word文档功能,在本地直接调试是可以下载的,但部署到IIS上就出现 ...