
15,scrapy中selenium的应用
引入
在通过scrapy框架进行某些网站数据爬取的时候,往往会碰到页面动态数据加载的情况发生如果直接用scrapy对其url发请求,是获取不到那部分动态加载出来的数据值,但是通过观察会发现,通过浏览器进行url请求发送则会加载出对应的动态加载的数据。那么如果我们想要在scrapy也获取动态加载出的数据,则必须使用selenium创建浏览器对象,然后通过该浏览器对象进行请求发送,获取动态加载的数据值。
1,案例分析:
- 需求:爬取网易新闻的国内板块下的新闻数据
- 需求分析:当点击国内超链接进入对应页面时,会发现当前页面展示的新闻数据是被动态加载出来的。需要我们使用selenium实例化一个浏览器对象,在该对象中进行url的请求,获取动态加载的数据。
2,selenium在scrapy中使用的原理分析:
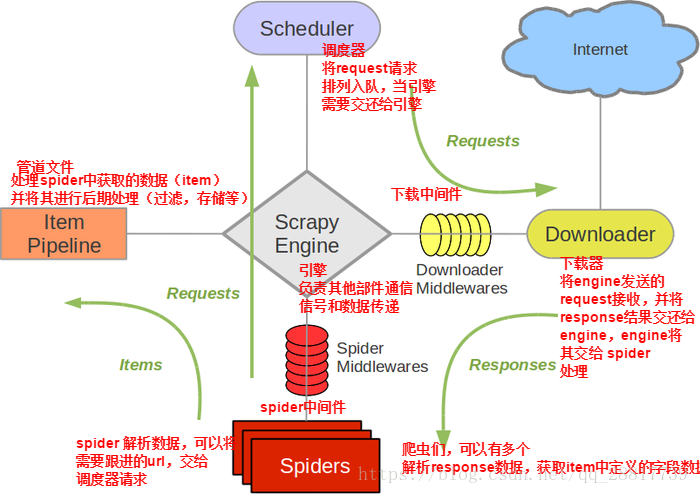
当引擎将国内板块url对应的请求提交给下载器后,下载进行网页数据的下载,然后将下载到的页面数据,封装到response中,提交给引擎,引擎将response在转交给Spiders。Spiders接收到的response对象中存储的页面数据里是没有动态加载的新闻数据的。要想获得动态数据,则需要在下载中间件中对下载器提交给引擎的response响应对象进行拦截,且对其内部存储的页面数据进行篡改,修改成携带了动态加载出的新闻数据,然后将被篡改的response对象最终交给Spiders进行解析操作。
3,selenium在scrapy中的使用流程:
- 重写爬虫文件的构造方法,在该方法中使用selenium实例化一个浏览器对象(因为浏览器对象只需要被实例化一次)
- 重写爬虫文件的closed(self,spider)方法,在其内部关闭浏览器对象。该方法是在爬虫结束时被调用
- 重写下载中间件中的process_response方法,让该方法对响应对象进行拦截,并篡改response中存储的页面数据
- 在配置文件中开启中间件
4,代码展示:
创建项目:
scrapy startproject wangyi

cd wangyi

scrapy genspider wangyinews http://war.163.com

scrapy crawl wangyinews 完成代码编写后运行项目
- 爬虫文件:
# -*- coding: utf-8 -*-

import scrapy

from selenium import webdriver

class WangyinewsSpider(scrapy.Spider):

    name = 'wangyinews'

    # allowed_domains = ['http://war.163.com/']

    start_urls = ['http://war.163.com/']

    def __init__(self):

        self.bro = webdriver.Chrome(executable_path=r'E:\Google\Google\Chrome\Application\chromedriver.exe')

    def parse(self, response):

        div_list = response.xpath('//div[@class="data_row news_article clearfix "]')

        for div in div_list:

            title = div.xpath('.//div[@class="news_title"]/h3/a/text()').extract_first()

            print(title)

    def closed(self, spider):

        print('关闭浏览器对象!')

        self.bro.quit()
- 中间件文件(只需要修改下载中间件的process_response函数)
from time import sleep

from scrapy import signals

from scrapy.http import HtmlResponse

 def process_response(self, request, response, spider):

        print('即将返回一个新的响应对象!!!')

        bro = spider.bro

        bro.get(url=request.url)

        sleep(3)

        page_text = bro.page_source

        sleep(3)

        return HtmlResponse(url=spider.bro.current_url,body=page_text, encoding='utf-8', request=request)
- setting文件
DOWNLOADER_MIDDLEWARES = {

   'wangyi.middlewares.WangyiDownloaderMiddleware': 543,

}
15,scrapy中selenium的应用的更多相关文章
- 15.scrapy中selenium的应用
引入 在通过scrapy框架进行某些网站数据爬取的时候,往往会碰到页面动态数据加载的情况发生,如果直接使用scrapy对其url发请求,是绝对获取不到那部分动态加载出来的数据值.但是通过观察我们会发现 ...
- scrapy中selenium的应用
引入 在通过scrapy框架进行某些网站数据爬取的时候,往往会碰到页面动态数据加载的情况发生,如果直接使用scrapy对其url发请求,是绝对获取不到那部分动态加载出来的数据值.但是通过观察我们会发现 ...
- scrapy中 selenium(中间件) + 语言处理 +mysql
在通过scrapy框架进行某些网站数据爬取的时候,往往会碰到页面动态数据加载的情况发生,如果直接使用scrapy对其url发请求,是绝对获取不到那部分动态加载出来的数据值.但是通过观察我们会发现,通过 ...
- 14 Scrapy中selenium的应用
在通过scrapy框架进行某些网站数据爬取的时候,往往会碰到页面动态数据加载的情况发生,如果直接使用scrapy对其url发请求,是绝对获取不到那部分动态加载出来的数据值.但是通过观察我们会发现,通过 ...
- selenium在scrapy中的使用、UA池、IP池的构建
selenium在scrapy中的使用流程 重写爬虫文件的构造方法__init__,在该方法中使用selenium实例化一个浏览器对象(因为浏览器对象只需要被实例化一次). 重写爬虫文件的closed ...
- Scrapy中集成selenium
面对众多动态网站比如说淘宝等,一般情况下用selenium最好 那么如何集成selenium到scrapy中呢? 因为每一次request的请求都要经过中间件,所以写在中间件中最为合适 from se ...
- 在Scrapy中使用selenium
在scrapy中使用selenium 在scrapy中需要获取动态加载的数据的时候,可以在下载中间件中使用selenium 编码步骤: 在爬虫文件中导入webdrvier类 在爬虫文件的爬虫类的构造方 ...
- selenium在scrapy中的应用
引入 在通过scrapy框架进行某些网站数据爬取的时候,往往会碰到页面动态数据加载的情况发生,如果直接使用scrapy对其url发请求,是绝对获取不到那部分动态加载出来的数据值.但是通过观察我们会发现 ...
- 第三百五十一节,Python分布式爬虫打造搜索引擎Scrapy精讲—将selenium操作谷歌浏览器集成到scrapy中
第三百五十一节,Python分布式爬虫打造搜索引擎Scrapy精讲—将selenium操作谷歌浏览器集成到scrapy中 1.爬虫文件 dispatcher.connect()信号分发器,第一个参数信 ...
随机推荐
- mysql查询索引
mysql在使用like查询中,能不能用到索引?在什么地方使用索引呢? 在使用like的时候,如果使用‘%%’,会不会用到索引呢? EXPLAIN SELECT * FROM `user` WHERE ...
- python基础之循环语句
一.if条件语句: 语法: 1.if单分支(单重条件判断) if expression: expr_true_suite 注释:expession为真执行代码expr_true_suite if单分支 ...
- flask之jinja2模板语言
一.jinja2简单介绍 Jinja2是Python里一个被广泛应用的模版引擎,他的设计思想来源于Django的模板引擎,并扩展了其语法和一系列强大的功能.其中最显著的一个是增加了沙箱执行功能和可选的 ...
- MATLAB之折线图、柱状图、饼图以及常用绘图技巧
MATLAB之折线图.柱状图.饼图以及常用绘图技巧 一.折线图 参考代码: %图1:各模式直接成本预测 %table0-table1为1*9的数组,记录关键数据 table0 = data_modol ...
- C/C++ sort函数的用法
sort函数的用法(#include<algorithm>) 做ACM题的时候,排序是一种经常要用到的操作.如果每次都自己写个冒泡之类的O(n^2)排序,不但程序容易超时,而且浪费宝贵的比 ...
- [opencv3.2cmake error ] sys/videoio.h no such file or directories
I don't have /usr/include/sys/videoio.h at all Before that , I have ipp download question. So I down ...
- spring boot 下 spring security 自定义登录配置与form-login属性详解
package zhet.sprintBoot; import org.springframework.beans.factory.annotation.Autowired;import org.sp ...
- 签证-L1/L2
http://blog.sina.com.cn/s/blog_7664b7f70102uweb.html 14年4月我接到公司通知,要从MICROSTRATEGY中国研发中心内部transfer到美国 ...
- php使用GD库实现图片水印和缩略图——生成图片缩略图
今天呢,就来学习一下在php中使用PD库来实现对图片水印的文字水印方法,不需要PS哦! 首先,准备素材 (1)准备一张图片 (2)准备一张水印(最好是透明的,即背景是白色底) (3)准备一中字体(在电 ...
- ES6中set和map的区别
Set ES6提供了新的数据结构Set.它类似于数组,但是成员的值都是唯一的,没有重复的值. Set函数可以接受一个数组(或类似数组的对象)作为参数,用来初始化. // 例一 var set = ne ...