
scrapy-splash抓取动态数据例子十四
一、介绍
本例子用scrapy-splash爬取超级TV网站的资讯信息,输入给定关键字抓取微信资讯信息。
给定关键字:数字;融合;电视
抓取信息内如下:
1、资讯标题
2、资讯链接
3、资讯时间
4、资讯来源
二、网站信息
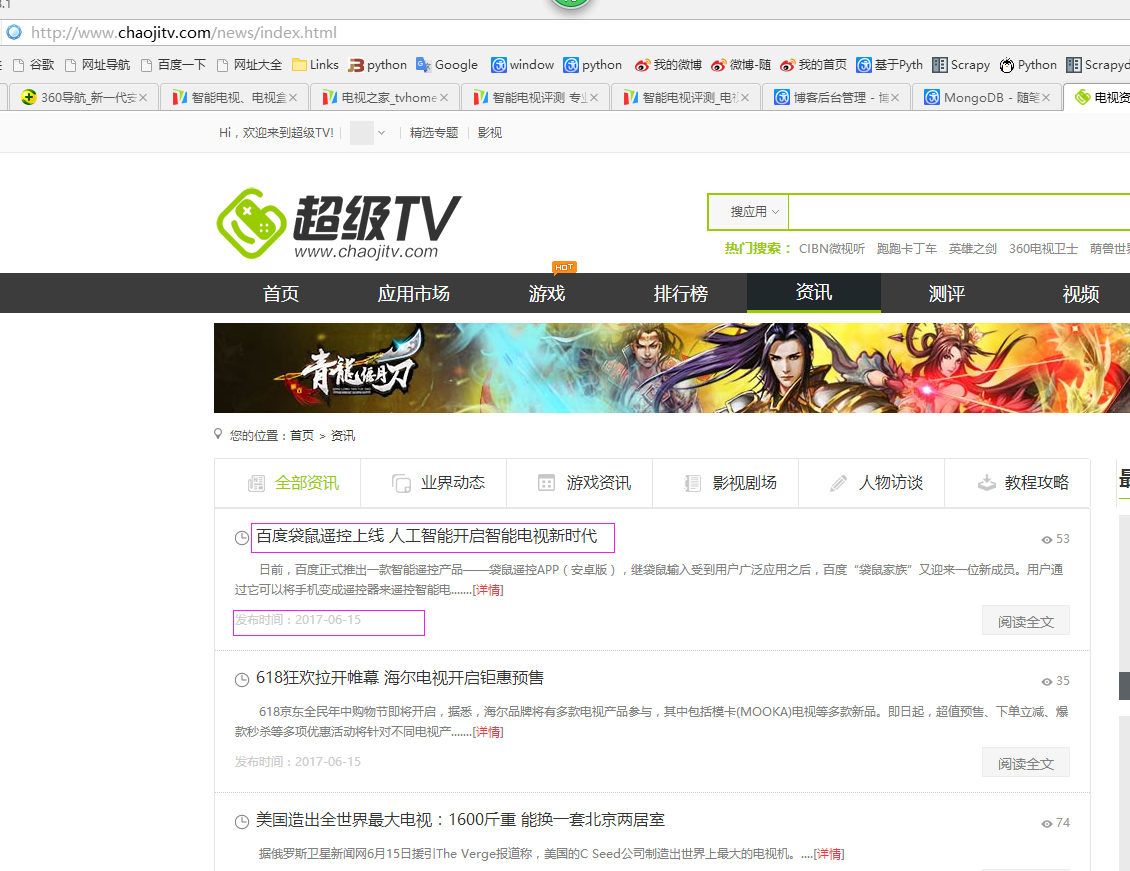
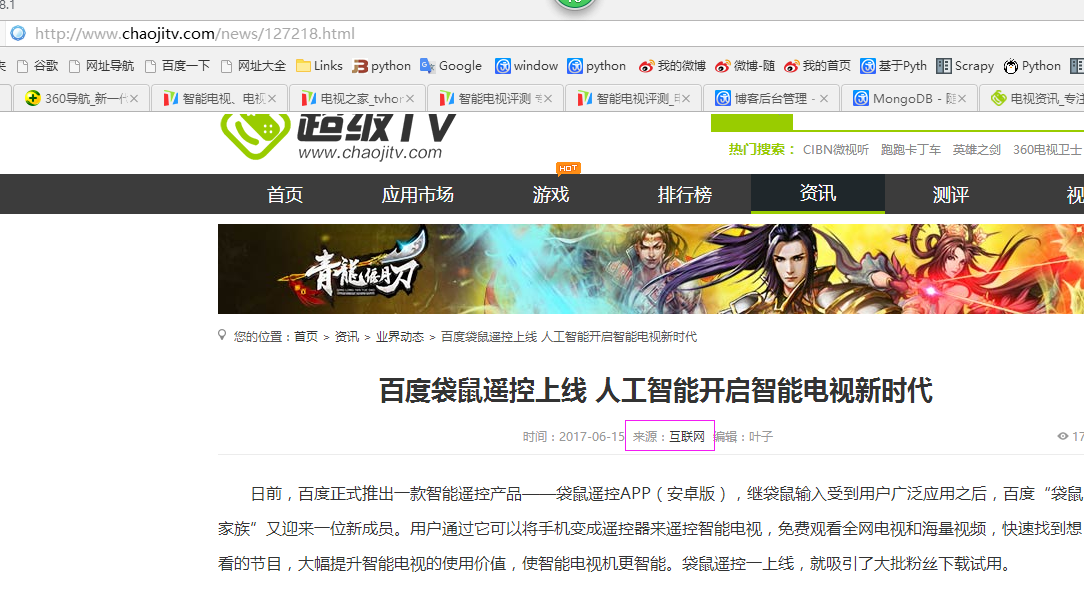
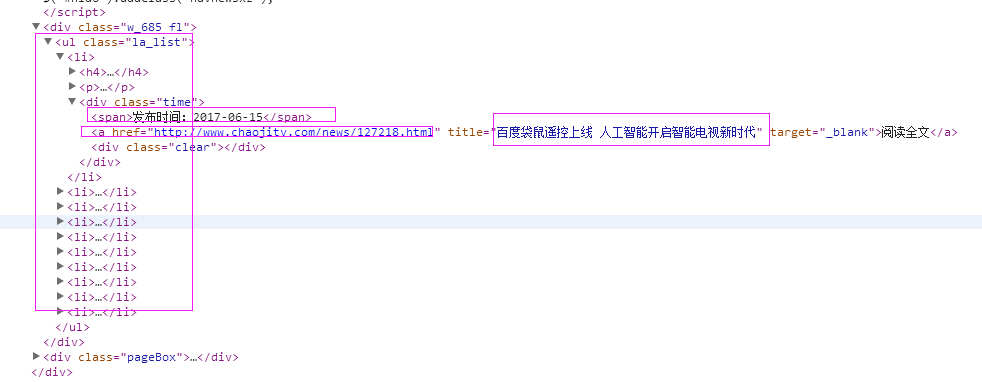
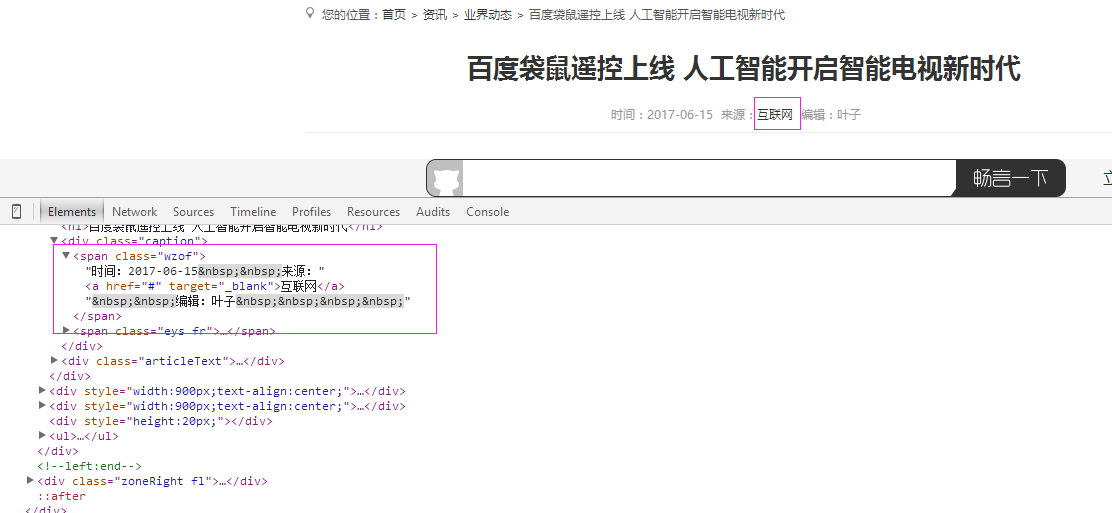

三、数据抓取
针对上面的网站信息,来进行抓取
1、首先抓取信息列表
抓取代码:sels = site.xpath('//ul[@class="la_list"]/li')
2、抓取标题
抓取代码:title = str(sel.xpath('.//h4/a/text()')[0].extract())
3、抓取链接
抓取代码:url = str(sel.xpath('.//h4/a/@href')[0].extract())
4、抓取日期
抓取代码:strdates = sel.xpath('.//div[@class="time"]/span/text()')
5、抓取来源
抓取代码:sources = site.xpath('//span[@class="wzof"]/a/text()');或sources = site.xpath('//span[@class="wzof"]/text()')
四、完整代码
# -*- coding: utf-8 -*-

import scrapy

from scrapy import Request

from scrapy.spiders import Spider

from scrapy_splash import SplashRequest

from scrapy_splash import SplashMiddleware

from scrapy.http import Request, HtmlResponse

from scrapy.selector import Selector

from scrapy_splash import SplashRequest

from scrapy_ott.items import SplashTestItem

from scrapy_ott.mongoDB import mongoDbBase

import scrapy_ott.IniFile

import sys

import os

import re

import time

reload(sys)

sys.setdefaultencoding('utf-8')

# sys.stdout = open('output.txt', 'w')

class chaojitvSpider(Spider):

    name = 'chaojitv'

    db = mongoDbBase()

    configfile = os.path.join(os.getcwd(), 'scrapy_ott\setting.conf')

    cf = scrapy_ott.IniFile.ConfigFile(configfile)

    information_wordlist = cf.GetValue("section", "information_keywords").split(';')

    websearchurl_list = cf.GetValue("chaojitv", "websearchurl").split(';')

    start_urls = []

    for url in websearchurl_list:

        start_urls.append(url)

    # request需要封装成SplashRequest

    def start_requests(self):

        for url in self.start_urls:

            yield SplashRequest(url

                                , self.parse

                                , args={'wait': ''}

                                )

    def Comapre_to_days(self,leftdate, rightdate):

        '''

        比较连个字符串日期,左边日期大于右边日期多少天

        :param leftdate: 格式:2017-04-15

        :param rightdate: 格式:2017-04-15

        :return: 天数

        '''

        l_time = time.mktime(time.strptime(leftdate, '%Y-%m-%d'))

        r_time = time.mktime(time.strptime(rightdate, '%Y-%m-%d'))

        result = int(l_time - r_time) / 86400

        return result

    def date_isValid(self, strDateText):

        '''

        判断日期时间字符串是否合法:如果给定时间大于当前时间是合法,或者说当前时间给定的范围内

        :param strDateText: 四种格式 '2小时前'; '2天前' ; '昨天' ;'2017.2.12 '

        :return: True:合法;False:不合法

        '''

        currentDate = time.strftime('%Y-%m-%d')

        datePattern = re.compile(r'\d{4}-\d{2}-\d{2}')

        strDate = re.findall(datePattern, strDateText)

        if len(strDate) == 1:

            if self.Comapre_to_days(currentDate, strDate[0]) <= 1:

                return True, strDate[0]

        return False, ''

    def parse(self, response):

        site = Selector(response)

        sels = site.xpath('//ul[@class="la_list"]/li')

        for sel in sels:

            strdates = sel.xpath('.//div[@class="time"]/span/text()')

            if len(strdates)>0:

                flag, date = self.date_isValid(str(strdates[0].extract()))

                if flag:

                    title = str(sel.xpath('.//h4/a/text()')[0].extract())

                    for keyword in self.information_wordlist:

                        if title.find(keyword) > -1:

                            url = str(sel.xpath('.//h4/a/@href')[0].extract())

                            yield SplashRequest(url

                                                , self.parse_item

                                                , args={'wait': ''},

                                                meta={'date': date, 'url': url,

                                                      'keyword': keyword, 'title': title}

                                                )

    def parse_item(self, response):

        site = Selector(response)

        it = SplashTestItem()

        it['title'] = response.meta['title']

        it['url'] = response.meta['url']

        it['date'] = response.meta['date']

        it['keyword'] = response.meta['keyword']

        sources = site.xpath('//span[@class="wzof"]/a/text()')

        if len(sources)>0:

            it['source'] = sources[0].extract()

        else:

            #时间:2017-06-15  来源:环球网  编辑:叶子

            sources = site.xpath('//span[@class="wzof"]/text()')

            if len(sources)>0:

                ss= str(sources[0].extract()).split(':')

                if len(ss)>2:

                    it['source']= ss[2].replace(u'编辑: ','').replace(' ','')

        self.db.SaveInformation(it)

        return it
scrapy-splash抓取动态数据例子十四的更多相关文章
- scrapy-splash抓取动态数据例子十六
一.介绍 本例子用scrapy-splash爬取梅花网(http://www.meihua.info/a/list/today)的资讯信息,输入给定关键字抓取微信资讯信息. 给定关键字:数字:融合:电 ...
- scrapy-splash抓取动态数据例子十五
一.介绍 本例子用scrapy-splash爬取电视之家(http://www.tvhome.com/news/)网站的资讯信息,输入给定关键字抓取微信资讯信息. 给定关键字:数字:融合:电视 抓取信 ...
- scrapy-splash抓取动态数据例子十二
一.介绍 本例子用scrapy-splash通过搜狗搜索引擎,输入给定关键字抓取资讯信息. 给定关键字:数字:融合:电视 抓取信息内如下: 1.资讯标题 2.资讯链接 3.资讯时间 4.资讯来源 二. ...
- scrapy-splash抓取动态数据例子十
一.介绍 本例子用scrapy-splash抓取活动行网站给定关键字抓取活动信息. 给定关键字:数字:融合:电视 抓取信息内如下: 1.资讯标题 2.资讯链接 3.资讯时间 4.资讯来源 二.网站信息 ...
- scrapy-splash抓取动态数据例子一
目前,为了加速页面的加载速度,页面的很多部分都是用JS生成的,而对于用scrapy爬虫来说就是一个很大的问题,因为scrapy没有JS engine,所以爬取的都是静态页面,对于JS生成的动态页面都无 ...
- scrapy-splash抓取动态数据例子八
一.介绍 本例子用scrapy-splash抓取界面网站给定关键字抓取咨询信息. 给定关键字:个性化:融合:电视 抓取信息内如下: 1.资讯标题 2.资讯链接 3.资讯时间 4.资讯来源 二.网站信息 ...
- scrapy-splash抓取动态数据例子七
一.介绍 本例子用scrapy-splash抓取36氪网站给定关键字抓取咨询信息. 给定关键字:个性化:融合:电视 抓取信息内如下: 1.资讯标题 2.资讯链接 3.资讯时间 4.资讯来源 二.网站信 ...
- scrapy-splash抓取动态数据例子六
一.介绍 本例子用scrapy-splash抓取中广互联网站给定关键字抓取咨询信息. 给定关键字:打通:融合:电视 抓取信息内如下: 1.资讯标题 2.资讯链接 3.资讯时间 4.资讯来源 二.网站信 ...
- scrapy-splash抓取动态数据例子五
一.介绍 本例子用scrapy-splash抓取智能电视网网站给定关键字抓取咨询信息. 给定关键字:打通:融合:电视 抓取信息内如下: 1.资讯标题 2.资讯链接 3.资讯时间 4.资讯来源 二.网站 ...
随机推荐
- Google Intern
申请 事情应该从去年(2013)说起,好基友从百度离职跳到了Google,回学校打印本科成绩单,然后晚上在scuacm群里,结果Dr. zuo问我想去实习么,正好有学长可以内推. 于是乎写了简历,然后 ...
- (转)Git冲突:commit your changes or stash them before you can merge. 解决办法
用git pull来更新代码的时候,遇到了下面的问题: error: Your local changes to the following files would be overwritten by ...
- maven自动建立目录骨架
maven提供archetype插件,用于创建符合maven规定的目录骨架. 方式一: 命令行执行mvn archetype:generate,在回显中依次写入如下参数: 执行完成会自动的生成响应的标 ...
- 【反演复习计划】【bzoj2154】Crash的数字表格
膜拜cdc……他的推导详细到我这种蒟蒻都能看得懂! 膜拜的传送门 所以我附一下代码就好了. #include<bits/stdc++.h> #define N 10000005 #defi ...
- .NET中类和结构的区别
类:类是引用类型在堆上分配,类的实例进行赋值只是复制了引用,都指向同一段实际对象分配的内存类有构造和析构函数类可以继承和被继承结构:结构是值类型在栈上分配(虽然栈的访问速度比较堆要快,但栈的资源有限放 ...
- k8s的Dashboard
前面章节 Kubernetes 所有的操作我们都是通过命令行工具 kubectl 完成的.为了提供更丰富的用户体验,Kubernetes 还开发了一个基于 Web 的 Dashboard,用户可以用 ...
- hdu 1422(贪心)
重温世界杯 Time Limit : 2000/1000ms (Java/Other) Memory Limit : 65536/32768K (Java/Other) Total Submiss ...
- 在WINDOWS2008 Server 中创建NFS服务器,使用LINUX的MOUNT命令去加载网络盘
1.在WINDOWS服务器中创建NFS SERVER 首先,打开服务管理器,选择添加角色: 选中文件服务,下一步: 出现一个提示,不管它,继续下一步: 在接下来的页面中选中“网 ...
- Jstorm草草配置
今天帮同事调试一个双节点的Jstorm测试集群. UI界面总是不能出现集群的具体信息. 参考几个URL调了一下.搞定了. 收获以下知识点: 1,UI是在storm.yaml里配置的 2,Jstorm分 ...
- 开源的图像滤镜库----for Android
1.GPUImage for Android(推荐使用) GPUImage基于OpenGL实现的各种各样图像滤镜(图像处理)效果,多达50多种, idea源于GPUImage for iOS,基本囊括 ...