
Spark操作parquet文件
 package code.parquet

 import java.net.URI

 import org.apache.hadoop.conf.Configuration

 import org.apache.hadoop.fs.{Path, FileSystem}

 import org.apache.spark.sql.{SaveMode, SparkSession}

 /**

   * Created by zhen on 2018/12/11.

   */

 object ParquetIO {

   // 指定hdfs根节点

   private val hdfsRoot = "hdfs://172.20.32.163:8020"

   // 获取HDFS路径

   def getPath(path: String): Path = {

     if (path.toLowerCase().startsWith("hdfs://")) {

       new Path(path)

     } else {

       new Path(hdfsRoot + path)

     }

   }

   def main(args: Array[String]) {

     val spark = SparkSession.builder().appName("parquet").master("local[2]").getOrCreate()

     spark.sparkContext.setLogLevel("WARN") // 设置日志级别为WARN

     val fsUri = new URI(hdfsRoot)

     val fs = FileSystem.get(fsUri, new Configuration())

     val path = hdfsRoot + "/YXFK/compute/KH_JLD"

     val has = fs.exists(getPath(path))

     if(has){

       // 读取hdfs文件系统parquet数据

       val dataFrame = spark.read.parquet(path)

       dataFrame.show(10)

       // 筛选,过滤数据

       val result = dataFrame.select("JLDBH", "JLDDZ", "JLDMC", "JLFSDM", "CJSJ")

         .filter("JLDDZ is not null AND JLFSDM = 3")

         .sort("JLDBH")

       result.show(10)

       // 写入部分数据到本地

       result.write.mode(SaveMode.Overwrite).parquet("E:\\result")

     }

     // 读取本地parquet数据

     val localDataFrame = spark.read.parquet("E:\\jld.parquet")

     localDataFrame.show(10)

     // 读取写入数据验证

     val resultSpace = spark.read.parquet("E:\\result")

     resultSpace.show(10)

   }

 }
结果:
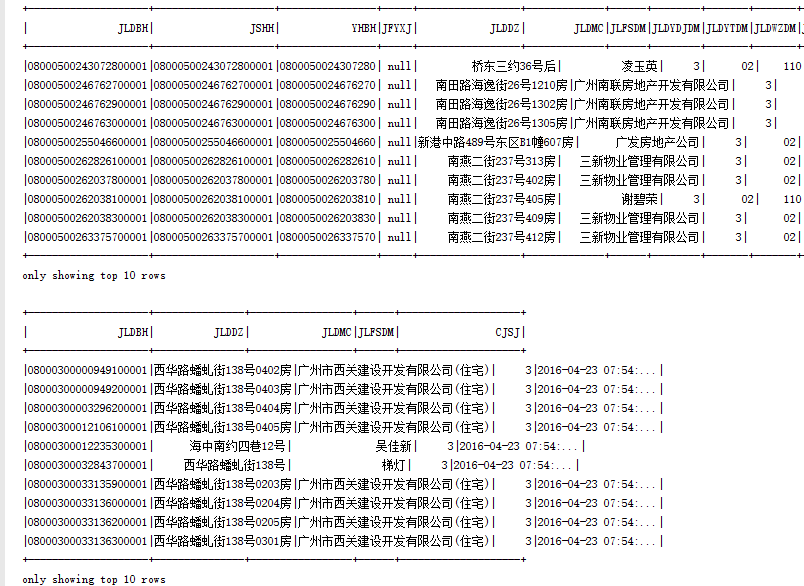
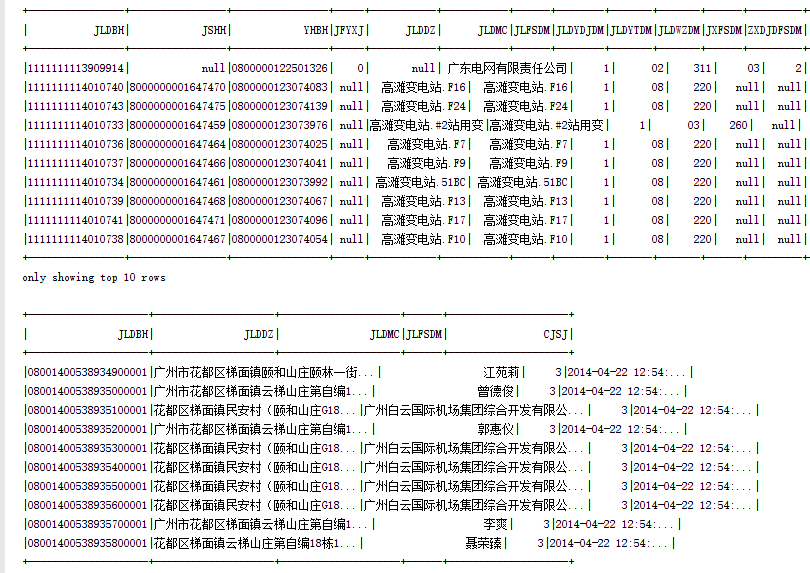
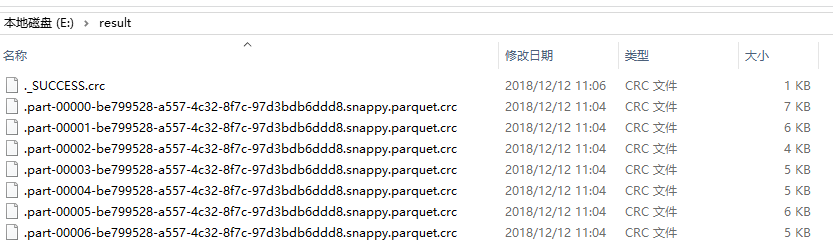
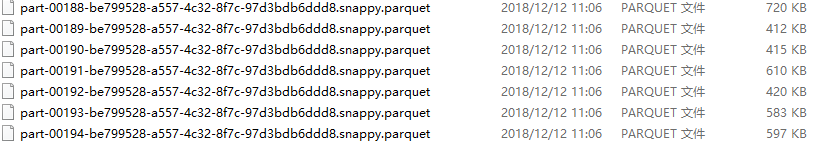
分析:Spark读取parquet数据默认为目录,因此可以只指定到你要读取的上级目录即可(本地模式除外),当保存为parquet时,会自动拆分,因此只能指定为上级目录。

Spark操作parquet文件的更多相关文章
- python读取hdfs上的parquet文件方式
在使用python做大数据和机器学习处理过程中,首先需要读取hdfs数据,对于常用格式数据一般比较容易读取,parquet略微特殊.从hdfs上使用python获取parquet格式数据的方法(当然也 ...
- Spark SQL读parquet文件及保存
import org.apache.spark.{SparkConf, SparkContext} import org.apache.spark.sql.{Row, SparkSession} im ...
- 大数据:Parquet文件存储格式
一.Parquet的组成 Parquet仅仅是一种存储格式,它是语言.平台无关的,并且不需要和任何一种数据处理框架绑定,目前能够和Parquet适配的组件包括下面这些,可以看出基本上通常使用的查询引擎 ...
- 大数据:Parquet文件存储格式【转】
一.Parquet的组成 Parquet仅仅是一种存储格式,它是语言.平台无关的,并且不需要和任何一种数据处理框架绑定,目前能够和Parquet适配的组件包括下面这些,可以看出基本上通常使用的查询引擎 ...
- Spark SQL 小文件问题处理
在生产中,无论是通过SQL语句或者Scala/Java等代码的方式使用Spark SQL处理数据,在Spark SQL写数据时,往往会遇到生成的小文件过多的问题,而管理这些大量的小文件,是一件非常头疼 ...
- Spark操作hbase
于Spark它是一个计算框架,于Spark环境,不仅支持单个文件操作,HDFS档,同时也可以使用Spark对Hbase操作. 从企业的数据源HBase取出.这涉及阅读hbase数据,在本文中尽快为了尽 ...
- scala读取parquet文件
import org.apache.spark.SparkConfimport org.apache.spark.SparkContextimport org.apache.spark.sql.SQL ...
- Spark操作实战
1. local模式 $SPARK_HOME/bin/spark-shell --master local import org.apache.log4j.{Level,Logger} // 导入ja ...
- 大数据学习day20-----spark03-----RDD编程实战案例(1 计算订单分类成交金额,2 将订单信息关联分类信息,并将这些数据存入Hbase中,3 使用Spark读取日志文件,根据Ip地址,查询地址对应的位置信息
1 RDD编程实战案例一 数据样例 字段说明: 其中cid中1代表手机,2代表家具,3代表服装 1.1 计算订单分类成交金额 需求:在给定的订单数据,根据订单的分类ID进行聚合,然后管理订单分类名称, ...
随机推荐
- Python Selenium 常用方法总结(不断补充)
还有此篇内容也丰富Selenium常见元素定位方法和操作的学习介绍 selenium Python 总结一些工作中可能会经常使用到的API. 1.获取当前页面的Url 方法:current_url 实 ...
- Linux安全配置
注释掉系统不需要的用户和用户组 vi /etc/passwd #adm:x:3:4:adm:/var/adm:/sbin/nologin #lp:x:4:7:lp:/var/spool/lpd:/sb ...
- Gradle安装使用以及基本操作
这两天看到越来越多的在接触Gradle,然后发现我之前没有做过记录,而且之后下个月的一些有关SpringBoot的东西也需要用到,所以这里就来记录一下,方便以后使用. 简单介绍 Gradle是一个好用 ...
- Ajax 上传input type file 文件
Html: <div class="attach-img"> <label><input type="file" id=" ...
- spring-session用redis实现session共享实践
什么是spring session? Spring Session provides an API and implementations for managing a user’s session ...
- Go语言远程执行ssh命令简单封装(支持带交互命令)
使用包:golang.org/x/crypto/ssh 以下封装一个发送命令的Cli结构体 type Cli struct { IP string //IP地址 Username string //用 ...
- Perl使用模块和@INC
use加载模块 安装模块后,都会有对应的文档,可以通过perldoc MODULE_NAME来获取模块的使用帮助. 例如:获取File::Utils的使用帮助. perldoc File::Utils ...
- python模块之shutil
shutil是一个用于简化文件操作的模块. 复制文件(传入源文件对象和目标文件对象) import shutil f1 = open(r'/Users/jingxing/PycharmProjects ...
- C# 使用 PerformanceCounter 获取 CPU 和 硬盘的使用率
C# 使用 PerformanceCounter 获取 CPU 和 硬盘的使用率: 先看界面: 建一个 Windows Form 桌面程序,代码如下: using System; using Sys ...
- webpack-dev-server不是内部或外部命令
参考:https://segmentfault.com/q/1010000006939078 错误报告:webpack-dev-server不是内部或外部命令 错误原因: 当执行命令: npm run ...