
05 过拟合(over-fitting)与正则化(regularization)
1. 什么是Overfitting
我们希望神经网络模型能够找到数据集中的一般规律,从而帮助我们预测未知数据。这个过程是通过不断地迭代优化损失函数(也就是预测值和实际值的误差)而实现的。然而随着误差进一步缩小,模型的“走势”过于“贴合”我们的训练数据,对训练数据中的噪声也过于趋近,把这些噪声数据也学进了模型当中。这时候,该模型承载的就不再是“一般规律”,而是把所有数据几乎“记忆”了下来。当我们用这种模型去预测未知数据时,会发现误差非常大。这种模型过于“贴合”训练数据的情况,就叫做过拟合(Overfitting)。
下图展示了回归任务和分类任务的三种不同拟合情况:
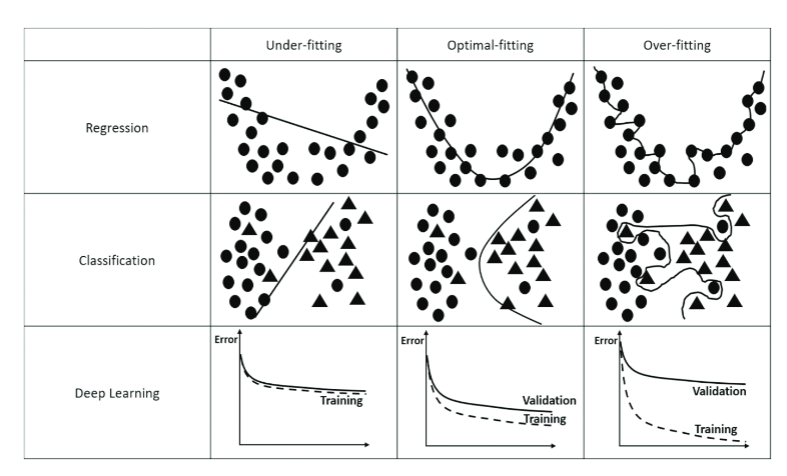
(Meedeniya, Dulani. Deep Learning: A Beginners’ Guide. 1st ed. New York: Chapman and Hall/CRC, 2023.)
Overfitting的表现,一般是在训练数据上表现优异,但在未见过的新数据上表现显著下降。因此,我们通常将所有数据集分成训练集和测试集,用训练集训练模型,用测试集验证模型是否发生过拟合。
上图中,在Underfitting时,模型几乎没有学习到数据的一般规律,此时训练集的误差和测试集的误差都很大;在Overfitting时,模型过于“贴合”训练数据,导致把噪声内容也学习到模型当中,此时模型虽然在训练集上误差很小,但在测试集上表现很差;理想情况应该是模型学习到数据的一般规律,在训练集和测试集上表现良好。
2. Overfitting的原因
模型过于复杂
当模型的参数增多,层数加深时,模型表达能力也在提升,但当表达能力远超数据真实规律时,就更容易学习到训练数据中的噪声、异常值或特定细节,而非学习到数据背后的通用规律。
数据量不足 质量低劣
当训练样本过少时,模型难以捕捉数据的整体分布,反而把局部的噪声当作规律。
训练策略不当
在模型训练时,训练集的误差随着优化过程不断地缩小,如果训练迭代次数过多,就会使得模型过于“贴合”训练数据,导致在测试集上误差加大。
3. 如何处理overfitting
正则化(Regularization)的定义
正则化是一类提升模型泛化能力的技术,其核心目标是抑制模型对训练数据中噪声、异常值或局部特征的过度依赖,从而缓解过拟合现象。所谓泛化能力,是把在已知数据中学习到的潜在规律(知识)迁移到未知数据上的能力。泛化能力好,则模型应用到未知数据上也能进行很好的预测;泛化能力差,则模型不能很好的对未知数据进行预测。一切提升模型泛化能力的方法都可以称为正则化方法。
通过上文中Overfitting原因介绍,我们很容易对症下药,从调整训练策略、降低模型复杂度、增强数据三个面找到处理Overfitting的方法:
early stopping
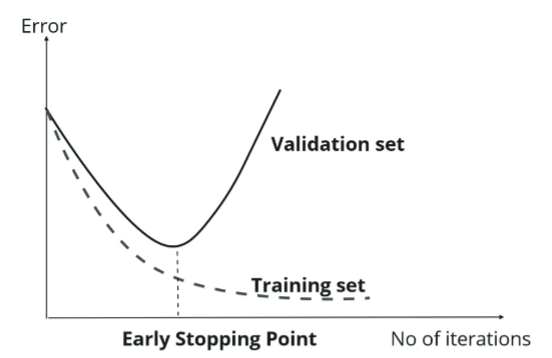
正则化最简单的方式,就是提前结束训练。在优化迭代的进行过程中,训练集数据的误差会持续降低,而验证集上的误差则会经历一个初始的下降阶段后达到一个转折点。过了这个转折点,模型开始出现过拟合现象,导致验证集上的误差转而上升。因此,我们在这个拐点处就停止迭代,以此来有效避免模型的过拟合问题。
dropout
在训练时随机“丢弃”(临时屏蔽)一部分神经元,迫使网络不依赖特定神经元,增强泛化能力。这本质上是一种降低模型复杂度的方法。这种随机的丢弃是指在每次迭代均屏蔽不同的神经元,确保模型在不同训练批次中接触不同的子网络结构。
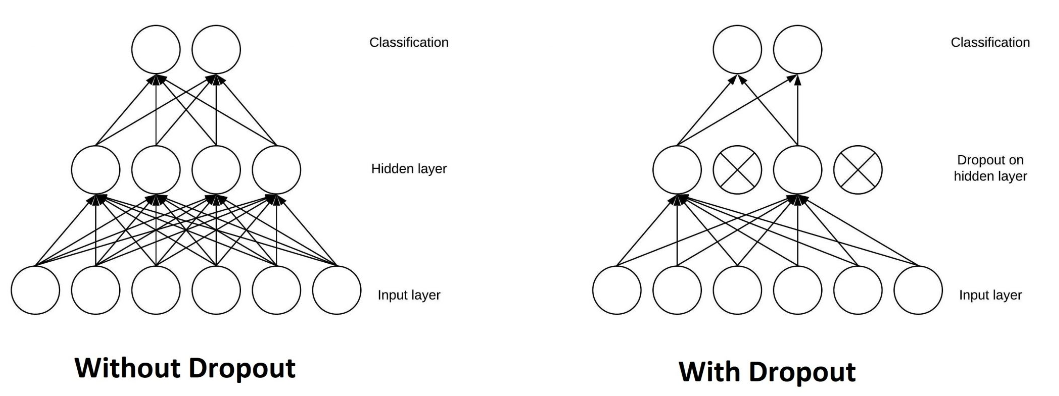
具体实现方法是:在训练阶段,每个神经元以概率p被保留,以1-p的概率被临时屏蔽(输出置零)。屏蔽过程通过生成与神经元输出维度相同的随机掩码矩阵实现,矩阵元素以概率p取1,其余取0。保留的神经元输出乘以1/p,这是为了保证整体流入下一层的信号强度不变。
示例:若某层有1000个神经元,保留概率p=0.7,则每次迭代约300个神经元被屏蔽,剩余700个输出放大至1/0.7≈1.428倍
在反向传播时,该层神经元的梯度也要乘以这个掩码矩阵,保证其对应的权重不得到更新。
在测试时,将所有神经元保留,来测试整体模型能力。
L1,L2正则化
L1正则化(Lasso):在损失函数中添加参数的绝对值之和作为惩罚项:
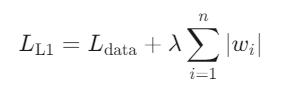
其中,\(L_{data}\)为原始损失函数(如均方误差),λ为正则化强度参数。
L2正则化(Ridge):在损失函数中添加参数的平方和作为惩罚项:
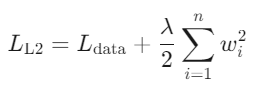
注意L2正则化常包含系数1/2以简化梯度计算。
我们看损失函数添加了正则项之后对梯度的影响:
L1的梯度更新:
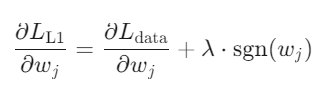
符号函数\(sgn(w_j)\)导致参数每次更新固定步长(如±λ),当w为正时,更新后w会变小;w为负时,更新后w会变大。w最终可能收敛到0,从而降低模型复杂度。
L2的梯度更新:
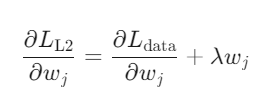
参数更新幅度与当前值成正比,参数逐渐衰减但不会归零。通过限制权重幅度,L2正则化实质降低了模型的“容量”,使其无法过度关注训练数据中的细微波动,从而更关注主要规律。
L1、L2对比:
L1正则化鼓励模型参数稀疏化(即产生很多零值参数),通过稀疏性自动筛选重要特征,适用于高维数据(如基因数据、文本分类)。而L2正则化则使模型参数趋近于零,但并不产生完全稀疏的模型。
L1正则化倾向于将无关特征权重设置为零,对于异常值较为鲁棒;而L2正则化则对所有参数进行平滑处理,防止模型对单一特征过度敏感,有一定的抑制噪声作用。
从计算角度来看,L2正则化由于目标函数可导,优化过程更稳定。
数据增强
增加训练数据量,或通过对训练数据进行随机变换(如旋转、缩放、平移等)来增加数据多样性。
05 过拟合(over-fitting)与正则化(regularization)的更多相关文章
- (五)用正则化(Regularization)来解决过拟合
1 过拟合 过拟合就是训练模型的过程中,模型过度拟合训练数据,而不能很好的泛化到测试数据集上.出现over-fitting的原因是多方面的: 1) 训练数据过少,数据量与数据噪声是成反比的,少量数据导 ...
- [DeeplearningAI笔记]改善深层神经网络1.4_1.8深度学习实用层面_正则化Regularization与改善过拟合
觉得有用的话,欢迎一起讨论相互学习~Follow Me 1.4 正则化(regularization) 如果你的神经网络出现了过拟合(训练集与验证集得到的结果方差较大),最先想到的方法就是正则化(re ...
- CS229 5.用正则化(Regularization)来解决过拟合
1 过拟合 过拟合就是训练模型的过程中,模型过度拟合训练数据,而不能很好的泛化到测试数据集上.出现over-fitting的原因是多方面的: 1) 训练数据过少,数据量与数据噪声是成反比的,少量数据导 ...
- zzL1和L2正则化regularization
最优化方法:L1和L2正则化regularization http://blog.csdn.net/pipisorry/article/details/52108040 机器学习和深度学习常用的规则化 ...
- 7、 正则化(Regularization)
7.1 过拟合的问题 到现在为止,我们已经学习了几种不同的学习算法,包括线性回归和逻辑回归,它们能够有效地解决许多问题,但是当将它们应用到某些特定的机器学习应用时,会遇到过拟合(over-fittin ...
- 数据的平面拟合 Plane Fitting
数据的平面拟合 Plane Fitting 看到了一些利用Matlab的平面拟合程序 http://www.ilovematlab.cn/thread-220252-1-1.html
- 斯坦福第七课:正则化(Regularization)
7.1 过拟合的问题 7.2 代价函数 7.3 正则化线性回归 7.4 正则化的逻辑回归模型 7.1 过拟合的问题 如果我们有非常多的特征,我们通过学习得到的假设可能能够非常好地适应训练集( ...
- [笔记]机器学习(Machine Learning) - 03.正则化(Regularization)
欠拟合(Underfitting)与过拟合(Overfitting) 上面两张图分别是回归问题和分类问题的欠拟合和过度拟合的例子.可以看到,如果使用直线(两组图的第一张)来拟合训,并不能很好地适应我们 ...
- 防止过拟合:L1/L2正则化
正则化方法:防止过拟合,提高泛化能力 在训练数据不够多时,或者overtraining时,常常会导致overfitting(过拟合).其直观的表现如下图所示,随着训练过程的进行,模型复杂度增加,在tr ...
- [C3] 正则化(Regularization)
正则化(Regularization - Solving the Problem of Overfitting) 欠拟合(高偏差) VS 过度拟合(高方差) Underfitting, or high ...
随机推荐
- [转]关于c#中遍历从数据库中取出的DataTable集合
作为刚进入c#语言不久的小白,我们需要掌握的基本操作之DataTable集合.首先你需要一个sql语句,这里我就不写了,但是这里要注意,这个sql语句的目的是查出你需要的一张数据表,这个时候才会用到D ...
- 1. C++快速入门--变量和基本类型, 类别
文章使用obsidian编写, 双链部分可能失效 1 基本内置类型 1.1 算术类型 算术类型介绍 bool 类型 字符类型 整数类型 实数浮点.虚数浮点和 复数浮点 参看如下表 带符号和无符号类型的 ...
- CDS标准视图:催款代码描述 I_DunningKeyText
视图名称:催款代码描述 I_DunningKeyText 视图类型: 视图代码: 点击查看代码 @EndUserText.label: 'Dunning Key - Text' @Analytics. ...
- IT审计(ITAC)问题:SAP系统销售流程对于发货单和销售发票容差的配置
IT审计(ITAC)问题:SAP系统销售流程对于发货单和销售发票容差的配置 起因: 在ITAC审计的时候,针对销售流程的控制,问了两个问题 SAP系统销售流程的发货单和销售发票基于销售订单生成的相关配 ...
- nginx里面的路径定位关键词root、alias
nginx里面的路径定位关键词root.alias是有区别的: 设置请求资源的目录root / alias root:设置请求的根目录 语法 root path; 默认值 root html; 位置 ...
- Linux下mysql的二进制安装与部分练习
鲸英训练营 0531作业 一.单选题(每题5分,总分25分) 1. 在MySQL中,一般使用( A )语句来指定一个已有数据库作为当前工作数据库. A.USED B.USE C.BEGIN D.GO ...
- Collection接口方法
Collection 接口继承树 Collection 接口Collection 接口是 List.Set 和 Queue 接口的父接口,该接口里定义的方法既可用于操作 Set 集合,也可用于操作 ...
- 搭建基于Grafana+JMeter+InfluxDB的性能监控与分析平台(Linux)
搭建基于Grafana+JMeter+InfluxDB的性能监控与分析平台(Linux版) 在软件开发和运维领域,性能监控与分析是确保应用稳定性和用户体验的关键环节.随着应用规模的不断扩大和复杂度的增 ...
- Q:浏览器不能上网,但是可以ping通外网ip,dns配置也没问题(TCP/IP 无法建立传出连接)
问题症状 每隔一段时间,浏览器不能访问外网,重启电脑又正常,重置网卡无效 可以ping通外网ip地址,可以ping通外网域名 ping不通外网端口端口 查看日志 每次出现不能上网情况时都会有至少两条T ...
- 一分钟搞定!CentOS 7.9上用Ansible自动化部署SQL Server 2019
一分钟搞定!CentOS 7.9上用Ansible自动化部署SQL Server 2019 不熟悉整个流程的朋友可以先看之前的部署文章,手动部署一遍 一步步教你在CentOS 7.9上安装SQL Se ...