
梯度下降(HGL)
线性回归:是利用数理统计中回归分析,来确定两种或两种以上变量间相互依赖的定量关系的一种统计分析方法。
对于一般训练集:


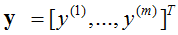
参数系统为:

线性模型为:

损失函数最小的目标就是求解全局最小值,loss函数定义为

目标:min Φ(θ),loss函数最小。估计最优系数(θ0, θ1, θ2, …, θn)。
1. 梯度下降法(最速下降法)
顾名思义,梯度下降法的计算过程就是沿梯度下降的方向求解极小值。
具体过程如下(如图1所示):
- 首先对θ赋值,这个值可以是随机的,也可以让θ是一个全零的向量(初值的选择非常影响梯度下降算法的好与坏)。
- 改变θ的值,使得Φ(θ)按梯度下降的方向进行减少。
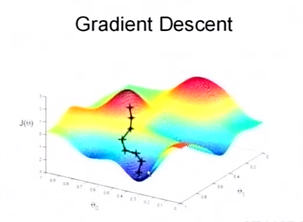
图1 梯度下降描述(来自于斯坦福大学,《机器学习》公开课[2])
过程2)可以表示为:

其中α为步长。
由于我们每进行一次参数更新需要计算整体训练数据的梯度,批量梯度下降会变得很慢,并且会遇到内存吃不下数据就挂了。同时批量梯度下降也无法支持模型的在线更新,例如,新的样本不停的到来。
2. SGD (随机梯度下降算法,Stochastic gradient descent)
在梯度下降中,对于θ的更新,所有的样本都有贡献,也就是参与调整θ,其计算得到的是一个标准梯度。如果数据量非常大,那么运算速度很慢。而随机梯度下降算法的随机也就是说我用样本中的一个例子来近似我所有的样本,来调整θ。这样速度更快,但是更容易陷入局部极小。随机梯度下降算法可以表示为:

每次只选用第i个样本
3. AdaGrad(自适应梯度,Adaptive Gradient)
自适应梯度与SGD类似,AdaGrad的更新速率是可变的。更新速率一定,不一定适合所有的更新阶段。所以AdaGrad调整的是Gradient,对于所有的参数,随着更新的总距离增多,学习速度随之变缓。可以表示为:

其中(θi)t是t步的参数,ε很小,保证非0。
缺点:学习率单调递减,训练后期学习率非常小;需要手动设置全局学习率;更新
θt时,左右两边单位不统一。
参考文献:Duchi, E. Hazan, and Y. Singer. Adaptive Subgradient Methods for Online Learning and Stochastic Optimization
4. AdaDelta
AdaDelta基本思想是用一阶的方法,近似模拟二阶牛顿法,是对AdaGrad的缺点进行改进。可表示为:
 ?
5. RMSprop
RMSprop和Adadelta是在差不多的时间各自独立产生的工作,目的都是为了缓解Adagrad的学习速率减少的问题。实际上RMSprop和我们在Adadelta中推到的第一个更新向量是相同的:


其中,ρ建议取0.9,α建议取0.001。
6. NAG
这个算法严格的说来是凸优化中的算法,具有O(1/t^2)的收敛率,收敛速度比较快。因为 DNN是一个non-convex的model,所以NAG方法并不能达到这个收敛速度。caffe文档中指出,这个方法对于某些deeplearning 的 architecture是非常有效的。与SGD类似,具体更新过程如下:


7. Adam(个人认为一般都合适的caffe的solver方法)
Adaptive Moment Estimation(Adam) 也是一种不同参数自适应不同学习速率方法,与Adadelta与RMSprop区别在于,它计算历史梯度衰减方式不同,不使用历史平方衰减,其衰减方式类似动量,如下[4]:


Wt与Vt分别是梯度的带权平均和带权有偏方差,初始为0向量,Adam的作者发现他们倾向于0向量(接近于0向量),特别是在衰减因子(衰减率)ρ1,ρ2接近于1时。为了改进这个问题,对Wt与Vt进行偏差修正(bias-corrected):
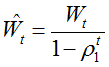

最终,Adam的更新方程为:

[1] http://www.cnblogs.com/denny402/
[2] http://open.163.com/movie/2008/1/M/C/M6SGF6VB4_M6SGHFBMC.html
[3] http://blog.sina.com.cn/s/blog_eb3aea990102v41r.html
[4] http://blog.csdn.net/heyongluoyao8/article/details/52478715?locationNum=7
梯度下降(HGL)的更多相关文章
- 梯度下降(Gradient Descent)小结
在求解机器学习算法的模型参数,即无约束优化问题时,梯度下降(Gradient Descent)是最常采用的方法之一,另一种常用的方法是最小二乘法.这里就对梯度下降法做一个完整的总结. 1. 梯度 在微 ...
- 从梯度下降到Fista
前言: FISTA(A fast iterative shrinkage-thresholding algorithm)是一种快速的迭代阈值收缩算法(ISTA).FISTA和ISTA都是基于梯度下降的 ...
- 线性回归、梯度下降(Linear Regression、Gradient Descent)
转载请注明出自BYRans博客:http://www.cnblogs.com/BYRans/ 实例 首先举个例子,假设我们有一个二手房交易记录的数据集,已知房屋面积.卧室数量和房屋的交易价格,如下表: ...
- 随机梯度下降(Stochastic gradient descent)和 批量梯度下降(Batch gradient descent )的公式对比、实现对比[转]
梯度下降(GD)是最小化风险函数.损失函数的一种常用方法,随机梯度下降和批量梯度下降是两种迭代求解思路,下面从公式和实现的角度对两者进行分析,如有哪个方面写的不对,希望网友纠正. 下面的h(x)是要拟 ...
- 为什么是梯度下降?SGD
在机器学习算法中,为了优化损失函数loss function ,我们往往采用梯度下降算法来进行优化.举个例子: 线性SVM的得分函数和损失函数分别为: ...
- Stanford大学机器学习公开课(二):监督学习应用与梯度下降
本课内容: 1.线性回归 2.梯度下降 3.正规方程组 监督学习:告诉算法每个样本的正确答案,学习后的算法对新的输入也能输入正确的答案 1.线性回归 问题引入:假设有一房屋销售的数据如下: 引 ...
- Matlab梯度下降解决评分矩阵分解
for iter = 1:num_iters %梯度下降 用户向量 for i = 1:m %返回有0有1 是逻辑值 ratedIndex1 = R_training(i,:)~=0 ; %U(i,: ...
- 机器学习(一):梯度下降、神经网络、BP神经网络
这几天围绕论文A Neural Probability Language Model 看了一些周边资料,如神经网络.梯度下降算法,然后顺便又延伸温习了一下线性代数.概率论以及求导.总的来说,学到不少知 ...
- 梯度下降之随机梯度下降 -minibatch 与并行化方法
问题的引入: 考虑一个典型的有监督机器学习问题,给定m个训练样本S={x(i),y(i)},通过经验风险最小化来得到一组权值w,则现在对于整个训练集待优化目标函数为: 其中为单个训练样本(x(i),y ...
随机推荐
- shell 脚本学习之内部变量
一,$BASH Bash的二进制程序文件的路径 二,$BASH_ENV 这个环境变量会指向一个Bash的启动文件, 当一个脚本被调用的时候, 这个启动文件将会被读取. 三,$BASH_SUBSHELL ...
- shell 函数与内置变量
1,特殊shell变量 $# 传递到脚本的参数个数 $* 以一个单字符串显示所有向脚本传递的参数 $$ 脚本运行的当前进程ID号 $! 后台运行的最后一个进程的ID号 $@ 与$*相同,但是使用时加引 ...
- poi 多行合并
poi做多行合并,一定需要先绘制单元格,然后写入数据,最后合并,不然各种坑啊. 合并单元格所使用的方法: sheet.addMergedRegion( CellRangeAddress cellRa ...
- java NIO之SelectedKey
SelectedKey是channel与Selector绑定的标记,每将一个channel注册到一个selector就会产生一个SelectedKey,并将这个SelectedKey放入到Select ...
- mongoDB cpu飙高问题
问题描述: 最近几天生产环境上的mongodb一直在报警,cpu飙高,其他如内存.iops.连接数.磁盘操作等都正常.通过定位业务,发现是由于mongodb的表其中一个查询未建立索引导致,110多W的 ...
- [转].NET Core之Entity Framework Core 你如何创建 DbContext
本文转自:http://www.cnblogs.com/tdws/p/5874212.html 本文版权归博客园和作者吴双共同所有,欢迎转载,转载和爬虫请注明博客园蜗牛原文地址 http://www. ...
- RocketMQ3.2.6安装部署及调用
RocketMQ3.2.6安装部署及调用 1.RocketMQ部署架构 所有IP都是127.0.0.1,其中NameServer一个,Broker一个,Producer一个,Consumer一个 2. ...
- 2、弹出窗口 Alert
1.只是弹出框 /* --- page1.html ---*/ <ion-navbar *navbar> <ion-title>Tab 1</ion-title> ...
- ExcelHelper office 导出
要是服务器上没有装着excel 可以用c#导出excel表吗 2009-08-10 17:36 风之成 | 分类:办公软件 | 浏览2279次 租用的空间 服务器上没有装着office excel,可 ...
- 冒泡排序——Java实现
一.排序思想 比较相邻的元素.如果第一个比第二个大,就交换他们两个. 对每一对相邻元素做同样的工作,从开始第一对到结尾的最后一对.在这一点,最后的元素应该会是最大的数. 针对所有的元素重复以上的步骤, ...