
batch normalization学习理解笔记
batch normalization学习理解笔记
最近在Andrew Ng课程中学到了Batch Normalization相关内容,通过查阅资料和原始paper,基本上弄懂了一些算法的细节部分,现在总结一下.
1. batch normalization算法思想的来源
不妨先看看原文的标题:Batch normalization:acclerating deep network training by reducing internal covariate shift.字面意思即:Batch Normalization算法是通过减小内部协变量偏移来加速深度神经网络训练.不难看出,作者明确指出Batch Normalization是一种加速深度神经网络训练的方法.什么原理呢,就是通过减小内部协变量偏移.原文中明确给出变量的定义:we refer to change in the distributions of internal nodes of a deep networks,in the course of training, as Internal Covariate Shift.其实意思就是神经网络内部layer的输入(即上一layer的输出)分布的变化.
Internal Covariate Shift的定义是相对于Covariate Shift而言的,Covariate Shift是指神经网络输入(X)分布发生改变的现象.大家都知道神经网络之所以具有泛化能力,一个基本的假设就是训练样本集与测试样本集是独立同分布的(iid),如果两者分布不同(或者说两者分布之间存在Covariate Shift现象),则网络的性能就没有了保证.而Internal Covariate Shift是将这一概念进行了扩展,神经网络内部上一层的输出传递给下一层作为输入,每一层的输入是否存在Covariate Shift现象呢,答案是显而易见的.因为在神经网络训练过程中,w,b等参数是一直进行调整的,导致网络的输出也是不断变化的,而这一层的输出将作为下一层的输入,即输入也是不断变化的,即神经网络内部也存在着Covariate Shift现象,这种神经网络内部的Covariate Shift现象,就称为Internal Covariate Shift.
Batch normalization的想法来源正式通过减小Internal Covariate Shift来加速网络训练.因为对于Covariate Shift现象,通过白化操作能起到改善作用,以此类推,将相似的操作引入神经网络内部,也能起到加速每一层训练的效果.
2. 如何进行Batch Normalization
首先想到了是同样在每层使用白化操作,但是白化操作有两个缺点:
- 一是白化计算量很大,因为白化过程中要计算随机向量的协方差矩阵,然后求逆运算(要使得输入向量各维度不相关),而且还要在每层中计算,这在深度神经网络中是十分费时的;
- 二是白化结果不能保证处处可微,不能保证后向梯度下降法的顺利进行.
因此文中进行了两个简化:
- 一是对输入向量的各个维度单独进行均值为0,方差为1的标准化处理,不进行去相关操作,这样就避免了协方差矩阵和矩阵求逆运算,这一操作也能起到加速训练的效果,已有文献作证.
- 二是结合深度神经网络训练常用的mini-batch,在计算均值和方差时利用一个mini-batch中的样本,而不是整个训练集中的样本.
同时,为了保证进行了归一化后的输入能够包含处理前的输入(即不会损失前层网络的训练成果),又添加了一个仿射变换,引入了两个网络学习的参数\(\gamma\)和\(\beta\).Batch Normalization的计算过程如下:
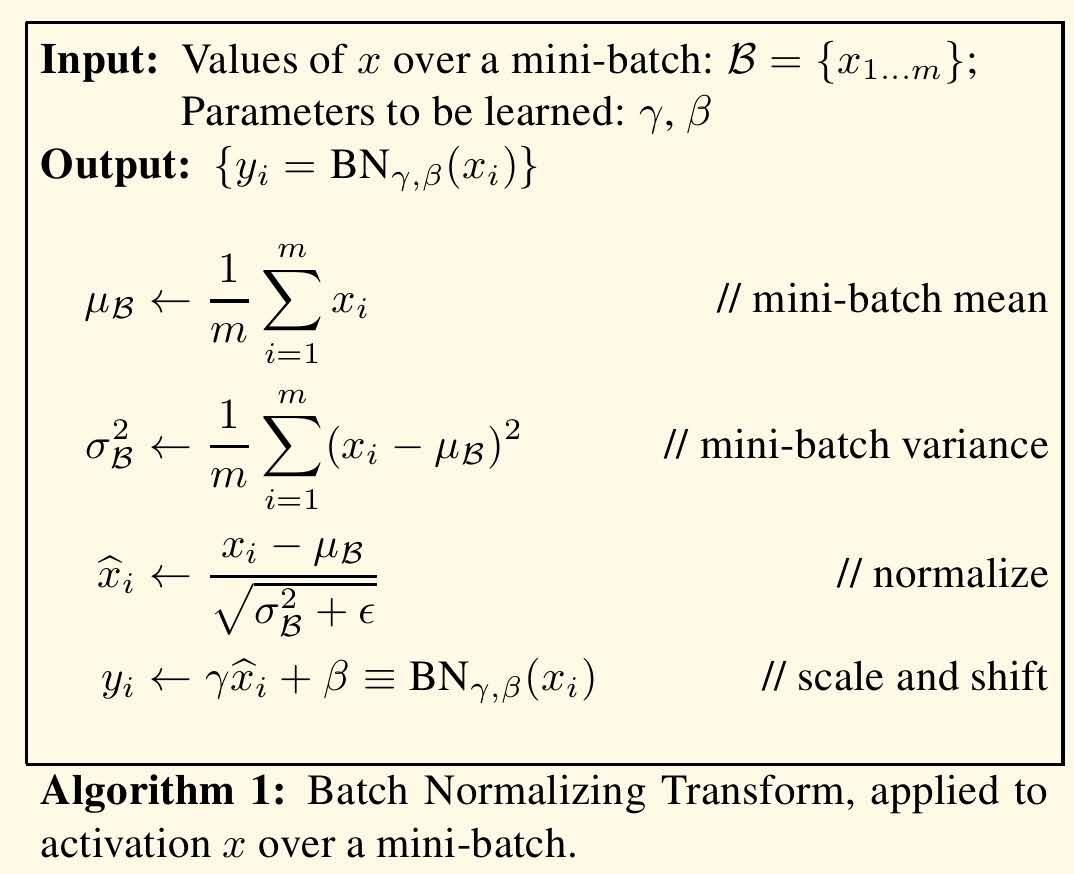
当\(\beta = \mu_B\),\(\gamma = \sqrt{\sigma^{2}_B+\varepsilon}\)时,\(y_i=x_i\),即Batch Normalization进行了恒等变换.
注意在测试过程中,当测试单个样本时,无法估计均值和方差,文中给出的解决办法是利用训练过程中mini-batch得到的均值和方差,求均值(指数加权平均)得到.具体的实现过程请参考原文献,此处不在累述.
3. Batch Normalization有那些作用
最主要的一点,也是原文中多次出现的就是加速网络训练,即达到相同的误差率,使用Batch Normalization可以大大减小所需要的迭代次数.
- 在原文试验中证实了,在原有网络结构中仅仅添加Batch Normalization,就可以大大加速网络的训练过程.个人认为有两点原因.一方面是因为经过Batch Normalization各层网络输入的均值和方差保持固定,因此后面的网络有了一个相对稳定的基础(Andrew Ng的观点),后面的网络减少了不断调整的过程;另外一点,经过归一化,输入向量各个维度保持了相同的尺度,这样也能加速后续网络的训练过程(类似于将原本椭圆状的损失函数变换为接近圆形的函数,即黑塞矩阵的条件数减小了)
- 另外,因为Batch Nomalization能够有效抑制梯度爆炸/消失问题,因此可以使用更大的学习率,用以加快训练.原文中对于使用更大的学习率进行了专门介绍:一般情况下,大的学习率会增加模型参数(W,b)的尺度,这在反向传播过程中会放大梯度,然后导致梯度爆炸问题.但是由于Batch Normalization能够使反向传播过程中梯度不受参数尺度的影响,因此可以有效防止这种问题的发生.对于一个尺度a,Batch Normalization过程具有以下特性:\[BN(Wu)=BN((aW)u)\]
其中W为模型参数,u为模型输入.上式的结果说明,Batch Normalization的结果不受模型参数尺度的影响,因为BN会对线性运算的输出进行归一化,即均值为0,方差为1,该过程会抵消掉a的影响.同时,对于传播过程,具有如下特性:\[\frac{\partial BN((aW)u)}{\partial u} = \frac{\partial BN(Wu)}{\partial u}\]
\[\frac{\partial BN((aW)u)}{\partial aW} = \frac{1}{a}\cdot\frac{\partial BN(Wu)}{\partial W}\]
上面第一个式子表明(用本节第一个等式替换即可得到),在反向传播过程中,梯度由本层向前一层传递时,梯度的大小不受模型参数尺度的影响.第二个式子表明,反向传播过程中,参数的尺度越大,其梯度越小,这可以抑制梯度增长过大.
其实,对于抑制深度神经网络中梯度消失/爆炸问题,采用的方法主要有使用relu激活函数,小心初始化模型参数等,BN同样提供了一种有力的工具.
原文中通过实验证明了BN可以有效防止非线性饱和问题,对于sigmoid激活函数,由于BN操作,可以避免输入落入梯度很小的两端范围内.
文中同样提到了BN自带一定的regularization作用,可以替代/减弱dropout的使用.这主要是因为平均是和方差为模型引入了随机误差,从而增添了不确定性.Andrew Ng认为,应该将BN的regulatization作用作为一种副作用,真正的正则化还是应该使用L2,dropout等通用方法.
batch normalization学习理解笔记的更多相关文章
- 深度学习(二十九)Batch Normalization 学习笔记
Batch Normalization 学习笔记 原文地址:http://blog.csdn.net/hjimce/article/details/50866313 作者:hjimce 一.背景意义 ...
- Batch Normalization 学习笔记
原文:http://blog.csdn.net/happynear/article/details/44238541 今年过年之前,MSRA和Google相继在ImagenNet图像识别数据集上报告他 ...
- 神经网络Batch Normalization——学习笔记
训练神经网络的过程,就是在求未知参数(权重).让网络搭建起来,得到理想的结果. 分类-监督学习. 反向传播求权重:每一层在算偏导数.局部梯度,链式法则. 激活函数: sigmoid仅中间段趋势良好 对 ...
- ASCII, Unicode, UTF-8, 8进制, 16进制等各种编码学习理解笔记
字符编码的发展历史 Unicode和UTF-8有何区别? 在这个问题下的于洋的最高票回答中,比较完整地介绍了字符编码的发展历史,为了便于记忆,再次简要概括一番. 一个字节:最初一个字节的标准是混乱的, ...
- angular 学习理解笔记
原文:https://github.com/eoinkelly/notes/blob/master/angular/book-building-web-apps-w-angular/angular.m ...
- 转载--对batch normalization的理解
转载的大神的: https://www.cnblogs.com/guoyaohua/p/8724433.html 上边这个应该是抄的下边这个原文,但是上边的有重点标记 https://blog.csd ...
- Deep Learning 27:Batch normalization理解——读论文“Batch normalization: Accelerating deep network training by reducing internal covariate shift ”——ICML 2015
这篇经典论文,甚至可以说是2015年最牛的一篇论文,早就有很多人解读,不需要自己着摸,但是看了论文原文Batch normalization: Accelerating deep network tr ...
- 神经网络之 Batch Normalization
知乎 csdn Batch Normalization 学习笔记 原文地址:http://blog.csdn.net/hjimce/article/details/50866313 作者:hjimce ...
- 优化深度神经网络(三)Batch Normalization
Coursera吴恩达<优化深度神经网络>课程笔记(3)-- 超参数调试.Batch正则化和编程框架 1. Tuning Process 深度神经网络需要调试的超参数(Hyperparam ...
随机推荐
- C#中DBNull问题
当数据库中一个字段不是必填项时,在往数据库中插入数据的时候往往会插入一个空字符串就草草了事了.在这里用DBNull可以解决这个问题 /// <summary> /// 插入数据 /// & ...
- DWR框架在web.xml的完整配置及注释
<!-- 配置DWR框架 --> <servlet> <servlet-name>dwr</servlet-name> <servlet-clas ...
- 当接口上配了 FeignClient 和 RequestMapping 两个注解,结果错误提示 重复mapping处理方法
再接手老文档的时候,发现有这么一个问题 错误显示为: 原文档写法: 解决方法: 这是一个编译时写法的问题,将上方的RequestMapping去掉,然后把路径放在下面的PostMapping 便可以正 ...
- sqoop从DB2迁移数据到HDFS
Sqoop import job failed to read data from DB2 database which has UTF8 encoding. Essentially, even th ...
- Only variable references should be returned by reference
搭建完Lepus监控系统后,界面提示错误:A PHP Error was encountered Severity: Notice Message: Only variable references ...
- Absolute Horizontal And Vertical Centering In CSS
Quick CSS Trick: How To Center an Object Exactly In The Center Centering in CSS: A Complete Guide Ab ...
- 高级I/O函数
给套接口上的I/O设置超时 1.调用alarm,在调用超过指定时间时产生SIGALARM信号,这涉及到信号处理,而且可能和进程中其他的alarm冲突 2.使用select阻塞在等待I/O上,selec ...
- ObjecT4:On-line multiple instance learning (MIL)学习
原文链接:http://blog.csdn.net/ikerpeng/article/details/19235391 用到论文,直接看翻译. 文章:Robust object tracking wi ...
- 『转』The Beginning of your Design Career
想想,如果明天我开始学日语,坚持到毕业,其实也可以日语入门了.所以机会都是抓住,当初,也就是去年的时候,我那个时候就开始坚持日语入门,想想现在应该可以开始N2了吧-所以...过去不去理会,现在开始继续 ...
- RabbitMQ学习之集群消息可靠性测试
之前介绍过关于消息发送和接收的可靠性:RabbitMQ学习之消息可靠性及特性 下面主要介绍一下集群环境下,rabbitmq实例宕机的情况下,消息的可靠性.验证rabbitmq版本[3.4.1]. 集群 ...