
Spark学习笔记——读写Hbase
1.首先在Hbase中建立一张表,名字为student
一个cell的值,取决于Row,Column family,Column Qualifier和Timestamp
Hbase表结构

2.往Hbase中写入数据,写入的时候,需要写family和column
build.sbt
libraryDependencies ++= Seq(

  "org.apache.spark" %% "spark-core" % "2.1.0",

  "mysql" % "mysql-connector-java" % "5.1.31",

  "org.apache.spark" %% "spark-sql" % "2.1.0",

  "org.apache.hbase" % "hbase-common" % "1.3.0",

  "org.apache.hbase" % "hbase-client" % "1.3.0",

  "org.apache.hbase" % "hbase-server" % "1.3.0",

  "org.apache.hbase" % "hbase" % "1.2.1"

)
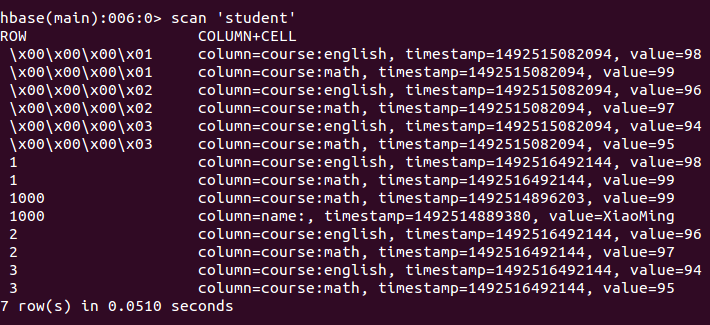
在hbaseshell中写数据的时候,写的是String,但是在idea中写代码的话,如果写的是int类型的,就会出现\x00...的情况
import org.apache.spark.{SparkConf, SparkContext}

import org.apache.spark.sql._

import java.util.Properties

import com.google.common.collect.Lists

import org.apache.spark.sql.types.{ArrayType, StringType, StructField, StructType}

import org.apache.hadoop.hbase.HBaseConfiguration

import org.apache.hadoop.hbase.client.{Get, Put, Result, Scan}

import org.apache.hadoop.hbase.io.ImmutableBytesWritable

import org.apache.hadoop.hbase.mapred.TableOutputFormat

import org.apache.hadoop.hbase.mapreduce.TableInputFormat

import org.apache.hadoop.hbase.util.Bytes

import org.apache.hadoop.mapred.JobConf

/**

  * Created by mi on 17-4-11.

  */

case class resultset(name: String,

                     info: String,

                     summary: String)

case class IntroItem(name: String, value: String)

case class BaikeLocation(name: String,

                         url: String = "",

                         info: Seq[IntroItem] = Seq(),

                         summary: Option[String] = None)

case class MewBaikeLocation(name: String,

                            url: String = "",

                            info: Option[String] = None,

                            summary: Option[String] = None)

object MysqlOpt {

  def main(args: Array[String]): Unit = {

    // 本地模式运行,便于测试

    val conf = new SparkConf().setAppName("WordCount").setMaster("local")

    // 创建 spark context

    val sc = new SparkContext(conf)

    val sqlContext = new SQLContext(sc)

    import sqlContext.implicits._

    //定义数据库和表信息

    val url = "jdbc:mysql://localhost:3306/baidubaike?useUnicode=true&characterEncoding=UTF-8"

    val table = "baike_pages"

    // 读取Hbase文件,在hbase的/usr/local/hbase/conf/hbase-site.xml中写的地址

    val hbasePath = "file:///usr/local/hbase/hbase-tmp"

    // 创建hbase configuration

    val hBaseConf = HBaseConfiguration.create()

    hBaseConf.set(TableInputFormat.INPUT_TABLE, "student")

    // 初始化jobconf,TableOutputFormat必须是org.apache.hadoop.hbase.mapred包下的!

    val jobConf = new JobConf(hBaseConf)

    jobConf.setOutputFormat(classOf[TableOutputFormat])

    jobConf.set(TableOutputFormat.OUTPUT_TABLE, "student")

    val indataRDD = sc.makeRDD(Array("1,99,98","2,97,96","3,95,94"))

    val rdd = indataRDD.map(_.split(',')).map{arr=>{

      /*一个Put对象就是一行记录,在构造方法中指定主键

       * 所有插入的数据必须用org.apache.hadoop.hbase.util.Bytes.toBytes方法转换

       * Put.add方法接收三个参数:列族,列名,数据

       */

      val put = new Put(Bytes.toBytes(arr(0)))

      put.add(Bytes.toBytes("course"),Bytes.toBytes("math"),Bytes.toBytes(arr(1)))

      put.add(Bytes.toBytes("course"),Bytes.toBytes("english"),Bytes.toBytes(arr(2)))

      //转化成RDD[(ImmutableBytesWritable,Put)]类型才能调用saveAsHadoopDataset

      (new ImmutableBytesWritable, put)

    }}

    rdd.saveAsHadoopDataset(jobConf)

    sc.stop()

  }

}
3.从Hbase中读取数据
import org.apache.spark.{SparkConf, SparkContext}

import org.apache.spark.sql._

import java.util.Properties

import com.google.common.collect.Lists

import org.apache.spark.sql.types.{ArrayType, StringType, StructField, StructType}

import org.apache.hadoop.hbase.HBaseConfiguration

import org.apache.hadoop.hbase.client.{Get, Put, Result, Scan}

import org.apache.hadoop.hbase.io.ImmutableBytesWritable

import org.apache.hadoop.hbase.mapred.TableOutputFormat

import org.apache.hadoop.hbase.mapreduce.TableInputFormat

import org.apache.hadoop.hbase.util.Bytes

import org.apache.hadoop.mapred.JobConf

/**

  * Created by mi on 17-4-11.

  */

case class resultset(name: String,

                     info: String,

                     summary: String)

case class IntroItem(name: String, value: String)

case class BaikeLocation(name: String,

                         url: String = "",

                         info: Seq[IntroItem] = Seq(),

                         summary: Option[String] = None)

case class MewBaikeLocation(name: String,

                            url: String = "",

                            info: Option[String] = None,

                            summary: Option[String] = None)

object MysqlOpt {

  def main(args: Array[String]): Unit = {

    // 本地模式运行,便于测试

    val conf = new SparkConf().setAppName("WordCount").setMaster("local")

    // 创建 spark context

    val sc = new SparkContext(conf)

    val sqlContext = new SQLContext(sc)

    import sqlContext.implicits._

    //定义数据库和表信息

    val url = "jdbc:mysql://localhost:3306/baidubaike?useUnicode=true&characterEncoding=UTF-8"

    val table = "baike_pages"

    // 读取Hbase文件,在hbase的/usr/local/hbase/conf/hbase-site.xml中写的地址

    val hbasePath = "file:///usr/local/hbase/hbase-tmp"

    // 创建hbase configuration

    val hBaseConf = HBaseConfiguration.create()

    hBaseConf.set(TableInputFormat.INPUT_TABLE, "student")

    // 从数据源获取数据并转化成rdd

    val hBaseRDD = sc.newAPIHadoopRDD(hBaseConf, classOf[TableInputFormat], classOf[ImmutableBytesWritable], classOf[Result])

    println(hBaseRDD.count())

    // 将数据映射为表  也就是将 RDD转化为 dataframe schema

    hBaseRDD.foreach{case (_,result) =>{

      //获取行键

      val key = Bytes.toString(result.getRow)

      //通过列族和列名获取列

      val math = Bytes.toString(result.getValue("course".getBytes,"math".getBytes))

      println("Row key:"+key+" Math:"+math)

    }}

    sc.stop()

  }

}
输出
Row key:    Math:99

Row key:    Math:97

Row key:    Math:95

Row key:1 Math:99

Row key:1000 Math:99

Row key:2 Math:97

Row key:3 Math:95
Spark学习笔记——读写Hbase的更多相关文章
- Spark学习笔记——读写HDFS
使用Spark读写HDFS中的parquet文件 文件夹中的parquet文件 build.sbt文件 name := "spark-hbase" version := " ...
- Spark学习笔记——读写MySQL
1.使用Spark读取MySQL中某个表中的信息 build.sbt文件 name := "spark-hbase" version := "1.0" scal ...
- spark学习笔记总结-spark入门资料精化
Spark学习笔记 Spark简介 spark 可以很容易和yarn结合,直接调用HDFS.Hbase上面的数据,和hadoop结合.配置很容易. spark发展迅猛,框架比hadoop更加灵活实用. ...
- Spark学习笔记之SparkRDD
Spark学习笔记之SparkRDD 一. 基本概念 RDD(resilient distributed datasets)弹性分布式数据集. 来自于两方面 ① 内存集合和外部存储系统 ② ...
- Spark学习笔记2(spark所需环境配置
Spark学习笔记2 配置spark所需环境 1.首先先把本地的maven的压缩包解压到本地文件夹中,安装好本地的maven客户端程序,版本没有什么要求 不需要最新版的maven客户端. 解压完成之后 ...
- Spark学习笔记3(IDEA编写scala代码并打包上传集群运行)
Spark学习笔记3 IDEA编写scala代码并打包上传集群运行 我们在IDEA上的maven项目已经搭建完成了,现在可以写一个简单的spark代码并且打成jar包 上传至集群,来检验一下我们的sp ...
- Spark学习笔记-GraphX-1
Spark学习笔记-GraphX-1 标签: SparkGraphGraphX图计算 2014-09-29 13:04 2339人阅读 评论(0) 收藏 举报 分类: Spark(8) 版权声明: ...
- Hadoop学习笔记之HBase Shell语法练习
Hadoop学习笔记之HBase Shell语法练习 作者:hugengyong 下面我们看看HBase Shell的一些基本操作命令,我列出了几个常用的HBase Shell命令,如下: 名称 命令 ...
- HBase学习笔记之HBase的安装和配置
HBase学习笔记之HBase的安装和配置 我是为了调研和验证hbase的bulkload功能,才安装hbase,学习hbase的.为了快速的验证bulkload功能,我安装了一个节点的hadoop集 ...
随机推荐
- tcp nonblock connection rst
客户端(>5w)异步connect连接到server端,server端listen backlog设置为1024,发现存在部分客户端建立连接后,收到服务端的rst包. 先看下tcp监听套接字维护 ...
- Mysql启动失败
错误提示: 服务名无效 错误原因: mysql服务没有安装. 解决方法: 管理员的权限运行cmd 用dos命令进入到mysql安装目录下再进入到bin目录下 运行mysqld -install命令
- 使用AngularJS中的filterFilter函数进行过滤
AngularJS中有一个filterFilter函数用来对集合过滤,非常方便. 源代码大致如下: function filterFilter(){ return function(aray, exp ...
- android:碎片的使用方式
介绍了这么多抽象的东西,也是时候应该学习一下碎片的具体用法了.你已经知道,碎 片通常都是在平板开发中才会使用的,因此我们首先要做的就是新建一个平板电脑的模拟 器.由于 4.0 系统的平板模拟器好像存在 ...
- Java调用使用SSL/HTTPS协议来传输的axis webservice服务
使用SSL/HTTPS协议来传输 Web服务也可以使用SSL作为传输协议.虽然JAX-RPC并没有强制规定是否使用SSL协议,但在tomcat 下使用HTTPS协议. 1.使用JDK自带的工具创建密匙 ...
- 连接mysql 出现:java.sql.SQLException: Unable to load authentication plugin 'caching_sha2_password'.
数据测试的时候出现: 网上查资料说的是mysql5.x 版本和 8.x版本的区别: 5.7版本是:default_authentication_plugin=mysql_native_password ...
- pyqt QFileDialog
from PyQt5 import QtWidgetsfrom PyQt5.QtWidgets import QFileDialog class MyWindow(QtWidgets.QWidget) ...
- Hbase 命令小结
1.创建test,如果存在先删除 hbase(main)::> disable 'test' row(s) in 1.4250 seconds hbase(main)::> drop 't ...
- Cache Line 伪共享发现与优化
https://yq.aliyun.com/articles/465504 Cache Line 伪共享发现与优化 作者:吴一昊,杨勇 1. 关于本文 本文基于 Joe Mario 的一篇博客 改编而 ...
- 让 Python 更加充分的使用 Sqlite3
我最近在涉及大量数据处理的项目中频繁使用 sqlite3.我最初的尝试根本不涉及任何数据库,所有的数据都将保存在内存中,包括字典查找.迭代和条件等查询.这很好,但可以放入内存的只有那么多,并且将数据从 ...