
Python3---爬虫---抓取百度贴吧
前言
该文章主要描述如何抓取百度贴吧内容。当然是简单爬虫实现功能,没有实现输入参数过滤等辅助功能,仅供小白学习。
修改时间:20191219
天象独行
import os,urllib.request,urllib.parse

'''

    测试要求:

        1;输入吧名,首页,结束页进行爬虫。

        2;创建一个以吧名为名字的文件夹,里面是每一页的html的内容,文件名格式:吧名_page.html

'''

url = "https://tieba.baidu.com/f?"

ba_name = input("请输入需要下载的吧名: ")

home_page = int(input("请输入首页:"))

end_page = int(input("请输入结束页:"))

#创建一个路径变量:

path = "C:\\Users\\aaron\\Documents\\Python3-test"

os.makedirs(path)

'''

    pn = 0  第一页

    pn = 50 第二页

    pn = 100 第三页

    。。。。

    pn = (n-1)*50 第n页

'''

for page in range(home_page,end_page+1):

    #构造请求参数字典

    data = {

        "kw":ba_name,

        "ie":"urt-8",

        "pn":(page-1)*50

    }

    #构造请求hearders头

    #构造请求参数

    url_get = urllib.parse.urlencode(data)

    #构造请求url

    url_get = url + url_get

    #请求url

    request = urllib.request.urlopen(url_get)

    #创建一个文件名

    filename = ba_name + '_' + str(page) + '.html'

    #拼接文件路径

    filepath = path + '\\' + filename

    print(filepath)

    #写入内容

    with open(filepath,'wb') as fp:

        fp.write(request.read())
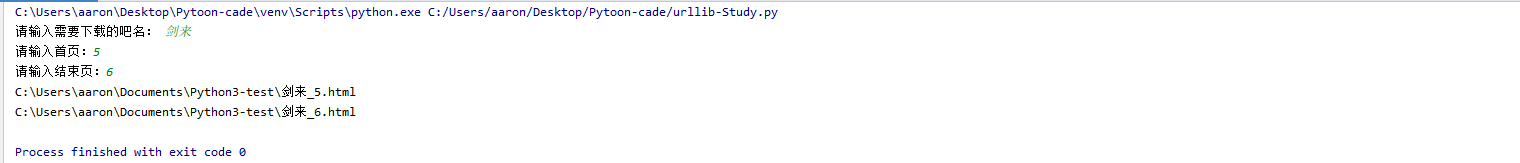
执行结果:
Python3---爬虫---抓取百度贴吧的更多相关文章
- 笔趣看小说Python3爬虫抓取
笔趣看小说Python3爬虫抓取 获取HTML信息 解析HTML信息 整合代码 获取HTML信息 # -*- coding:UTF-8 -*- import requests if __name__ ...
- 使用Python3爬虫抓取网页来下载小说
很多时候想看小说但是在网页上找不到资源,即使找到了资源也没有提供下载,小说当然是下载下来用手机看才爽快啦! 于是程序员的思维出来了,不能下载我就直接用爬虫把各个章节爬下来,存入一个txt文件中,这样, ...
- 关于Python3爬虫抓取网页Unicode
import urllib.requestresponse = urllib.request.urlopen('http://www.baidu.com')html = response.read() ...
- python3爬虫抓取智联招聘职位信息代码
上代码,有问题欢迎留言指出. # -*- coding: utf-8 -*- """ Created on Tue Aug 7 20:41:09 2018 @author ...
- Python3简单爬虫抓取网页图片
现在网上有很多python2写的爬虫抓取网页图片的实例,但不适用新手(新手都使用python3环境,不兼容python2), 所以我用Python3的语法写了一个简单抓取网页图片的实例,希望能够帮助到 ...
- Python爬虫之小试牛刀——使用Python抓取百度街景图像
之前用.Net做过一些自动化爬虫程序,听大牛们说使用python来写爬虫更便捷,按捺不住抽空试了一把,使用Python抓取百度街景影像. 这两天,武汉迎来了一个德国总理默克尔这位大人物,又刷了一把武汉 ...
- PHP网络爬虫实践:抓取百度搜索结果,并分析数据结构
百度的搜索引擎有反爬虫机制,我先直接用guzzle试试水.代码如下: <?php /** * Created by Benjiemin * Date: 2020/3/5 * Time: 14:5 ...
- python3 - 通过BeautifulSoup 4抓取百度百科人物相关链接
导入需要的模块 需要安装BeautifulSoup from urllib.request import urlopen, HTTPError, URLError from bs4 import Be ...
- Python抓取百度百科数据
前言 本文整理自慕课网<Python开发简单爬虫>,将会记录爬取百度百科"python"词条相关页面的整个过程. 抓取策略 确定目标:确定抓取哪个网站的哪些页面的哪部分 ...
- Python爬虫 - 爬取百度html代码前200行
Python爬虫 - 爬取百度html代码前200行 - 改进版, 增加了对字符串的.strip()处理 源代码如下: # 改进版, 增加了 .strip()方法的使用 # coding=utf-8 ...
随机推荐
- PHP 微信公众号/小程序获取openid,用户信息
1.获取code (获得openid的前置条件) 地址:https://open.weixin.qq.com/connect/oauth2/authorize?appid=APPID&redi ...
- spring = servlet + 依赖管理 + 业务逻辑
spring = servlet + 依赖管理 + 业务逻辑
- 利用重写R3环的ReadProcessMemory来防止恶意程序钩取
访问这里---> Windows系统调用中API的三环部分(依据分析重写ReadProcessMemory函数)
- 发布方式一:发布.netcore流程
通过注册世纪互联,发布网站 注册需要上传身份证正反照片,以及打款一元,试用期一个月 https://www.azure.cn 注册完成后,进入主页面: 如图所示,创建完成后的效果: 点开详情, ...
- Android中点击事件的四种写法详解
Android中点击事件的四种写法 使用内部类实现点击事件 使用匿名内部类实现点击事件 让MainActivity实现View.OnClickListener接口 通过布局文件中控件的属性 第一种方法 ...
- Thymeleaf常用语法:使用星号表达式
在处理模板时,一般情况都是使用变量表达式 ${...} 来显示变量,还可以使用选定对象表达式 *{...},它也称为星号表达式.如果在模板中先选定了对象,则需要使用星号表达式.Thymeleaf的内置 ...
- selinux disable
临时关闭: [root@localhost ~]# getenforceEnforcing [root@localhost ~]# setenforce 0[root@localhost ~]# ge ...
- 网络编程~~~ socket(套字节)
一 socket (套接字) socket处于应用层与传输层之间,提供了一些简单的接口,避免与操作系统之间的对接,省去了相当繁琐复杂的操作. socket在python中属于一个模块,通过调用模块中已 ...
- 网络时间服务和chrony
⽹络时间服务和chrony 实验练习: 准备实验环境: 可用的centos6.7系统. centos6 :192.168.37.6 centos7 :192.168.37.7 关闭selinux 关闭 ...
- 多个div使用display:inline-block时候div之间有间隔
开发场景中用到display:inline-block;然后呢,div间就有间隙,但是ajax加载出来的数据没有间隙,解决办法如下 display:inline-block表示行内块元素,后面自带 ...