
入门大数据---HDFS-API
第一步:创建一个新的项目 并导入需要的jar包
公共核心包
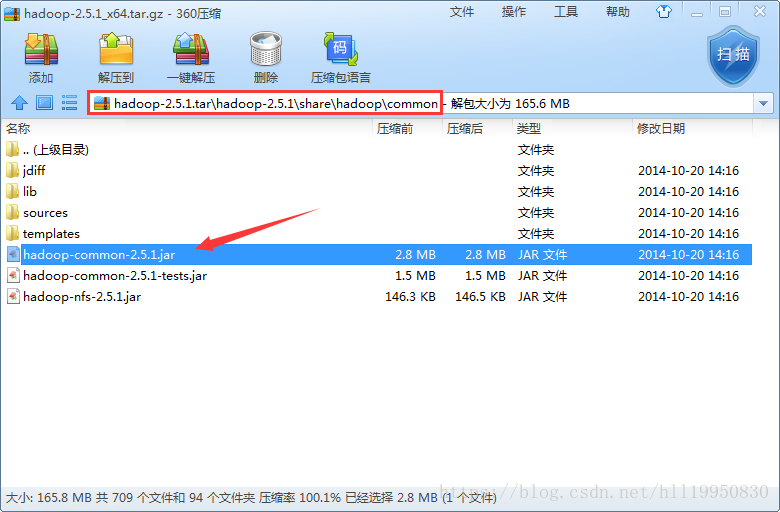
公共依赖包

hdfs核心包

hdfs依赖包
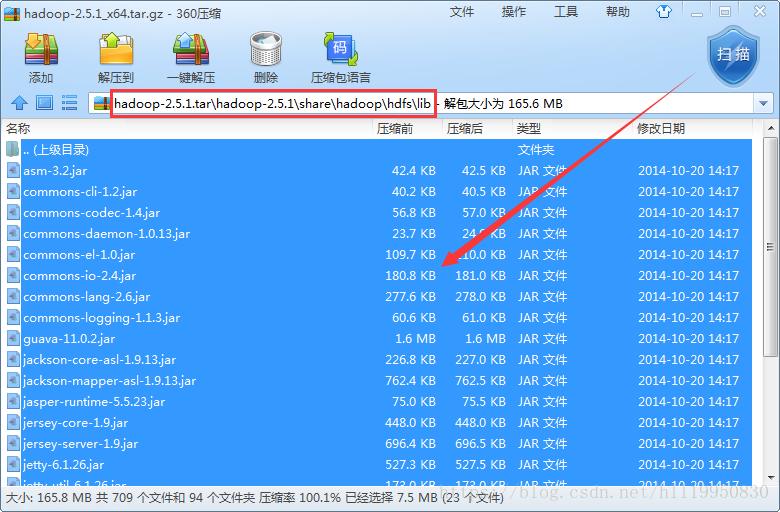
第二步:将Linux中hadoop的配置文件拷贝到项目的src目录下

第三步:配置windows本地的hadoop环境变量(HADOOP_HOME:hadoop的安装目录 Path:在后面添加hadoop下的bin目录)
第四步:使用windows下编译好的hadoop替换hadoop的bin目录和lib目录
第五步:使用FileSystem对象对hdfs进行操作(注意:FileSystem默认是本地文件系统 因此要通过Configuration对象配置为hdfs系统)
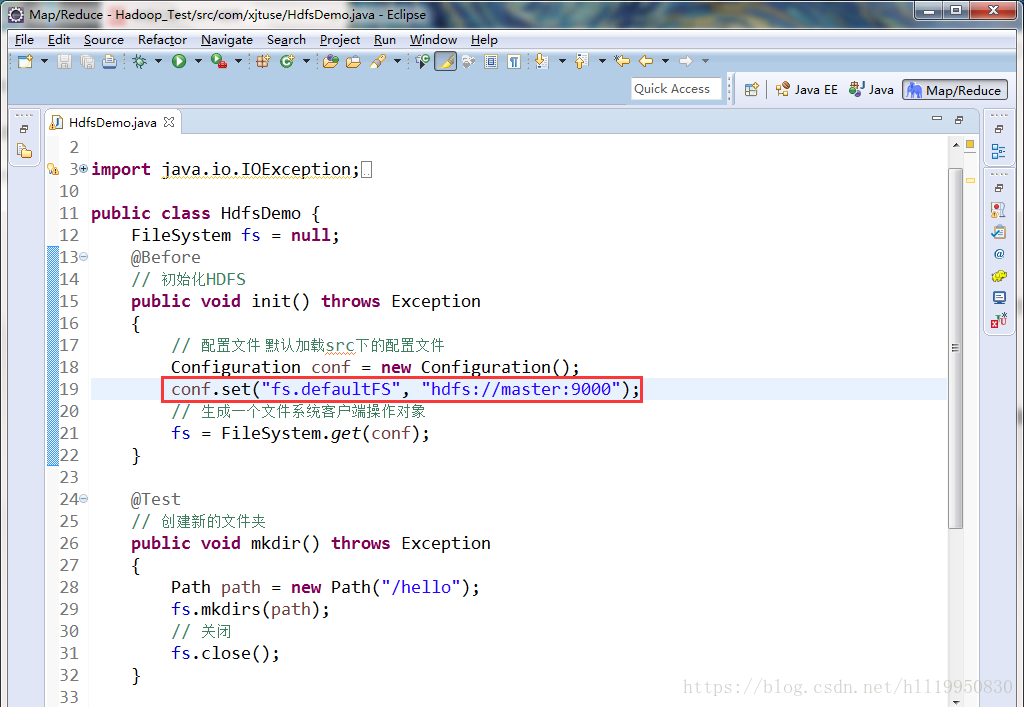
第六步:在运行之前 需要保证本地的用户名和hadoop的用户名一致 在不修改windows用户名的情况下 可以配置Eclipse的参数实现:右击项目->Run As ->Run Configurations
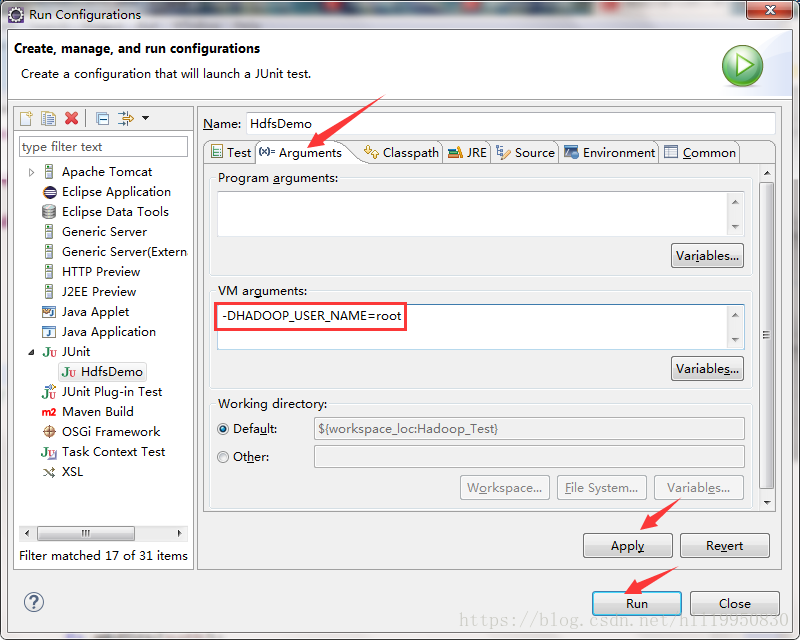
运行即可成功上传本地文件到hdfs
代码如下:
package com.xjtuse;
import java.net.URI;
import org.apache.hadoop.conf.Configuration;
import org.apache.hadoop.fs.FileSystem;
import org.apache.hadoop.fs.Path;
import org.junit.Before;
import org.junit.Test;
public class HdfsDemo {
FileSystem fs = null;
@Before
// 初始化HDFS
public void init() throws Exception
{
// 配置文件 默认加载src下的配置文件
Configuration conf = new Configuration();
// conf.set("fs.defaultFS", "hdfs://master:9000");
// 生成一个文件系统客户端操作对象
// fs = FileSystem.get(conf);
// 第一个参数是URI指明了是hdfs文件系统 第二个参数是配置文件 第三个参数是指定用户名 需要与hadoop用户名保持一致
fs = FileSystem.get(new URI("hdfs://master:9000"), conf, "root");
}
@Test
// 创建新的文件夹
public void mkdir() throws Exception
{
Path path = new Path("/hello");
fs.mkdirs(path);
// 关闭
fs.close();
}
@Test
// 上传文件
public void upload() throws Exception
{
// 第一个参数是本地windows下的文件路径 第二个参数是hdfs的文件路径
fs.copyFromLocalFile(new Path("F:/Files/data/README.txt"), new Path("/"));
// 关闭
fs.close();
}
}
转自: https://blog.csdn.net/hll19950830/article/details/79824928
补充:最后我们运行可能报如下异常。

这个时候在项目根目录下创建一个文件命名为log4j.properties并填写如下内容,然后重新运行就好了。
hadoop.root.logger=DEBUG, console
log4j.rootLogger = DEBUG, console
log4j.appender.console=org.apache.log4j.ConsoleAppender
log4j.appender.console.target=System.out
log4j.appender.console.layout=org.apache.log4j.PatternLayout
log4j.appender.console.layout.ConversionPattern=%d{yy/MM/dd HH:mm:ss} %p %c{2}: %m%n
有的时候我们新建文件的时候选择File->New没有选择文件这个选项,这个时候不用着急,它给隐藏了,找到Window->Perspective->Customize Perspective 勾选上File即可。
更多内容参阅官方API文档。
入门大数据---HDFS-API的更多相关文章
- 入门大数据---HDFS,Zookeeper,ZookeeperFailOverController(简称:ZKFC),JournalNode是什么?
HDFS介绍: 简述: Hadoop Distributed File System(HDFS)是一种分布式文件系统,设计用于在商用硬件上运行.它与现有的分布式文件系统有许多相似之处.但是,与其他分布 ...
- 入门大数据---Spark_Structured API的基本使用
一.创建DataFrame和Dataset 1.1 创建DataFrame Spark 中所有功能的入口点是 SparkSession,可以使用 SparkSession.builder() 创建.创 ...
- 入门大数据---Spark整体复习
一. Spark简介 1.1 前言 Apache Spark是一个基于内存的计算框架,它是Scala语言开发的,而且提供了一站式解决方案,提供了包括内存计算(Spark Core),流式计算(Spar ...
- 入门大数据---Flink学习总括
第一节 初识 Flink 在数据激增的时代,催生出了一批计算框架.最早期比较流行的有MapReduce,然后有Spark,直到现在越来越多的公司采用Flink处理.Flink相对前两个框架真正做到了高 ...
- 入门大数据---SparkSQL外部数据源
一.简介 1.1 多数据源支持 Spark 支持以下六个核心数据源,同时 Spark 社区还提供了多达上百种数据源的读取方式,能够满足绝大部分使用场景. CSV JSON Parquet ORC JD ...
- 入门大数据---Hadoop是什么?
简单概括:Hadoop是由Apache组织使用Java语言开发的一款应对大数据存储和计算的分布式开源框架. Hadoop的起源 2003-2004年,Google公布了部分GFS和MapReduce思 ...
- 入门大数据---Kylin是什么?
一.Kylin是什么? Apache Kylin是一个开源的.分布式的分析型数据仓库,提供Hadoop/Spark 上的SQL查询接口及多维度分析(OLAP)能力以支持超大规模的数据,最初由eBay开 ...
- 大数据-hdfs技术
hadoop 理论基础:GFS----HDFS:MapReduce---MapReduce:BigTable----HBase 项目网址:http://hadoop.apache.org/ 下载路径: ...
- 入门大数据---MapReduce-API操作
一.环境 Hadoop部署环境: Centos3.10.0-327.el7.x86_64 Hadoop2.6.5 Java1.8.0_221 代码运行环境: Windows 10 Hadoop 2.6 ...
- 入门大数据---安装ClouderaManager,CDH和Impala,Hue,oozie等服务
1.要求和支持的版本 (PS:我使用的环境,都用加粗标识了.) 1.1 支持的操作系统版本 操作系统 版本 RHEL/CentOS/OL with RHCK kernel 7.6, 7.5, 7.4, ...
随机推荐
- 一次FGC导致CPU飙高的排查过程
今天测试团队反馈说,服务A的响应很慢,我在想,测试环境也会慢?于是我自己用postman请求了一下接口,真的很慢,竟然要2s左右,正常就50ms左右的. 于是去测试服务器看了一下,发现服务器负载很高, ...
- ASP.NET Core MVC+Layui使用EF Core连接MySQL执行简单的CRUD操作
前言: 本章主要通过一个完整的示例讲解ASP.NET Core MVC+EF Core对MySQL数据库进行简单的CRUD操作,希望能够为刚入门.NET Core的小伙伴们提供一个完整的参考实例.关于 ...
- AUTOSAR-软件规范文档中的UML
https://mp.weixin.qq.com/s/vm5vWNSpbNIYh25-LjJfYg AUTOSAR软件规范文档中存在两种UML图: Sequence diagrams Config ...
- Chisel3 - Tutorial - Adder4
https://mp.weixin.qq.com/s/X5EStKor2DU0-vS_wIO-fg 四位加法器.通过FullAdder级联实现. 参考链接: https://github.co ...
- 使用Python代码制作GIF动态图
使用Python PIL.Image 制作GIF图片: import PIL.Image 相关模块 img = Image.open(img_name) ...
- 【大厂面试03期】MySQL是怎么解决幻读问题的?
问题分析 首先幻读是什么? 根据MySQL文档上面的定义 The so-called phantom problem occurs within a transaction when the same ...
- Java实现 蓝桥杯VIP 算法训练 连通分块(并查集)
试题 算法训练 连通分块 资源限制 时间限制:200ms 内存限制:8.0MB 问题描述 连通分块 输入格式 输入的第一行包含两个整数n, m n代表图中的点的个数,m代表边的个数 接下来m行,每行2 ...
- Java实现 LeetCode 199 二叉树的右视图
199. 二叉树的右视图 给定一棵二叉树,想象自己站在它的右侧,按照从顶部到底部的顺序,返回从右侧所能看到的节点值. 示例: 输入: [1,2,3,null,5,null,4] 输出: [1, 3, ...
- Java实现 蓝桥杯 历届试题 连号区间数
问题描述 小明这些天一直在思考这样一个奇怪而有趣的问题: 在1~N的某个全排列中有多少个连号区间呢?这里所说的连号区间的定义是: 如果区间[L, R] 里的所有元素(即此排列的第L个到第R个元素)递增 ...
- java实现第六届蓝桥杯九数分三组
九数分三组 题目描述 1~9的数字可以组成3个3位数,设为:A,B,C, 现在要求满足如下关系: B = 2 * A C = 3 * A 请你写出A的所有可能答案,数字间用空格分开,数字按升序排列. ...