
入门大数据---MapReduce-API操作
一.环境
Hadoop部署环境:
Centos3.10.0-327.el7.x86_64
Hadoop2.6.5
Java1.8.0_221
代码运行环境:
Windows 10
Hadoop 2.6.5
二.安装Hadoop-Eclipse-Plugin
在Eclipse中编译和运行Mapreduce程序,需要安装hadoop-eclipse-plugin,可下载Github上的 hadoop2x-eclipse-plugin 。
下载后将release中的hadoop-eclipse-plugin-2.6.0.jar放在eclipse下面plugins目录下。
三.配置Hadoop-Plugin
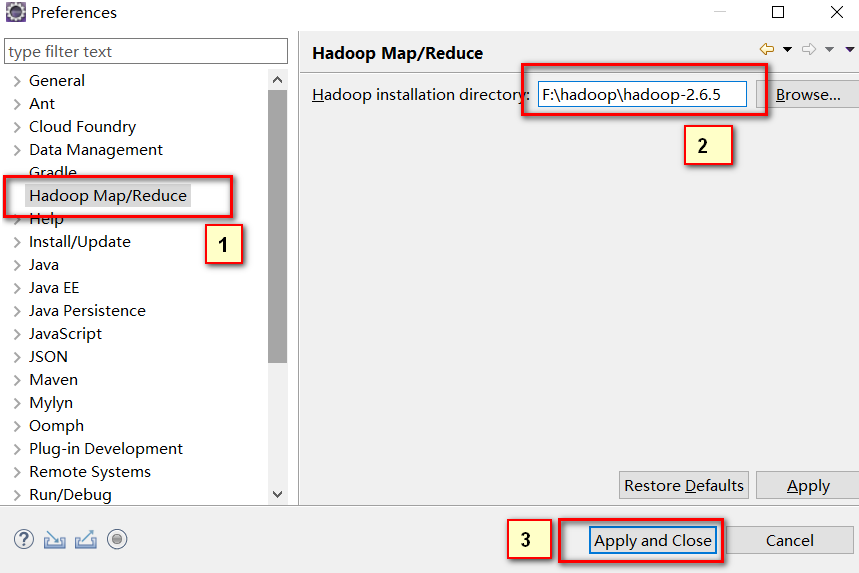
运行eclipse后,点击Window->Preferences在Hadoop Map/Reduce中填上计算机中安装的hadoop目录。
四.在Eclipse中操作HDFS中的文件
我们之前一直使用命令操作Hdfs,接下来再配置几步就可以在Eclipse中可视化操作啦。
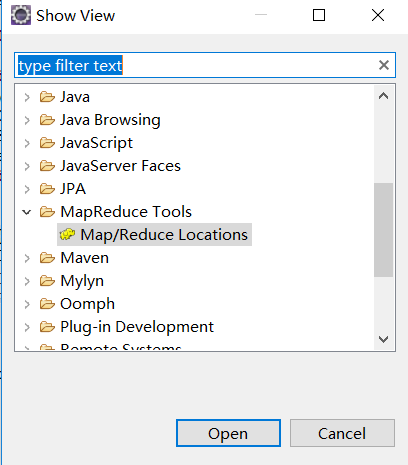
选择Window下面的Show View->Other... ,在弹出的框里面展开MapReduce Tools,选择Map/Reduce Locations点击Open。
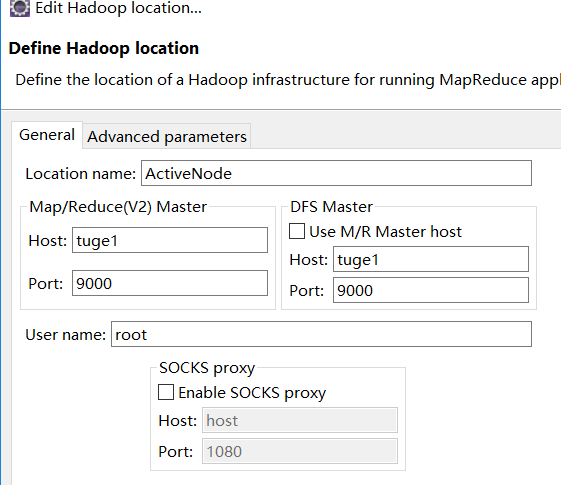
然后在弹出的栏目右键,点击New Hadoop location在弹出框General下面填上活跃的NameNode和端口号信息。

配置好后,可以在左侧刷新即可看到HDFS文件(Tips:对HDFS很多操作后,插件不会自动帮我们刷新内容,需要我们手动刷新)

五.在Eclipse中创建MapReduce项目
选择File->New->Project... 选择Map/Reduce Project ,选择Next,填写项目名称,这里我起名MapReduceFirstDemo。
然后将服务器上的core-site.xml和hdfs-site.xml复制到项目根目录下,并在根目录下创建一个log4j.properties,填上如下内容:
hadoop.root.logger=DEBUG, console
log4j.rootLogger = DEBUG, console
log4j.appender.console=org.apache.log4j.ConsoleAppender
log4j.appender.console.target=System.out
log4j.appender.console.layout=org.apache.log4j.PatternLayout
log4j.appender.console.layout.ConversionPattern=%d{yy/MM/dd HH:mm:ss} %p %c{2}: %m%n
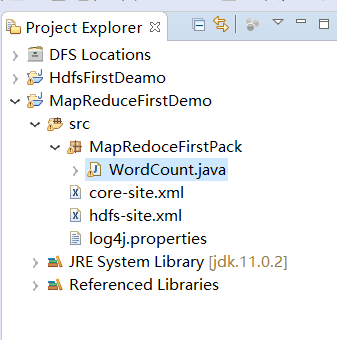
在src中右键创建一个Package,起名MapReduceFirstPack,然后在MapReduceFirstPack下面创建一个WordCount类。大致结构如下图:
将下面的代码复制到WordCount里面
package MapRedoceFirstPack;

import java.io.IOException;

import java.util.Iterator;

import java.util.StringTokenizer;

import org.apache.hadoop.conf.Configuration;

import org.apache.hadoop.fs.Path;

import org.apache.hadoop.io.IntWritable;

import org.apache.hadoop.io.Text;

import org.apache.hadoop.mapreduce.Job;

import org.apache.hadoop.mapreduce.Mapper;

import org.apache.hadoop.mapreduce.Reducer;

import org.apache.hadoop.mapreduce.lib.input.FileInputFormat;

import org.apache.hadoop.mapreduce.lib.output.FileOutputFormat;

import org.apache.hadoop.util.GenericOptionsParser;

public class WordCount {

    public static void main(String[] args) throws Exception {

        // TODO Auto-generated method stub

        Configuration conf=new Configuration();

        String[] otherArgs=(new GenericOptionsParser(conf, args)).getRemainingArgs();

        if(otherArgs.length<) {

            System.err.println("Usage:wordcount");

            System.exit();

        }

        Job job=Job.getInstance(conf,"word count");

        job.setJarByClass(WordCount.class);

        job.setMapperClass(WordCount.TokenizerMapper.class);

        job.setCombinerClass(WordCount.IntSumReducer.class);

        job.setReducerClass(WordCount.IntSumReducer.class);

        job.setOutputKeyClass(Text.class);

        job.setOutputValueClass(IntWritable.class);

        for(int i=;i<otherArgs.length-;++i) {

            FileInputFormat.addInputPath(job, new Path(otherArgs[i]));

        }

        FileOutputFormat.setOutputPath(job, new Path(otherArgs[otherArgs.length-]));

        System.exit(job.waitForCompletion(true)?:);

    }

    private static class IntSumReducer extends Reducer<Text,IntWritable,Text,IntWritable>{

        public IntSumReducer() {}

        private IntWritable result=new IntWritable();

        public void reduce(Text key,Iterable<IntWritable> values,Reducer<Text,IntWritable,Text,IntWritable>.Context context) throws IOException,InterruptedException{

            int sum=;

            IntWritable val;

            for(Iterator i$=values.iterator();i$.hasNext();sum+=val.get()) {

                val=(IntWritable)i$.next();

            }

            this.result.set(sum);

            context.write(key, this.result);

        }

    }

    public static class TokenizerMapper extends Mapper<Object,Text,Text,IntWritable>{

        private static final IntWritable one=new IntWritable();

        private Text word=new Text();

        public TokenizerMapper() {

        }

        public void map(Object key,Text value,Mapper<Object,Text,Text,IntWritable>.Context context) throws IOException,InterruptedException {

            StringTokenizer itr=new StringTokenizer(value.toString());

            while(itr.hasMoreTokens()) {

                this.word.set(itr.nextToken());

                context.write(this.word, one);

            }

        }

    }

}
六.在Eclipse中运行MapReduce项目
在运行上述项目之前,我们需要配置下运行参数。 在项目右键Run As->Run Configuration。 在弹出的框里面选择Java Applicaton下面的WordCount(Tips:如果没有WordCount,则双击Java Application就有了),在Arguments下面添加input output(Tips:代表了输入目录和输出目录,输入目录放要计算的内容,这个需要自己创建,输出目录一定不要创建,它会自动生成,否则会提示已存在此目录的错误),如下图:
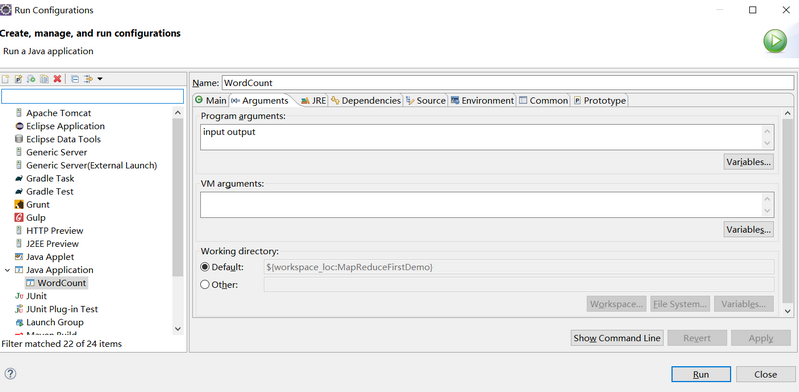
然后点击Run运行。
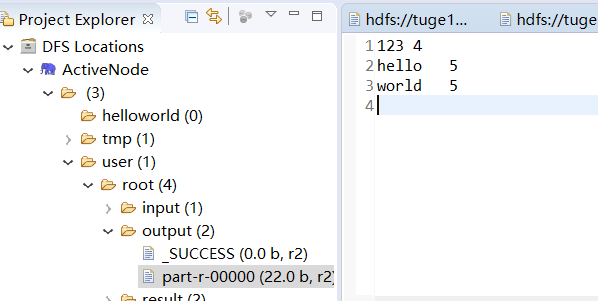
运行完毕后,在左侧刷新,在output目录可以看到两个文件,_SUCCESS是标识文件,代表执行成功的意思。part-r-00000存放的执行结果。
参考资料:
入门大数据---MapReduce-API操作的更多相关文章
- 入门大数据---SparkSQL联结操作
一. 数据准备 本文主要介绍 Spark SQL 的多表连接,需要预先准备测试数据.分别创建员工和部门的 Datafame,并注册为临时视图,代码如下: val spark = SparkSessio ...
- 入门大数据---Spark_Structured API的基本使用
一.创建DataFrame和Dataset 1.1 创建DataFrame Spark 中所有功能的入口点是 SparkSession,可以使用 SparkSession.builder() 创建.创 ...
- 入门大数据---Spark整体复习
一. Spark简介 1.1 前言 Apache Spark是一个基于内存的计算框架,它是Scala语言开发的,而且提供了一站式解决方案,提供了包括内存计算(Spark Core),流式计算(Spar ...
- 入门大数据---Flink学习总括
第一节 初识 Flink 在数据激增的时代,催生出了一批计算框架.最早期比较流行的有MapReduce,然后有Spark,直到现在越来越多的公司采用Flink处理.Flink相对前两个框架真正做到了高 ...
- 入门大数据---Kylin是什么?
一.Kylin是什么? Apache Kylin是一个开源的.分布式的分析型数据仓库,提供Hadoop/Spark 上的SQL查询接口及多维度分析(OLAP)能力以支持超大规模的数据,最初由eBay开 ...
- 大数据 --> MapReduce原理与设计思想
MapReduce原理与设计思想 简单解释 MapReduce 算法 一个有趣的例子:你想数出一摞牌中有多少张黑桃.直观方式是一张一张检查并且数出有多少张是黑桃? MapReduce方法则是: 给在座 ...
- 入门大数据---SparkSQL外部数据源
一.简介 1.1 多数据源支持 Spark 支持以下六个核心数据源,同时 Spark 社区还提供了多达上百种数据源的读取方式,能够满足绝大部分使用场景. CSV JSON Parquet ORC JD ...
- 入门大数据---Hadoop是什么?
简单概括:Hadoop是由Apache组织使用Java语言开发的一款应对大数据存储和计算的分布式开源框架. Hadoop的起源 2003-2004年,Google公布了部分GFS和MapReduce思 ...
- 入门大数据---Hbase_Java_API
一.简述 截至到目前 (2019.04),HBase 有两个主要的版本,分别是 1.x 和 2.x ,两个版本的 Java API 有所不同,1.x 中某些方法在 2.x 中被标识为 @depreca ...
随机推荐
- [验证码识别技术] 字符型验证码终结者-CNN+BLSTM+CTC
验证码识别(少样本,高精度)项目地址:https://github.com/kerlomz/captcha_trainer 1. 前言 本项目适用于Python3.6,GPU>=NVIDIA G ...
- Rocket - util - AsyncQueue
https://mp.weixin.qq.com/s/6McbqOKM4fu4J5vdpZvxKw 简单介绍异步队列(AsyncQueue)的实现. 0. 异步队列 异步队列的两端分 ...
- js函数中的this关键字
关于这个this关键字,也是很多项目中常常被用到的,那么,有人也许会问,干嘛要用this呢,在函数被调用时,直接指明是什么对象在调用不就行了?还整那么个模模糊糊的概念出来干嘛?不过嘛,存在即真理,既然 ...
- 【Linux】CentOS7中使用mysql,查询结果显示中文乱码的解决办法
1.登录mysql mysql -u root -p 2.查看mysql字符集 mysql> show variables like 'chara%'; mysql> show varia ...
- Java实现 蓝桥杯 算法提高VIP 摆花 dp 记忆搜索 2种做法 多重背包
题目描述 小明的花店新开张,为了吸引顾客,他想在花店的门口摆上一排花,共m盆.通过调查顾客的喜好,小明列出了顾客最喜欢的n种花,从1到n标号.为了在门口展出更多种花,规定第i种花不能超过ai盆,摆花时 ...
- Java实现 蓝桥杯 算法训练 天数计算
试题 算法训练 天数计算 问题描述 编写函数求某年某月某日(**** ** **)是这一年的第几天 .提示:要考虑闰年,闰年的2月是29天(闰年的条件:是4的倍数但不是100的倍数,或者是400的倍数 ...
- Java实现 LeetCode 395 至少有K个重复字符的最长子串
395. 至少有K个重复字符的最长子串 找到给定字符串(由小写字符组成)中的最长子串 T , 要求 T 中的每一字符出现次数都不少于 k .输出 T 的长度. 示例 1: 输入: s = " ...
- SQLServer2019安装教程
可以去官网下载,我百度网盘也有都一样 https://pan.baidu.com/s/1i3umqHXSUMbxJ9rRi6mU4A 提取码:5g9q 打开应用程序 点击安装,点第一个全新得SQL s ...
- 1.keras-构建基本简单网络实现线性回归
构建基本简单网络实现线性回归 1.创建数据绘制散点图 import keras import numpy as np import matplotlib.pyplot as plt from kera ...
- 前端Javascript效果汇总
1.DOM原生动态加载js <script type="text/javascript"> function loadJs(){ //得到html的头部dom var ...