
基于Spark Mllib的Spark NLP库
1>sbt引入:
scala为2.11时 libraryDependencies += "com.johnsnowlabs.nlp" %% "spark-nlp" % "1.4.2"
scala为2.11之上时libraryDependencies += "com.johnsnowlabs.nlp" % "spark-nlp_2.11" % "1.4.2"
2>maven引入:
< dependency >

  < groupId > com.johnsnowlabs.nlp </ groupId >

  < artifactId > spark-nlp_2.11 </ artifactId >

  < version > 1.4.2 </ version >

</ dependency >
3>直接下载jar包,然后运行:spark-submit --packages JohnSnowLabs:spark-nlp:1.4.2
或者提交程序时指定它的具体位置:spark-shell --jars spark-nlp.jar
一、该库的主要内容:
标记生成器
规范化
词干提取
Lemmatizer
实体提取器
日期提取器
Part of Speech Tagger
命名实体识别
句子边界检测
情感分析
拼写检查器
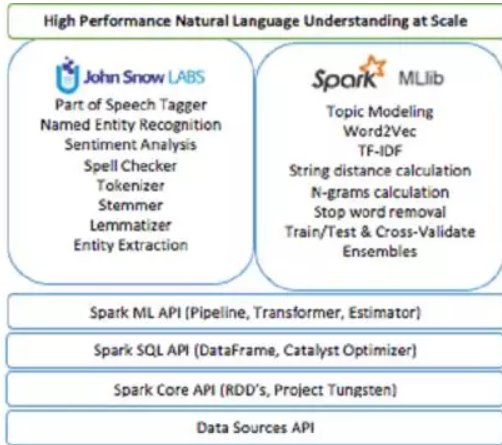
Spark ML提供了一套机器学习应用程序,它的逻辑由两个主要组件组成:估计器(Estimators)和 变换器(Transformers)。首先,有一个称为fit()的方法,将一段数据保存并传递给这样的应用程序,Transformer(一般是拟合过程的结果)将更改应用于目标数据集。这些组件已嵌入到适用于Spark NLP。
1.注释(Annotation)
注释是Spark-NLP操作结果的基本形式。它的结构是由:
annotatorType: 哪个注释器生成了这个注释
begin: 匹配的内容相对于原始文本的开始。
end: 匹配的内容相对于原始文本的结尾
metadata: 匹配结果的内容和附加信息
该对象在转换处理结束后由注释器自动生成。不需要手动参与。但为了有效地使用它,必须按照顺序理解。
2.注解器(Annotators)
注释器有两种形式:
注解器方法:代表Spark ML Estimator并需要一个训练stage。他们有一个称为fit(data)的函数,它根据一些数据来训练一个模型。他们生产第二种类型的注释器,它是一个注释器模型或转换器(transformer)。
Annotator模型:它们是spark模型或转换器(transformer),意味着它们具有一个transform(data)函数,它接受一个数据集并添加一个带有这个标注结果的列。所有转换器(transformer)都是附加的,这意味着它们附加到当前数据,决不会替换或删除以前的信息。
这两种形式的注释器都可以包含在Pipeline中,并且会自动按照提供的顺序遍历所有阶段并相应地转换数据。在fit()阶段之后,Pipeline变成了PipelineModel。无论是之前还是之后,可以随时保存到磁盘并重新从磁盘加载。
3.公共函数
setInputCols(column_names):获取此注释器所需的注释列名称
setOutputCol( column_name):定义包含此注释器结果的列的名称。使用此名称作为其他注释器的输入,需要注释这个注释器。
二、例子分析
1 注释器类型
每个注释器都有一个类型。这些共享类型的注释器可以互换使用,这意味着您可以在需要时使用它们中的任何一个。例如,当另一个注释器(如情感分析注释器)需要令牌类型注释器时,可以提供标normalized token或lemma,因为两者都是类型标记。
2 使用spark读入数据
我们例子测试采用的是spark-shell的方式,spark-2.1.1版本以上,本文采用的是spark2.1.2,scala版本2.11.8,启动:
spark-shell --jars /opt/jars/spark-nlp-1.2.3.jar
3.我们这里是先把数据赋值为名为data的变量
val data = spark.read.parquet("/opt/datas/*")
4 DocumentAssembler:获取数据
为何贯穿NLP处理过程,我们需要将原始数据进行标注。有一个特殊的transformer为我们做这件事情:DocumentAssembler,它会创建第一个类型为Document的注释,该注释会被以后的注解器使用。
import com.johnsnowlabs.nlp._

import com.johnsnowlabs.nlp.annotators._

import org.apache.spark.ml.Pipeline

val documentAssembler = new DocumentAssembler()

   .setInputCol("text")

   .setOutputCol("document")
5 句子检测及分词
在这个快速的例子中,我们现在开始在每个文档行中标识句子。SentenceDetectorModel需要一个由DocumentAssembler输出提供的Document注释,它本身是一个Document类型标记。RegexTokenizer需要一个Document注释类型,这意味着它与DocumentAssembler或SentenceDetector输出一起工作,在这里,我们使用句子输出。
import com.johnsnowlabs.nlp.annotators.sbd.pragmatic.SentenceDetectorModel

val sentenceDetector = new SentenceDetectorModel()

   .setInputCols(Array("document"))

   .setOutputCol("sentence")

val regexTokenizer = new RegexTokenizer()

   .setInputCols(Array("sentence"))

   .setOutputCol("token")
6 使用管道(pipeline)
现在我们要把所有这些放在一起并检索结果,我们使用Pipeline来做到这一点。我们还包含另一个特殊的变形器,称为“ Finisher”,以人类语言显示标记
val finisher = new Finisher()

   .setInputCols("token")

   .setCleanAnnotations(false)

val pipeline = new Pipeline()

   .setStages(Array(

       documentAssembler,

       sentenceDetector,

       regexTokenizer,

       finisher

   ))

pipeline

   .fit(data)

   .transform(data)

   .show()
基于Spark Mllib的Spark NLP库的更多相关文章
- Spark入门实战系列--8.Spark MLlib(上)--机器学习及SparkMLlib简介
[注]该系列文章以及使用到安装包/测试数据 可以在<倾情大奉送--Spark入门实战系列>获取 .机器学习概念 1.1 机器学习的定义 在维基百科上对机器学习提出以下几种定义: l“机器学 ...
- Spark MLlib介绍
Spark MLlib介绍 Spark之所以在机器学习方面具有得天独厚的优势,有以下几点原因: (1)机器学习算法一般都有很多个步骤迭代计算的过程,机器学习的计算需要在多次迭代后获得足够小的误差或者足 ...
- Spark MLlib机器学习
前言 Spark MLlib是Spark对常用的机器学习算法的实现库,同时包括相关的测试和数据生成器.
- 小记---------spark组件与其他组件的比较 spark/mapreduce ;spark sql/hive ; spark streaming/storm
Spark与Hadoop的对比 Scala是Spark的主要编程语言,但Spark还支持Java.Python.R作为编程语言 Hadoop的编程语言是Java
- spark MLlib实现的基于朴素贝叶斯(NaiveBayes)的中文文本自动分类
1.自动文本分类是对大量的非结构化的文字信息(文本文档.网页等)按照给定的分类体系,根据文字信息内容分到指定的类别中去,是一种有指导的学习过程. 分类过程采用基于统计的方法和向量空间模型可以对常见的文 ...
- Spark MLlib LDA 基于GraphX实现原理及源代码分析
LDA背景 LDA(隐含狄利克雷分布)是一个主题聚类模型,是当前主题聚类领域最火.最有力的模型之中的一个,它能通过多轮迭代把特征向量集合按主题分类.眼下,广泛运用在文本主题聚类中. LDA的开源实现有 ...
- Spark入门实战系列--8.Spark MLlib(下)--机器学习库SparkMLlib实战
[注]该系列文章以及使用到安装包/测试数据 可以在<倾情大奉送--Spark入门实战系列>获取 .MLlib实例 1.1 聚类实例 1.1.1 算法说明 聚类(Cluster analys ...
- 推荐系统那点事 —— 基于Spark MLlib的特征选择
在机器学习中,一般都会按照下面几个步骤:特征提取.数据预处理.特征选择.模型训练.检验优化.那么特征的选择就很关键了,一般模型最后效果的好坏往往都是跟特征的选择有关系的,因为模型本身的参数并没有太多优 ...
- 基于Spark Mllib的文本分类
基于Spark Mllib的文本分类 文本分类是一个典型的机器学习问题,其主要目标是通过对已有语料库文本数据训练得到分类模型,进而对新文本进行类别标签的预测.这在很多领域都有现实的应用场景,如新闻网站 ...
随机推荐
- Ajax.NET-Professional
https://github.com/michaelschwarz/Ajax.NET-Professional Ajax.NET Professional Ajax.NET Professional ...
- 洛谷p1008 三连击
https://www.luogu.org/problemnew/show/P1008 题目描述 将1,2,3,4,5,6,7,8,9共9个数分成3组,分别组成3个三位数,且使这3个三位数的值构成1: ...
- HTML5:使用Canvas和Input range控件放大缩小图片,剪裁,并上传图片
<!DOCTYPE html> <html> <head> <meta charset="utf-8"> <title> ...
- js之简单工厂模式
简单工厂模式是由一个方法来决定到底要创建哪个类的实例, 而这些实例经常都拥有相同的接口. 这种模式主要用在所实例化的类型在编译期并不能确定, 而是在执行期决定的情况. 说的通俗点,就像公司茶水间的饮料 ...
- springcloud:Eureka的使用
1.认识Eureka 服务的管理. 问题分析 在刚才的案例中,itcast-service-provider对外提供服务,需要对外暴露自己的地址.而consumer(调用者)需要记录服务提供者的地址. ...
- 配置android studio环境2
安装android studio 2.1运行 exe 程序 安装截图 备注 :O(∩_∩)O~等了 ,但是还是失败, 完全安装啊,不影响,可以手动运行安装目录下的 如:D:\Program Files ...
- 手机前端开发调试利器-vConsole
最近因为做抽奖页面,在android上可以使用手机连上电脑后用chrome浏览器chrome://inspect进行页面探测,但是ios中的页面就不能这样探测 在网上搜索后发现此插件,大大解决了问题 ...
- memcache 拓展
需要安装Libevent.memcached.memcache. 参考网址:https://www.cnblogs.com/hejun695/p/5369610.html 启动:/usr/local/ ...
- maven和java版本的对应关系
发布日期 版 必需的Java版本 链接 2018年6月21日 3.5.4 Java 7 宣布,发布说明,参考文档 2018年3月8日 3.5.3 宣布,发布说明,参考文档 2017年10月24日 ...
- JS---案例:手风琴 (利用封装好的动画函数)
案例:手风琴 封装好的动画函数在common.js里面 //function getStyle(element, attr) {...} //function animate( ...