
Scrapy爬取多层级网页内容的方式
# -*- coding: utf-8 -*-

import scrapy

from Avv.items import AvvItem

class AvSpider(scrapy.Spider):

    name = 'av' # 爬虫名

    allowed_domains = ['51porn.net/'] # 爬虫作用域

    # 爬取第2页到最后一页的代码

    url = 'http://www.51porn.net/nvyoudaquan/index_{}.html' # 起始url,并用花括号格式化

    offset = 2 # 偏移量

    start_urls = [url.format(str(offset))] # 拼接为完整url

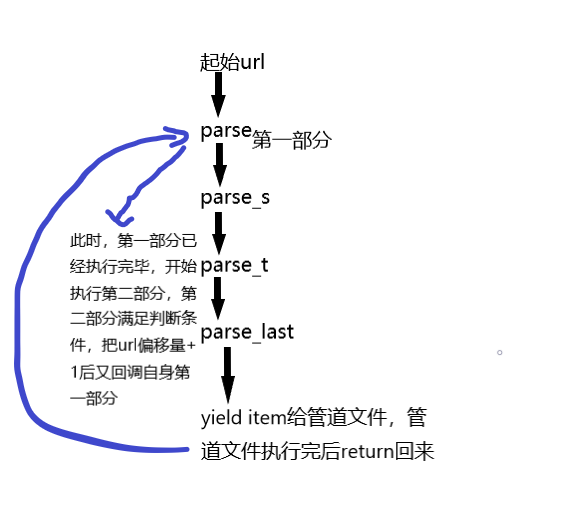
    def parse(self, response): # 第一个parse,从中提取下一层url

     # 第一部分

        links = response.xpath("//ul[@class='clearfix']/li/a/@href").extract() # 利用xpath提取下一层的url列表,并用extract转换为字符串

        for link in links: # 遍历上个列表

            url = "http://www.51porn.net" + link # 由于提取出来的url不完整,所以需要拼接为完整的url

            yield scrapy.Request(url,callback=self.parse_s,dont_filter=True) # 请求下一层url,方法为第二个parse,dont_filter=True的作用是避免有时候新的url会被作用域过滤掉

    # 第二部分

        m_page = 26 # 这里设置的是第一层的url有多少页

        if self.offset<m_page: # 如果当前页小于最大页

            self.offset += 1 # 偏移量自增1

            yield scrapy.Request(self.url.format(str(self.offset)),callback=self.parse,dont_filter=True) # 再此请求第一层的新的url

    def parse_s(self, response):

        link = response.xpath("//div[@class='wrap loadimg avlist-small']/ul/li[1]/a/@href").extract()[0] # 提取第2层url

        url = "http://www.51porn.net" + link # 拼接为新的url

        yield scrapy.Request(url,callback=self.parse_t,dont_filter=True) # 请求第3个parse

    def parse_t(self, response):

        links = response.xpath("//ul[@class='alllist clearfix']/li/a/@href").extract() # 提取第3层url

        for link in links:

            url = "http://www.51porn.net" + link # 拼接为新的url

            yield scrapy.Request(url,callback=self.parse_last,dont_filter=True) # 请求最后的parse

    def parse_last(self, response):

        item = AvvItem() # 实例一个引入的字典类对象

        node_list = response.xpath("//div[@class='content loadimg wow fadeInUp']")

        for node in node_list:

            # 提取以下具体信息

            item["m_num"] = node.xpath("./p[1]/text()").extract()[0]

            item["m_name"] = node.xpath("./p[2]/text()").extract()[0]

            item["s_name"] = node.xpath("./p[3]/a/text()").extract()[0]

            item["i_date"] = node.xpath("./p[4]/text()").extract()[0]

            item["l_work"] = node.xpath("./p[5]/text()").extract()[0]

            item["m_style"] = node.xpath("./p[7]/text()").extract()[0] if len(node.xpath("./p[7]/text()"))>0 else "无" # 判断此信息是否为空值

            item["c_work"] = node.xpath("./p[8]/img/@src").extract()[0]

        yield item # 返回
Scrapy爬取多层级网页内容的方式的更多相关文章
- 【转载】教你分分钟学会用python爬虫框架Scrapy爬取心目中的女神
原文:教你分分钟学会用python爬虫框架Scrapy爬取心目中的女神 本博文将带领你从入门到精通爬虫框架Scrapy,最终具备爬取任何网页的数据的能力.本文以校花网为例进行爬取,校花网:http:/ ...
- Scrapy爬取美女图片第四集 突破反爬虫(上)
本周又和大家见面了,首先说一下我最近正在做和将要做的一些事情.(我的新书<Python爬虫开发与项目实战>出版了,大家可以看一下样章) 技术方面的事情:本次端午假期没有休息,正在使用fl ...
- Scrapy爬取美女图片续集 (原创)
上一篇咱们讲解了Scrapy的工作机制和如何使用Scrapy爬取美女图片,而今天接着讲解Scrapy爬取美女图片,不过采取了不同的方式和代码实现,对Scrapy的功能进行更深入的运用.(我的新书< ...
- python scrapy爬取HBS 汉堡南美航运公司柜号信息
下面分享个scrapy的例子 利用scrapy爬取HBS 船公司柜号信息 1.前期准备 查询提单号下的柜号有哪些,主要是在下面的网站上,输入提单号,然后点击查询 https://www.hamburg ...
- Python——Scrapy爬取链家网站所有房源信息
用scrapy爬取链家全国以上房源分类的信息: 路径: items.py # -*- coding: utf-8 -*- # Define here the models for your scrap ...
- scrapy爬取cnblogs文章列表
scrapy爬取cnblogs文章 目标任务 安装爬虫 创建爬虫 编写 items.py 编写 spiders/cnblogs.py 编写 pipelines.py 编写 settings.py 运行 ...
- 小说免费看!python爬虫框架scrapy 爬取纵横网
前言 文的文字及图片来源于网络,仅供学习.交流使用,不具有任何商业用途,版权归原作者所有,如有问题请及时联系我们以作处理. 作者: 风,又奈何 PS:如有需要Python学习资料的小伙伴可以加点击下方 ...
- scrapy爬取海量数据并保存在MongoDB和MySQL数据库中
前言 一般我们都会将数据爬取下来保存在临时文件或者控制台直接输出,但对于超大规模数据的快速读写,高并发场景的访问,用数据库管理无疑是不二之选.首先简单描述一下MySQL和MongoDB的区别:MySQ ...
- Scrapy爬取美女图片 (原创)
有半个月没有更新了,最近确实有点忙.先是华为的比赛,接着实验室又有项目,然后又学习了一些新的知识,所以没有更新文章.为了表达我的歉意,我给大家来一波福利... 今天咱们说的是爬虫框架.之前我使用pyt ...
随机推荐
- mongodb-CURD
插入 import pymongo conn = pymongo.MongoClient('mongodb://192.168.10.10:27017') mydb = conn['myDB'] my ...
- Python标准库time
原文:http://www.cnblogs.com/qq78292959/archive/2013/03/22/2975786.html Python官方文档 在程序中,免不了和时间打交道,要学习ti ...
- kojs select绑值(工作)
<!DOCTYPE html> <html> <head> <meta charset="utf-8" /> <tit ...
- springMVC-RESTful支持
RESTful支持 什么是restful? Restful就是一个资源定位及资源操作的风格.不是标准也不是协议,只是一种风格,是对http协议的诠释. 资源定位:互联网所有的事物都是资源,要求url中 ...
- 利用Common-Fileupload上传文件图片
一,介绍 common-fileupload是appache的开源组件,基于该组件可以轻松实现文件上传的功能,strust框架的文件上传功能也是基于该组件. 二,使用 1,导入两个jar包:commo ...
- C51存储的优化
我们知道51单片机只有128BYTE的RAM, 有的增强型有XRAM,此时编程时就要注意,否则就有可能超出空间 1 对于各模块的全局变量.静态变量.全局枚举型常量,静态枚举型常量.个别操作存储(如外部 ...
- Rasheda And The Zeriba Gym - 100283A 计算几何
http://codeforces.com/gym/100283/problem/A 考虑到多边形是不稳定的,是可以变来变去的. 那么总是可以把每个点放到圆上. 所以只需要判断圆心角是不是小于等于36 ...
- java threadLocal的初探
在网上找了半天,终于找到一篇靠谱的文章了. 文章地址:http://qifuguang.me/2015/09/02/[Java%E5%B9%B6%E5%8F%91%E5%8C%85%E5%AD%A6% ...
- Genymotion的安装与设置
Genymotion是一款非常好用的虚拟机,利用它可以在window.Liunx或MAC系统上实现Android的模似器.对于开发人员来说,有了Android模似器,就可以在电脑上实时调试安卓app, ...
- uvm_monitor——借我一双慧眼
monitor 用来捕获(监视)和检查总线的信号是否满足预期的要求.所有的user_monitor 继承自uvm_monitor,uvm_monitor继承自uvm_component,从源代码来看里 ...