
python scrapy爬取HBS 汉堡南美航运公司柜号信息
下面分享个scrapy的例子
利用scrapy爬取HBS 船公司柜号信息
1、前期准备
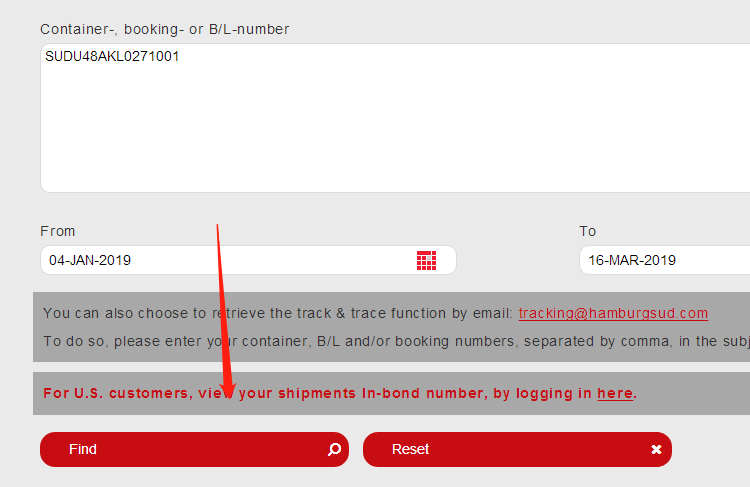
查询提单号下的柜号有哪些,主要是在下面的网站上,输入提单号,然后点击查询
https://www.hamburgsud-line.com/liner/en/liner_services/ecommerce/track_trace/index.html
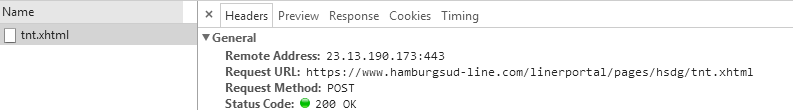
通过浏览器的network,我们可以看到,请求的是如下的网址
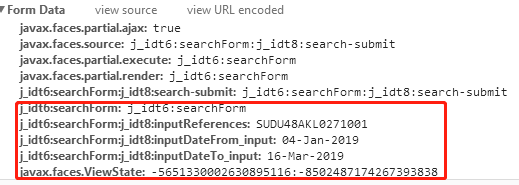
请求的参数如下,可以看到其中一些参数是固定的,一些是变化的(下图红框中的数据),而这些变化的参数大部分是在页面上,我们可以先请求一下这个页面,获取其中提交的参数,然后再提交
2编写爬虫
2.1首先,我们请求一下这个页面,然后获取其中的一些变化的参数,把获取到的参数组合起来
# -*- coding: utf-8 -*-
import scrapy
from scrapy.http import Request, FormRequest

class HbsSpider(scrapy.Spider):
    name = "hbs"
    allowed_domains = ["www.hamburgsud-line.com"]
def start_requests(self):

        yield Request(self.post_url, callback=self.post)
def post(self, response):

        sel = response.css('input')

        keys = sel.xpath('./@name').extract()

        values = sel.xpath('./@value').extract()

        inputData = dict(zip(keys, values))
2.2 再次请求数据
1、把固定不变的参数和页面获取到的参数一起提交
2、再把header伪装一下
    post_url = 'https://www.hamburgsud-line.com/linerportal/pages/hsdg/tnt.xhtml'

def post(self, response):

        sel = response.css('input')

        keys = sel.xpath('./@name').extract()

        values = sel.xpath('./@value').extract()

        inputData = dict(zip(keys, values))

        # 提交页面的解析函数,构造FormRequest对象提交表单

        fd = {'javax.faces.partial.ajax': 'true',

                  'javax.faces.source': 'j_idt6:searchForm:j_idt8:search-submit',

                  'javax.faces.partial.execute': 'j_idt6:searchForm',

                  'javax.faces.partial.render': 'j_idt6:searchForm',

                  'j_idt6:searchForm:j_idt8:search-submit': 'j_idt6:searchForm:j_idt8:search-submit',

                  # 'j_idt6:searchForm': 'j_idt6:searchForm',

                  'j_idt6:searchForm:j_idt8:inputReferences': self.blNo,

                  # 'j_idt6:searchForm:j_idt8:inputDateFrom_input': '04-Jan-2019',

                  # 'j_idt6:searchForm:j_idt8:inputDateTo_input': '16-Mar-2019',

                  # 'javax.faces.ViewState': '-2735644008488912659:3520516384583764336'

                  }

        fd.update(inputData)

        headers = {

            ':authority': 'www.hamburgsud-line.com',

            ':method': 'POST',

            ':path': '/linerportal/pages/hsdg/tnt.xhtml',

            ':scheme':'https',

            # 'accept': 'application/xml,text/xml,*/*;q=0.01',

            # 'accept-language':'zh-CN,zh;q=0.8',

            'content-type':'application/x-www-form-urlencoded; charset=UTF-8',

            'faces-request': 'partial/ajax',

            'origin':'https://www.hamburgsud-line.com',

            'referer':'https://www.hamburgsud-line.com/linerportal/pages/hsdg/tnt.xhtml',

            'user-agent':'Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/55.0.2883.87 Safari/537.36',

            'x-requested-with':'XMLHttpRequest'

        }

        yield FormRequest.from_response(response, formdata=fd,callback=self.parse_post,headers=headers)
3、解析数据
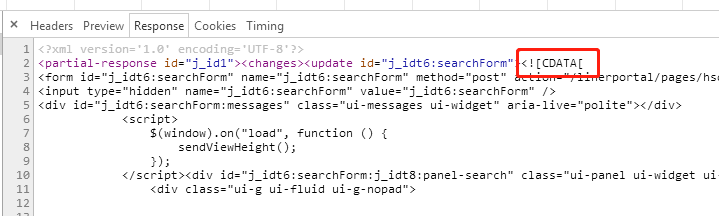
3.1我们可以看到返回的数据是在XML的CDATA下,第一步,我们从中先把这个form获取出来,
    def parse_post(self, response):

        # 提交成功后,继续爬取start_urls 中的页面

        text = response.text;

        xml_data = minidom.parseString(text).getElementsByTagName('update')

        if len(xml_data) > 0:

            # form = xml_data[0].textContent

            form = xml_data[0].firstChild.wholeText
3.2我们定位到柜的元素里面,因为经常一个提单下会有很多柜,如果直接用网站自动生成的id号去查找,后面用其他的提单号去爬取的时候,解析可能就有问题了
所以我们不用id去定位,改为其他方式
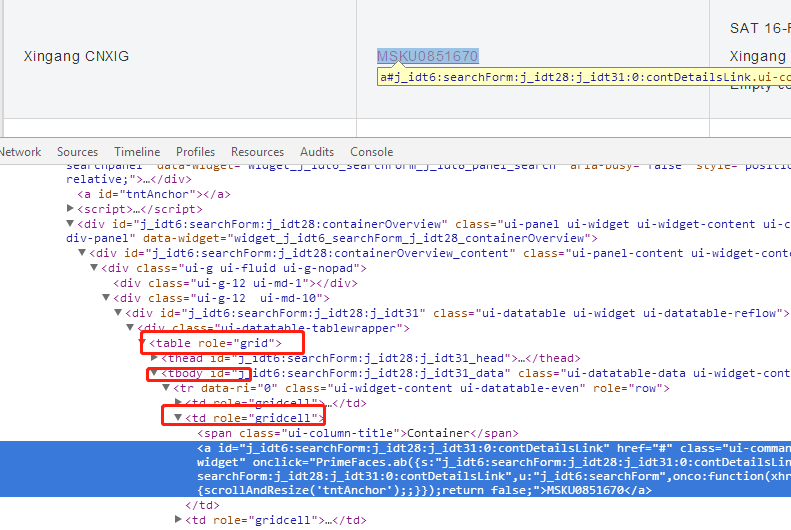
selector = Selector(text=form)

            trs = selector.css("table[role=grid] tbody tr")

            for i in range(len(trs)):

                print(trs[i])

                td = trs[i].css("td:nth-child(2)>a::text")

                yield  {

                    'containerNo' : td.extract()

                }
4、运行
>scrapy crawl hbs -o hbs.json
可以看到,爬取到的数据如下
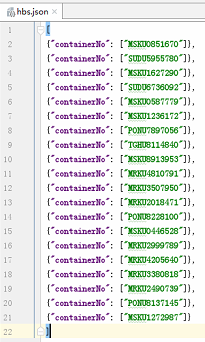
PS:记得把设置里面的ROBOT协议改成False,否则可能失败
ROBOTSTXT_OBEY = False
5.代码
# -*- coding: utf-8 -*-

import scrapy

from scrapy.http import Request, FormRequest

from xml.dom import minidom

from scrapy.selector import Selector

class HbsSpider(scrapy.Spider):

    name = "hbs"

    allowed_domains = ["www.hamburgsud-line.com"]

    #start_urls = ['https://www.hamburgsud-line.com/linerportal/pages/hsdg/tnt.xhtml']

    def __init__(self, blNo='SUDU48AKL0271001', *args, **kwargs):

        self.blNo = blNo

    # ----------------------------提交---------------------------------

    # 提交页面的url

    post_url = 'https://www.hamburgsud-line.com/linerportal/pages/hsdg/tnt.xhtml'

    def start_requests(self):

        yield Request(self.post_url, callback=self.post)

    def post(self, response):

        sel = response.css('input')

        keys = sel.xpath('./@name').extract()

        values = sel.xpath('./@value').extract()

        inputData = dict(zip(keys, values))

        # 提交页面的解析函数,构造FormRequest对象提交表单

        if "j_idt6:searchForm" in inputData:

            fd = {'javax.faces.partial.ajax': 'true',

                  'javax.faces.source': 'j_idt6:searchForm:j_idt8:search-submit',

                  'javax.faces.partial.execute': 'j_idt6:searchForm',

                  'javax.faces.partial.render': 'j_idt6:searchForm',

                  'j_idt6:searchForm:j_idt8:search-submit': 'j_idt6:searchForm:j_idt8:search-submit',

                  # 'j_idt6:searchForm': 'j_idt6:searchForm',

                  'j_idt6:searchForm:j_idt8:inputReferences': self.blNo,

                  # 'j_idt6:searchForm:j_idt8:inputDateFrom_input': '04-Jan-2019',

                  # 'j_idt6:searchForm:j_idt8:inputDateTo_input': '16-Mar-2019',

                  # 'javax.faces.ViewState': '-2735644008488912659:3520516384583764336'

                  }

        else:

            fd = {'javax.faces.partial.ajax': 'true',

                  'javax.faces.source': 'j_idt7:searchForm: j_idt9:search - submit',

                  'javax.faces.partial.execute': 'j_idt7:searchForm',

                  'javax.faces.partial.render': 'j_idt7:searchForm',

                  'j_idt7:searchForm:j_idt9:search-submit': 'j_idt7:searchForm:j_idt9:search-submit',

                  # 'javax.faces.ViewState:': '-1349351850393148019:-4619609355387768827',

                  # 'j_idt7:searchForm:': 'j_idt7:searchForm',

                  # 'j_idt7:searchForm:j_idt9:inputDateFrom_input':'13-Dec-2018',

                  # 'j_idt7:searchForm:j_idt9:inputDateTo_input':'22-Feb-2019',

                  'j_idt7:searchForm:j_idt9:inputReferences': self.blNo

                  }

        fd.update(inputData)

        headers = {

            ':authority': 'www.hamburgsud-line.com',

            ':method': 'POST',

            ':path': '/linerportal/pages/hsdg/tnt.xhtml',

            ':scheme':'https',

            # 'accept': 'application/xml,text/xml,*/*;q=0.01',

            # 'accept-language':'zh-CN,zh;q=0.8',

            'content-type':'application/x-www-form-urlencoded; charset=UTF-8',

            'faces-request': 'partial/ajax',

            'origin':'https://www.hamburgsud-line.com',

            'referer':'https://www.hamburgsud-line.com/linerportal/pages/hsdg/tnt.xhtml',

            'user-agent':'Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/55.0.2883.87 Safari/537.36',

            'x-requested-with':'XMLHttpRequest'

        }

        yield FormRequest.from_response(response, formdata=fd,callback=self.parse_post,headers=headers)

    def parse_post(self, response):

        # 提交成功后,继续爬取start_urls 中的页面

        text = response.text;

        xml_data = minidom.parseString(text).getElementsByTagName('update')

        if len(xml_data) > 0:

            # form = xml_data[0].textContent

            form = xml_data[0].firstChild.wholeText

            selector = Selector(text=form)

            trs = selector.css("table[role=grid] tbody tr")

            for i in range(len(trs)):

                print(trs[i])

                td = trs[i].css("td:nth-child(2)>a::text")

                yield  {

                    'containerNo' : td.extract()

                }
python scrapy爬取HBS 汉堡南美航运公司柜号信息的更多相关文章
- Python——Scrapy爬取链家网站所有房源信息
用scrapy爬取链家全国以上房源分类的信息: 路径: items.py # -*- coding: utf-8 -*- # Define here the models for your scrap ...
- Python scrapy爬取带验证码的列表数据
首先所需要的环境:(我用的是Python2的,可以选择python3,具体遇到的问题自行解决,目前我这边几百万的数据量爬取) 环境: Python 2.7.10 Scrapy Scrapy 1.5.0 ...
- 使用python scrapy爬取知乎提问信息
前文介绍了python的scrapy爬虫框架和登录知乎的方法. 这里介绍如何爬取知乎的问题信息,并保存到mysql数据库中. 首先,看一下我要爬取哪些内容: 如下图所示,我要爬取一个问题的6个信息: ...
- python scrapy 爬取西刺代理ip(一基础篇)(ubuntu环境下) -赖大大
第一步:环境搭建 1.python2 或 python3 2.用pip安装下载scrapy框架 具体就自行百度了,主要内容不是在这. 第二步:创建scrapy(简单介绍) 1.Creating a p ...
- python scrapy爬取知乎问题和收藏夹下所有答案的内容和图片
上文介绍了爬取知乎问题信息的整个过程,这里介绍下爬取问题下所有答案的内容和图片,大致过程相同,部分核心代码不同. 爬取一个问题的所有内容流程大致如下: 一个问题url 请求url,获取问题下的答案个数 ...
- Python Scrapy 爬取煎蛋网妹子图实例(二)
上篇已经介绍了 图片的爬取,后来觉得不太好,每次爬取的图片 都在一个文件下,不方便区分,且数据库中没有爬取的时间标识,不方便后续查看 数据时何时爬取的,所以这里进行了局部修改 修改一:修改爬虫执行方式 ...
- Python Scrapy 爬取煎蛋网妹子图实例(一)
前面介绍了爬虫框架的一个实例,那个比较简单,这里在介绍一个实例 爬取 煎蛋网 妹子图,遗憾的是 上周煎蛋网还有妹子图了,但是这周妹子图变成了 随手拍, 不过没关系,我们爬图的目的是为了加强实战应用,管 ...
- python+scrapy 爬取西刺代理ip(一)
转自:https://www.cnblogs.com/lyc642983907/p/10739577.html 第一步:环境搭建 1.python2 或 python3 2.用pip安装下载scrap ...
- python scrapy爬取前程无忧招聘信息
使用scrapy框架之前,使用以下命令下载库: pip install scrapy -i https://pypi.tuna.tsinghua.edu.cn/simple 1.创建项目文件夹 scr ...
随机推荐
- 3D立体方块旋转图册
代码可直接复制使用看效果 这个文章参考了Lazy.Cat的文章:https://www.cnblogs.com/Lazy-Cat/p/9750244.html,大家也可以去看看,他讲的还是比较详细的. ...
- Vue学习之路第十篇:简单计算器的实现
前面九篇讲解了vue的一些基础知识,正所谓:学以致用,今天我们将用前九篇的基础知识,来模拟实现计算器的简单功能,项目价值不高,纯粹是为了加深掌握所学知识. 学前准备: 需要掌握JavaScript的e ...
- DOM元素属性值如果设置为对象
结论:内部会调用toString方法,将设置的对象转换为字符串添加给相应的属性: 这个问题呢,是通过jQuery的each方法中,回调函数的this指向问题而来: 我们知道,回调函数中的this如果指 ...
- BZOJ 4372/3370 烁烁的游戏/震波 (动态点分治+线段树)
烁烁的游戏 题目大意: 给你一棵$n$个节点的树,有$m$次操作,询问某个节点的权值,或者将与某个点$x$距离不超过$d$的所有节点的权值都增加$w$ 动态点分裸题 每个节点开一棵权值线段树 对于修改 ...
- tensorflow之tf.slice()
转载:https://www.jianshu.com/p/71e6ef6c121b https://www.cnblogs.com/chamie/p/11073363.html def slice(i ...
- 更新Maven的本地库
1. 更新Maven的本地库 通常情况下,可改变默认的 .m2 目录下的默认本地存储库文件夹到其他更有意义的名称,例如, maven-repo 找到 {M2_HOME}\conf\setting.xm ...
- python中try…except的使用,处理程序异常
通常情况下,在python中运行程序,多多少少会出现程序异常的问题,try……except能很好的解决程序中的异常.以下是其用法,在不同位置时进行什么样的工作和起到什么样的作用. try: 可能出现异 ...
- mysql linux查看配置文件my.cnf位置
原文:mysql linux查看配置文件my.cnf位置 命令: mysql --help | grep 'Default options' -A 1
- excel2013超链接进不去,提示“您的组织策略不允许...”
搜索regedit 然后找到HKEY_CURRENT_USER->Software->Classes->.html 右键修改或者双击修改数值数据为Htmlfile 关闭之后此窗口,关 ...
- 【codeforces 508E】Artur and Brackets
[题目链接]:http://codeforces.com/problemset/problem/508/E [题意] 让你构造一个括号字符串; 使得每个从左往右数第i个左括号在这个括号序列中与之匹配的 ...