
Spark 系列(一)—— Spark简介
一、简介
Spark 于 2009 年诞生于加州大学伯克利分校 AMPLab,2013 年被捐赠给 Apache 软件基金会,2014 年 2 月成为 Apache 的顶级项目。相对于 MapReduce 的批处理计算,Spark 可以带来上百倍的性能提升,因此它成为继 MapReduce 之后,最为广泛使用的分布式计算框架。
二、特点
Apache Spark 具有以下特点:
- 使用先进的 DAG 调度程序,查询优化器和物理执行引擎,以实现性能上的保证;
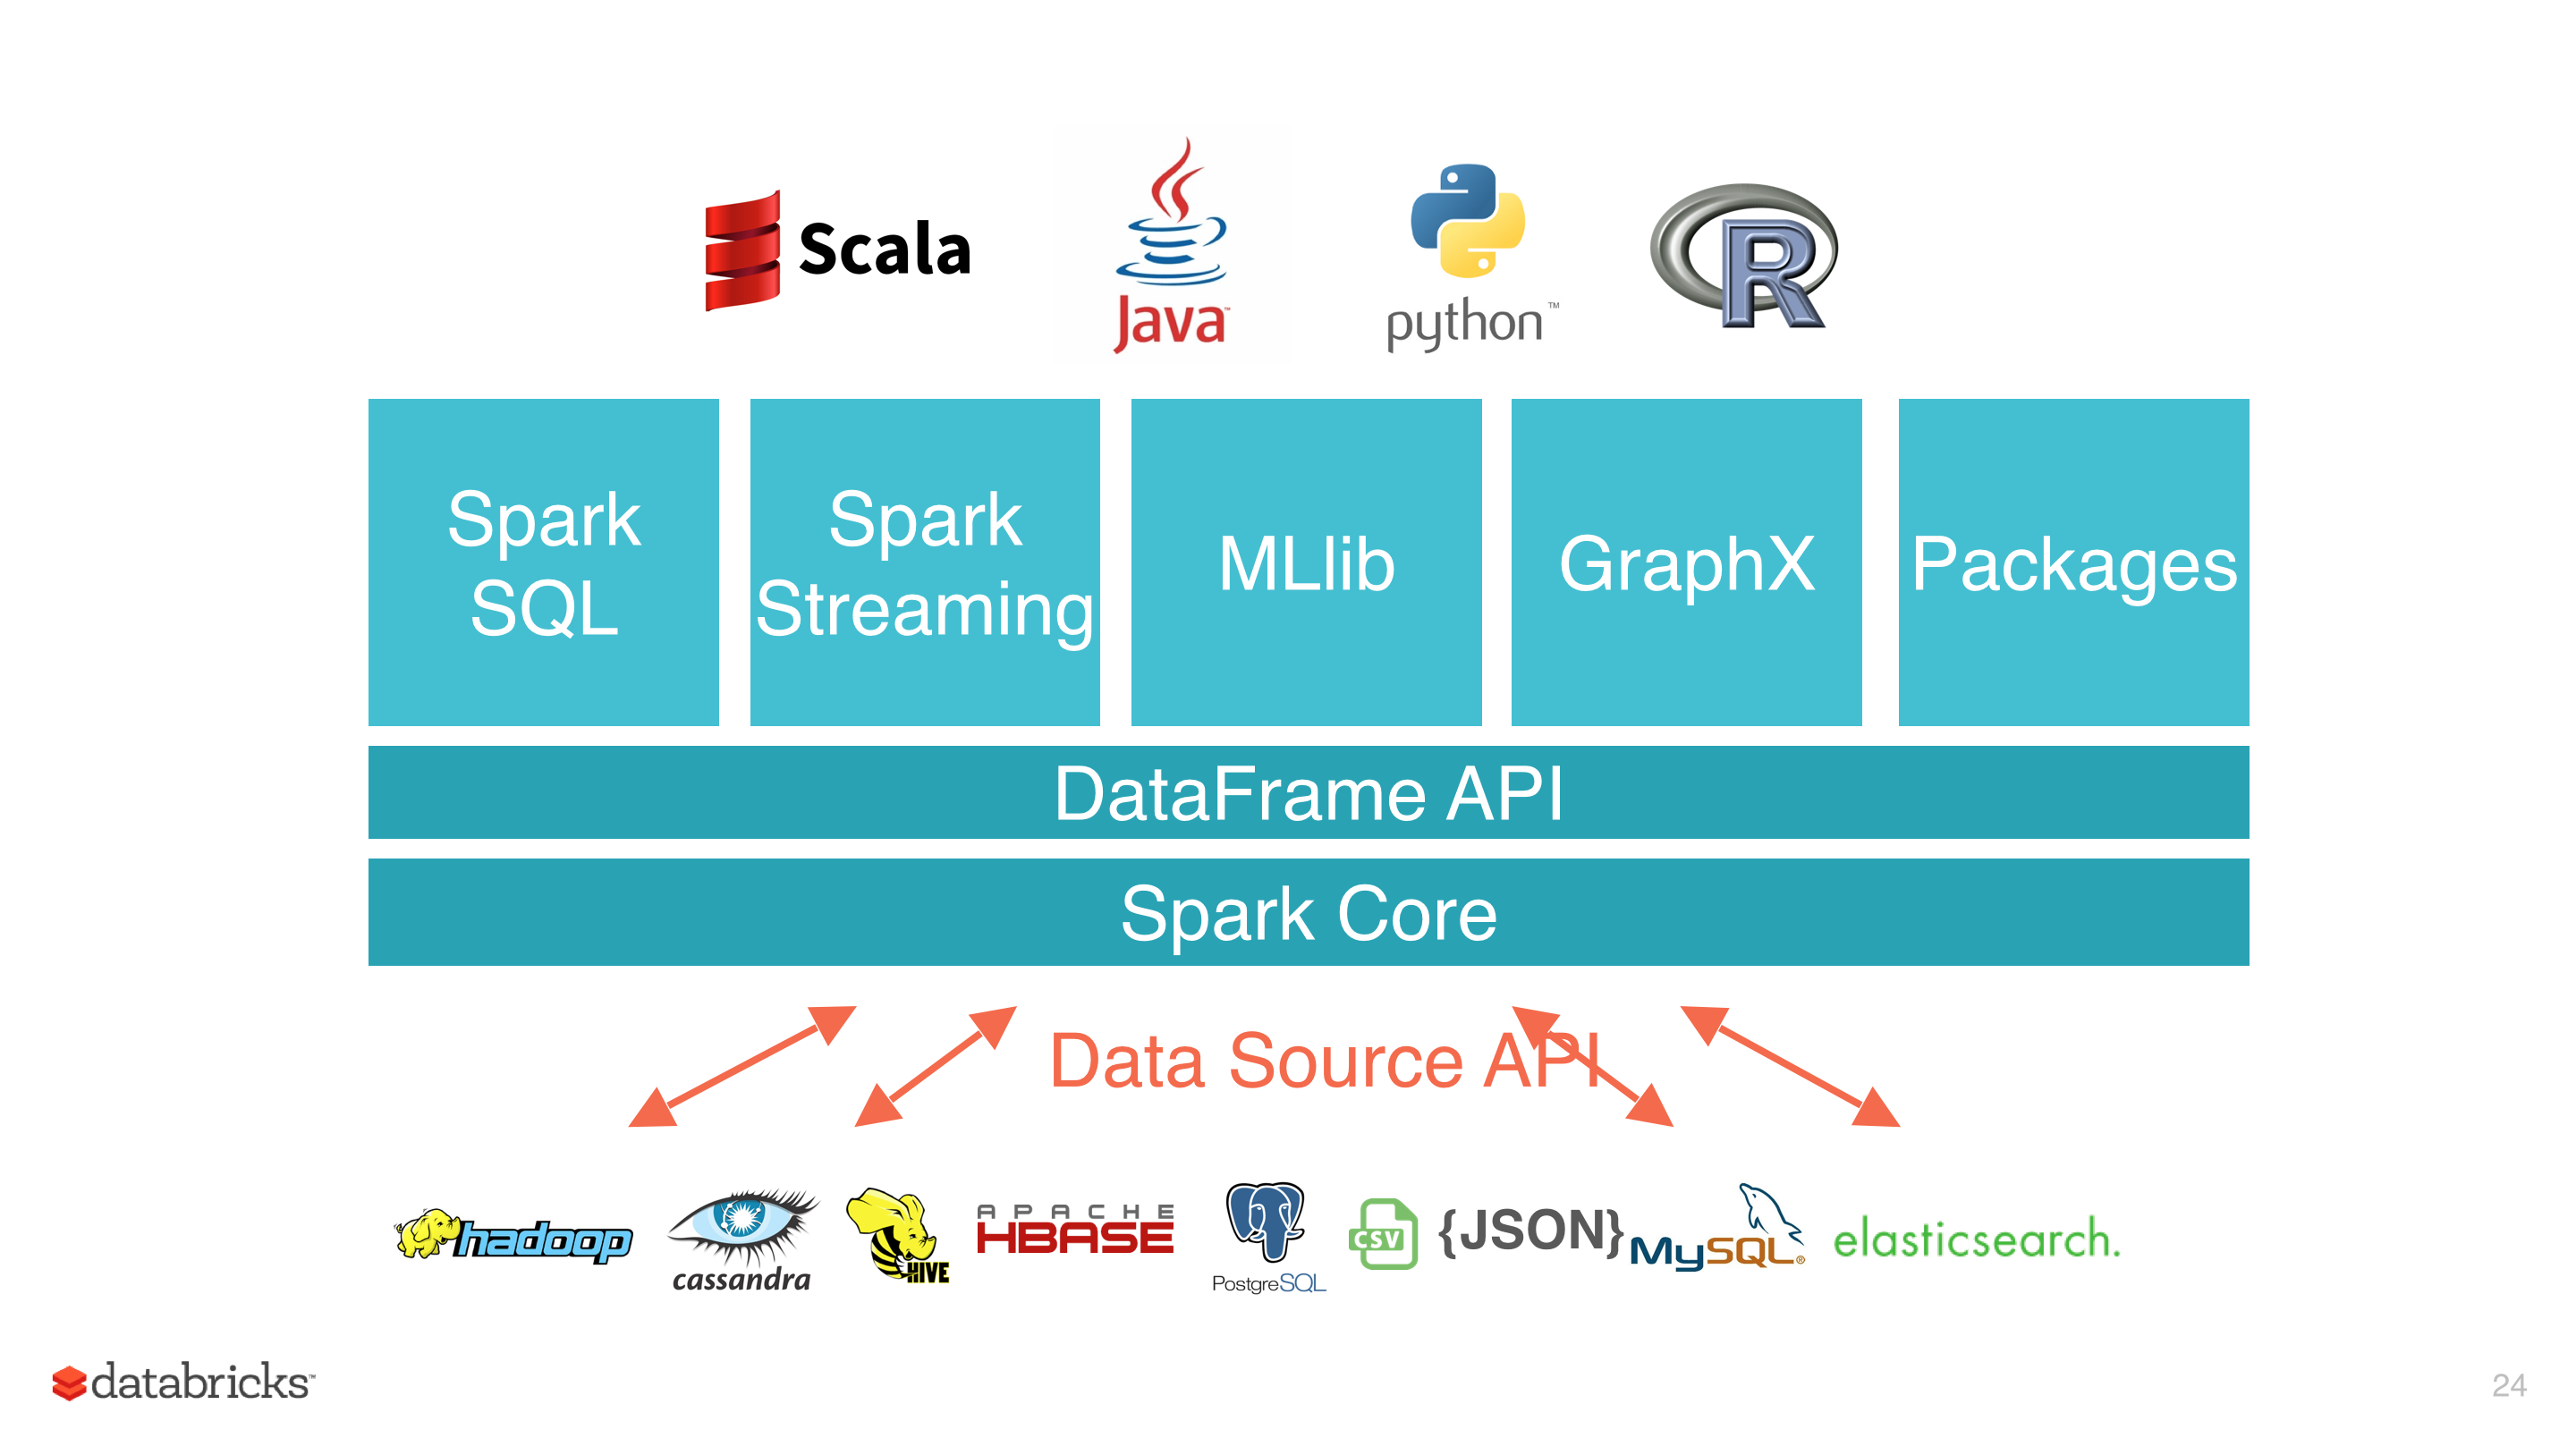
- 多语言支持,目前支持的有 Java,Scala,Python 和 R;
- 提供了 80 多个高级 API,可以轻松地构建应用程序;
- 支持批处理,流处理和复杂的业务分析;
- 丰富的类库支持:包括 SQL,MLlib,GraphX 和 Spark Streaming 等库,并且可以将它们无缝地进行组合;
- 丰富的部署模式:支持本地模式和自带的集群模式,也支持在 Hadoop,Mesos,Kubernetes 上运行;
- 多数据源支持:支持访问 HDFS,Alluxio,Cassandra,HBase,Hive 以及数百个其他数据源中的数据。
三、集群架构
| Term(术语) | Meaning(含义) |
|---|---|
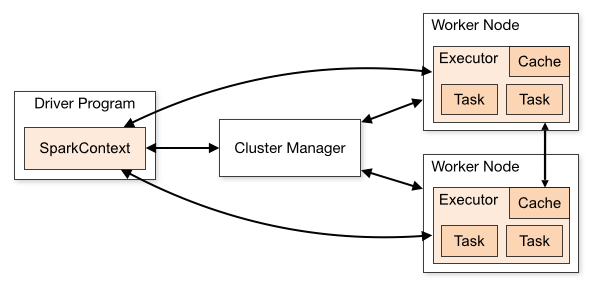
| Application | Spark 应用程序,由集群上的一个 Driver 节点和多个 Executor 节点组成。 |
| Driver program | 主运用程序,该进程运行应用的 main() 方法并且创建 SparkContext |
| Cluster manager | 集群资源管理器(例如,Standlone Manager,Mesos,YARN) |
| Worker node | 执行计算任务的工作节点 |
| Executor | 位于工作节点上的应用进程,负责执行计算任务并且将输出数据保存到内存或者磁盘中 |
| Task | 被发送到 Executor 中的工作单元 |
执行过程:
- 用户程序创建 SparkContext 后,它会连接到集群资源管理器,集群资源管理器会为用户程序分配计算资源,并启动 Executor;
- Dirver 将计算程序划分为不同的执行阶段和多个 Task,之后将 Task 发送给 Executor;
- Executor 负责执行 Task,并将执行状态汇报给 Driver,同时也会将当前节点资源的使用情况汇报给集群资源管理器。
四、核心组件
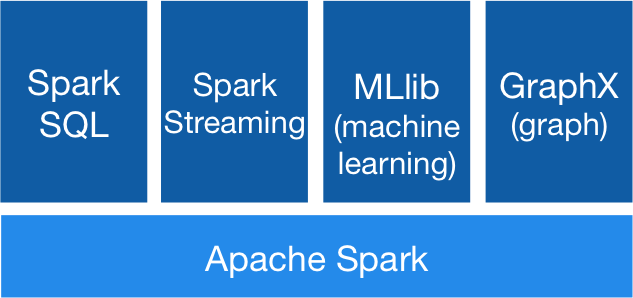
Spark 基于 Spark Core 扩展了四个核心组件,分别用于满足不同领域的计算需求。
3.1 Spark SQL
Spark SQL 主要用于结构化数据的处理。其具有以下特点:
- 能够将 SQL 查询与 Spark 程序无缝混合,允许您使用 SQL 或 DataFrame API 对结构化数据进行查询;
- 支持多种数据源,包括 Hive,Avro,Parquet,ORC,JSON 和 JDBC;
- 支持 HiveQL 语法以及用户自定义函数 (UDF),允许你访问现有的 Hive 仓库;
- 支持标准的 JDBC 和 ODBC 连接;
- 支持优化器,列式存储和代码生成等特性,以提高查询效率。
3.2 Spark Streaming
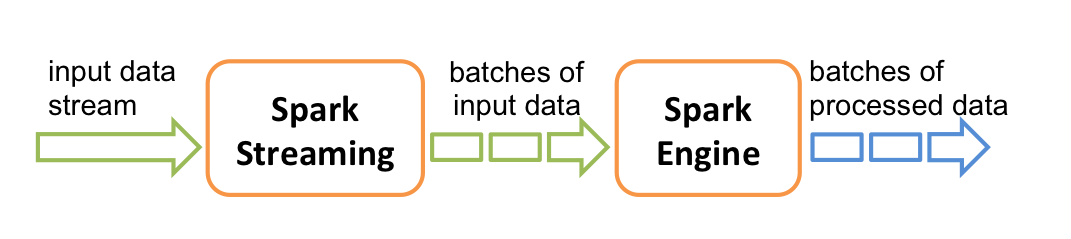
Spark Streaming 主要用于快速构建可扩展,高吞吐量,高容错的流处理程序。支持从 HDFS,Flume,Kafka,Twitter 和 ZeroMQ 读取数据,并进行处理。
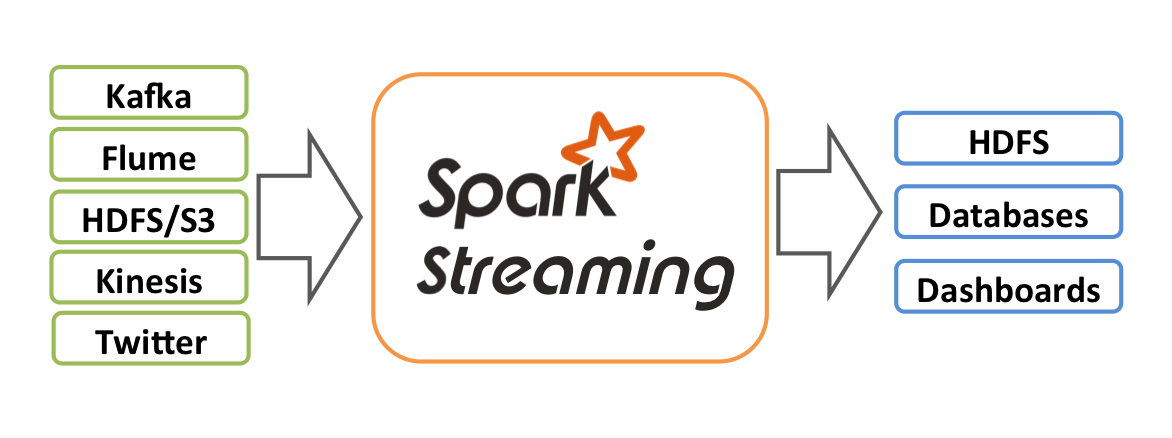
Spark Streaming 的本质是微批处理,它将数据流进行极小粒度的拆分,拆分为多个批处理,从而达到接近于流处理的效果。
3.3 MLlib
MLlib 是 Spark 的机器学习库。其设计目标是使得机器学习变得简单且可扩展。它提供了以下工具:
- 常见的机器学习算法:如分类,回归,聚类和协同过滤;
- 特征化:特征提取,转换,降维和选择;
- 管道:用于构建,评估和调整 ML 管道的工具;
- 持久性:保存和加载算法,模型,管道数据;
- 实用工具:线性代数,统计,数据处理等。
3.4 Graphx
GraphX 是 Spark 中用于图形计算和图形并行计算的新组件。在高层次上,GraphX 通过引入一个新的图形抽象来扩展 RDD(一种具有附加到每个顶点和边缘的属性的定向多重图形)。为了支持图计算,GraphX 提供了一组基本运算符(如: subgraph,joinVertices 和 aggregateMessages)以及优化后的 Pregel API。此外,GraphX 还包括越来越多的图形算法和构建器,以简化图形分析任务。
更多大数据系列文章可以参见 GitHub 开源项目: 大数据入门指南
Spark 系列(一)—— Spark简介的更多相关文章
- Spark系列—02 Spark程序牛刀小试
一.执行第一个Spark程序 1.执行程序 我们执行一下Spark自带的一个例子,利用蒙特·卡罗算法求PI: 启动Spark集群后,可以在集群的任何一台机器上执行一下命令: /home/spark/s ...
- Spark系列—01 Spark集群的安装
一.概述 关于Spark是什么.为什么学习Spark等等,在这就不说了,直接看这个:http://spark.apache.org, 我就直接说一下Spark的一些优势: 1.快 与Hadoop的Ma ...
- Spark入门实战系列--1.Spark及其生态圈简介
[注]该系列文章以及使用到安装包/测试数据 可以在<倾情大奉送--Spark入门实战系列>获取 .简介 1.1 Spark简介 年6月进入Apache成为孵化项目,8个月后成为Apache ...
- Spark入门实战系列--8.Spark MLlib(上)--机器学习及SparkMLlib简介
[注]该系列文章以及使用到安装包/测试数据 可以在<倾情大奉送--Spark入门实战系列>获取 .机器学习概念 1.1 机器学习的定义 在维基百科上对机器学习提出以下几种定义: l“机器学 ...
- 小白学习Spark系列一:Spark简介
由于最近在工作中刚接触到scala和Spark,并且作为python中毒者,爬行过程很是艰难,所以这一系列分为几个部分记录下学习<Spark快速大数据分析>的知识点以及自己在工程中遇到的小 ...
- Spark入门实战系列--7.Spark Streaming(上)--实时流计算Spark Streaming原理介绍
[注]该系列文章以及使用到安装包/测试数据 可以在<倾情大奉送--Spark入门实战系列>获取 .Spark Streaming简介 1.1 概述 Spark Streaming 是Spa ...
- Spark 系列(八)—— Spark SQL 之 DataFrame 和 Dataset
一.Spark SQL简介 Spark SQL 是 Spark 中的一个子模块,主要用于操作结构化数据.它具有以下特点: 能够将 SQL 查询与 Spark 程序无缝混合,允许您使用 SQL 或 Da ...
- Spark 系列(十三)—— Spark Streaming 与流处理
一.流处理 1.1 静态数据处理 在流处理之前,数据通常存储在数据库,文件系统或其他形式的存储系统中.应用程序根据需要查询数据或计算数据.这就是传统的静态数据处理架构.Hadoop 采用 HDFS 进 ...
- Spark入门实战系列--3.Spark编程模型(上)--编程模型及SparkShell实战
[注]该系列文章以及使用到安装包/测试数据 可以在<倾情大奉送--Spark入门实战系列>获取 .Spark编程模型 1.1 术语定义 l应用程序(Application): 基于Spar ...
- Spark系列-核心概念
Spark系列-初体验(数据准备篇) Spark系列-核心概念 一. Spark核心概念 Master,也就是架构图中的Cluster Manager.Spark的Master和Workder节点分别 ...
随机推荐
- 48、Spark SQL之与Spark Core整合之每日top3热点搜索词统计案例实战
一.概述 1.需求分析 数据格式: 日期 用户 搜索词 城市 平台 版本 需求: 1.筛选出符合查询条件(城市.平台.版本)的数据 2.统计出每天搜索uv排名前3的搜索词 3.按照每天的top3搜索词 ...
- git:GitLab代码回滚到特定版本
在当前branch上多次commit代码并且push后,发现不符合要求,需要回滚到特定的版本.步骤如下: 1.查找commitId (1)用命令行打开git项目路径,输入git log命令查看comm ...
- 安利一个github上面的一个神级库thefuck,Linux命令敲错了,没关系,自动纠正你的命令
没错就是这么神奇,名字相当噶性,thefuck.当你命令输入错误不要怕,直接来一句fuck,自动纠正你输入的命令. 在你输入错误的命令的时候,忍俊不禁的想来一句fuck,没错你不仅可以嘴上说,命令里面 ...
- 什么是TCP粘包?怎么解决这个问题
在socket网络编程中,都是端到端通信,由客户端端口+服务端端口+客户端IP+服务端IP+传输协议组成的五元组可以明确的标识一条连接.在TCP的socket编程中,发送端和接收端都有成对的socke ...
- [Beta]第二次 Scrum Meeting
[Beta]第二次 Scrum Meeting 写在前面 会议时间 会议时长 会议地点 2019/5/6 22:00 30min 大运村公寓6F楼道 附Github仓库:WEDO 例会照片 工作情况总 ...
- Oracle存储过程 函数 计算使用资源
目录 存储过程与函数 存储过程的优势 存储过程 打印语句 选择语句 函数 计算使用资源 存储过程与函数 存储过程的优势 存储过程 /* 多行注释 */ -- 单行注释 //展示错误信息 show er ...
- vue+elementui搭建后台管理界面(8 同步/异步获取数据渲染table)
elementui已经封装好了 el-table 组件,只需要指定 data 数据源即可,因此通常在 vue 实例生命周期的 created 阶段,从数据库获取数据,再将返回的数据绑定到 data 如 ...
- Sharding-Jdbc 自定义分库分表-复合分片算法自定义实现
Sharding-JDBC中的分片策略有两个维度,分别是: 数据源分片策略(DatabaseShardingStrategy) 表分片策略(TableShardingStrategy) 其中,数据源分 ...
- nmon报告分析
nmon结果说明及分析 2018年09月29日 16:12:10 Jio_2018 阅读数 2334 使用nmon analyser生成的结果文件包含了N多个sheet页,下面只是结合个人经验对几 ...
- vue mpvue 上拉加载更多示例代码
vue 上拉加载更多示例代码 可以比较简单的改为 mpvue , 去除滚动判断,直接放在 onReachBottom 周期即可. html <div id="app"> ...