
golang版并发爬虫
准备爬取内涵段子的几则笑话,先查看网址:http://www.budejie.com/text/
简单分析后发现每页的url呈加1趋势
第一页: http://www.budejie.com/text/1
第二页:http://www.budejie.com/text/2
...
每页的段子:
<a href="/detail-28278217.html"> 内容</a>
<a href="/detail-28270675.html"> 内容</a>
....
所以正则表达式的解释规则是<a href="/detail-\d{8}.html">(?s:(.*?))</a>,第一个分组的内容就是需要的文字。
代码如下:
package main

import (

    "fmt"

    "regexp"

    "strconv"

    "net/http"

    "log"

    "os"

    "strings"

)

func onespider(n int, ch chan int) {

    url := "http://www.budejie.com/text/" + strconv.Itoa(n)

    resp, err := http.Get(url)

    if err != nil {

        log.Fatal("get error")

    }

    defer resp.Body.Close()

    reg, err1 := regexp.Compile(`<a href="/detail-\d{8}.html">(?s:(.*?))</a>`)

    if err1 != nil {

        log.Fatal("compile error")

    }

    var respstring string

    buf := make([]byte, )

    for {

        n, _ := resp.Body.Read(buf)

        if n ==  {

            break

        }

        respstring += string(buf[:n])

    }

    cont := reg.FindAllStringSubmatch(respstring, -)

    file, _ := os.OpenFile("./爬虫/"+"第"+strconv.Itoa(n)+"页爬虫.txt", os.O_RDWR|os.O_TRUNC|os.O_CREATE, )

    defer file.CLose()

    var i int

    for _, value := range cont {

        if len(value[]) <  {

            continue

        }

        value[] = strings.Replace(value[], "<br />", "\n", -)

        index := strconv.Itoa(i+)

        file.Write([]byte("第"+index+"则段:\n"+value[]+"\n\n\n"))

        i++

    }

    ch <- n

}

func Spider(s, e int) {

    ch := make(chan int)

    for i := s; i <= e; i++ {

        go onespider(i, ch)

    }

    for i := s; i <= e; i++ {

        n := <- ch

        fmt.Printf("第%d页爬取完毕\n", n)

    }

}

func main(){

    var start, end int

    fmt.Println("输入起始页")

    fmt.Scan(&start)

    fmt.Println("输入终止页")

    fmt.Scan(&end)

    Spider(start, end)

}
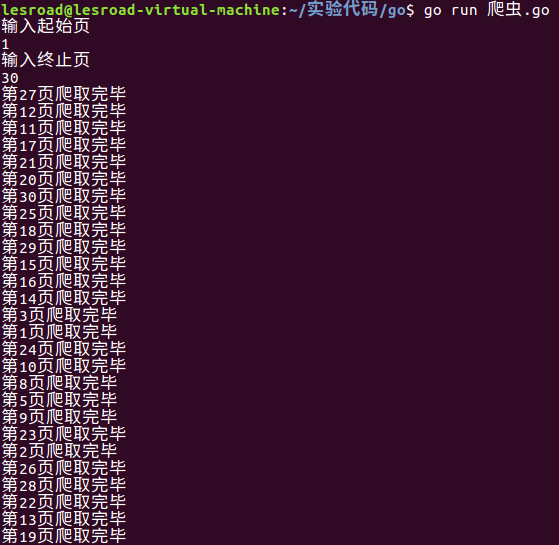
运行截图:
效果截图:
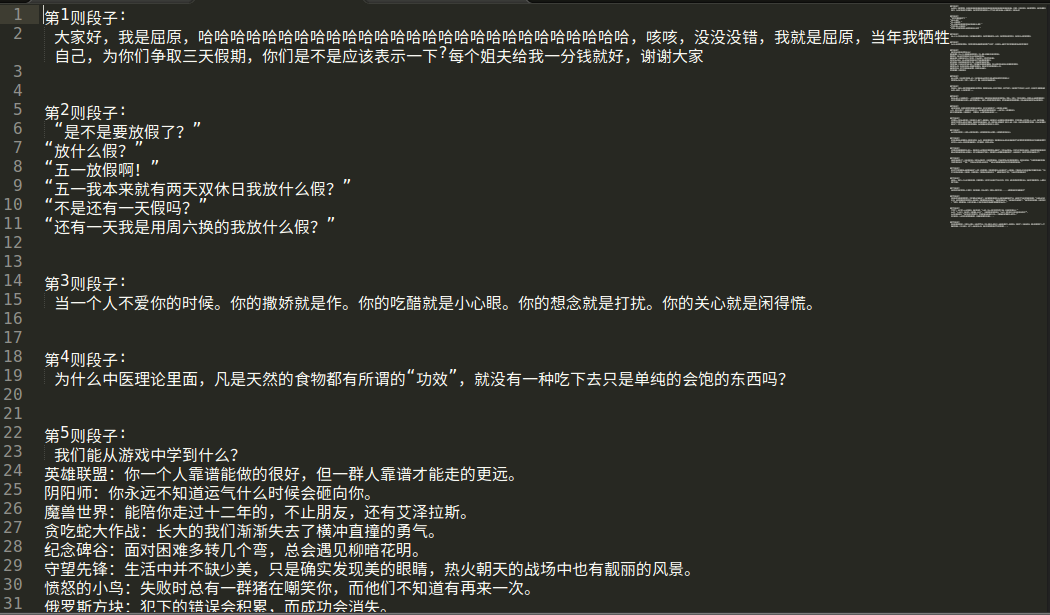
最后我发现第2页之后的段子都是重复的。。。
golang版并发爬虫的更多相关文章
- golang实现并发爬虫三(用队列调度器实现)
欲看此文,必先可先看: golang实现并发爬虫一(单任务版本爬虫功能) gollang实现并发爬虫二(简单调度器) 上文中的用简单的调度器实现了并发爬虫. 并且,也提到了这种并发爬虫的实现可以提高爬 ...
- golang实现并发爬虫一(单任务版本爬虫功能)
目的是写一个golang并发爬虫版本的演化过程. 那么在演化之前,当然是先跑通一下单任务版本的架构. 正如人走路之前是一定要学会爬走一般. 首先看一下单任务版本的爬虫架构,如下: 这是单任务版本爬虫的 ...
- golang实现并发爬虫二(简单调度器)
上篇文章当中实现了单任务版爬虫. 那么这篇文章就大概说下,如何在上一个版本中进行升级改造,使之成为一个多任务版本的爬虫.加快我们爬取的速度. 话不多说,先看图: 其实呢,实现方法就是加了一个sched ...
- golang的并发
Golang的并发涉及二个概念: goroutine channel goroutine由关键字go创建. channel由关键字chan定义 channel的理解稍难点, 最简单地, 你把它当成Un ...
- Golang版protobuf编译
官方网址: https://developers.google.com/protocol-buffers/ (需要FQ) 代码仓库: https://github.com/google/protobu ...
- golang的并发不等于并行
先 看下面一道面试题: func main() { runtime.GOMAXPROCS(1) wg := sync.WaitGroup{} wg.Add(20) for i := 0; i < ...
- [Golang] kafka集群搭建和golang版生产者和消费者
一.kafka集群搭建 至于kafka是什么我都不多做介绍了,网上写的已经非常详尽了. 1. 下载zookeeper https://zookeeper.apache.org/releases.ht ...
- Go语言之进阶篇简单版并发服务器
1.简单版并发服务器 示例1: package main import ( "fmt" "net" "strings" ) //处理用户请求 ...
- swing版网络爬虫-丑牛迷你采集器2.0
swing版网络爬虫-丑牛迷你采集器2.0 http://www.javacoo.com/code/704.jhtml 整合JEECMS http://bbs.jeecms.com/fabu/3186 ...
随机推荐
- 64. Minimum Path Sum(最小走棋盘 动态规划)
Given a m x n grid filled with non-negative numbers, find a path from top left to bottom right which ...
- Spring MVC 复习笔记01
1. springmvc框架 1.1 什么是springmvc spring mvc是spring框架的一个模块,springmvc和spring无需通过中间整合层进行整合.spring mvc是一个 ...
- python3_UUID模块详解
1.知识背景 UUID是128位的全局唯一标识符,通常有32字节的字母表示.它可以保证时间和空间的唯一性. UUID——Universally unique identifier 在python中叫U ...
- Swap交换分区--continue
Linux内核为了提高读写效率与速度,会将文件在内存中进行缓存,这部分内存就是Cache Memory(缓存内存).即使你的程序运行结束后,Cache Memory也不会自动释放.这就会导致你在Lin ...
- The type javax.http.HttpServletRequest cannot be resolved.It is indirectly 解决办法
原因:项目中缺少servlet-api.jar文件. 解决办法:将E:\tomcat\apache-tomcat-6.0.24\lib下的servlet-api.jar拷贝到项目中,然后编译即可.(根 ...
- WebSocket安卓客户端实现详解(一)–连接建立与重连
http://blog.csdn.net/zly921112/article/details/72973054 前言 这里特别说明下因为WebSocket服务端是公司线上项目所以这里url和具体协议我 ...
- jQuery与直接写JS的区别详细解析
jQuery代码具体的写法和原生的Javascript写法在执行常见操作时的区别如下所示.需要的朋友可以过来参考下 要使用jQuery,首先要在HTML代码最前面加上对jQuery库的引用,比 ...
- Web服务器对比介绍
1.Apache Apache是非常强大的老牌Web服务器,具有模块化结构,拥有众多非常成熟稳定的模块,目前仍是使用非常广泛的服务器,但它是基于多进程HTTPServer,需要对每个用户请求创建一个子 ...
- svn checkout 提示“由于连接方在一段时间后没有正确答复或连接的主机没有反应,连接尝试失败。”解决方法
安装好之后再windows上checkout项目,一直出错:“由于连接方在一段时间后没有正确答复或连接的主机没有反应,连接尝试失败”:在尝试了很多次之后找到了最后的问题所在. 在网上找的方法试过了, ...
- uboot下ext4load的用法
将sd卡的某个分区下的某个目录里的某个文件加载到内存的某个地址,示例如下: ext4load mmc 0:1 0xa0000000 /bin/vi