
MRS +Apache Zeppelin,让数据分析更便捷
摘要:选择轻量化、免运维、低成本的大数据云服务是业界趋势,如果搭建Zeppelin再同步自建一套Hadoop生态成本太高!因此我们通过结合华为云MRS服务构建数据中台。
本文分享自华为云社区《MRS大数据平台结合Apache Zeppelin让数据分析更便捷》,作者: dullman。
Apache Zeppelin:一款大数据分析和可视化工具,可以让数据分析师在一个基于Web的notebook中,采用不同语言对不同数据源中的数据进行交互式分析,并对结果进行可视化图表的展示。
云服务MRS:华为云提供的一站式大数据平台,包含Hudi、ClickHouse、Spark、Flink、Kafka、Hive、HBase等丰富的大数据组件,完全兼容开源生态。 本文介绍如何搭建Zeppelin并连接Hive、HBase进行简单的数据开发。
为什么写这篇文章?
- Zeppelin相关的文章虽然很多,但是都没有与实际大数据平台结合的实践案例指导。
- Zeppelin的搭建存在不少坑,因此记录下部署中的各个问题,为后人填坑。
- 选择轻量化、免运维、低成本的大数据云服务是业界趋势,如果搭建Zeppelin再同步自建一套Hadoop生态成本太高!因此我们通过结合华为云MRS服务构建数据中台。
环境准备
- Apache Zeppelin 0.9.0安装包
- MRS 3.1.0普通集群 (包含Hive、HBase组件)
- ECS centos7.6
安装MRS客户端
MRS客户端提供java、python开发环境,也提供开通集群中各组件的环境变量:Hadoop、Hive、HBase、flink等。
参见登录ECS安装集群外客户端
安装Zeppelin
- 使用Xftp等工具导入主机并采用以下命令安装在/opt/zeppelin目录。
tar -zxvf zeppelin-0.9.0-bin-all.tgz

mv zeppelin-0.9.0-bin-all /opt/zeppelin
- 配置Zeppelin环境变量,在profile文件中加入变量
vi /etc/profile
export ZEPPELIN_HOME=/opt/zeppelin
export PATH=ZEPPELIN_HOME/bin:ZEPPELINHOME/bin:PATH
- 导入环境变量
source /etc/profile
- 编辑zeppelin-env.sh文件,加入JAVA_HOME,这里需要替换成自己的环境变量
cd /opt/zeppelin/conf/

cp zeppelin-env.sh.template zeppelin-env.sh

source /opt/hadoopclient/bigdata_env

echo “export JAVA_HOME=/opt/hadoopclient/JDK/jdk-8u201”>>zeppelin-env.sh
- 编辑zeppelin-site.xml文件,将zeppelin.server.port 8080替换成18081(可自定义,也可以不改);将zeppelin.anonymous.allowed参数的true修改为false
cd /opt/zeppelin/conf

cp zeppelin-site.xml.template zeppelin-site.xml

vi zeppelin-site.xml
<property>

    <name>zeppelin.server.port</name>

    <value>18081</value>

    <description>Server port.</description>

</property>

<property>

    <name>zeppelin.anonymous.allowed</name>

    <value>falase</value>

    <description>Anonymous user allowed by default</description>

</property>
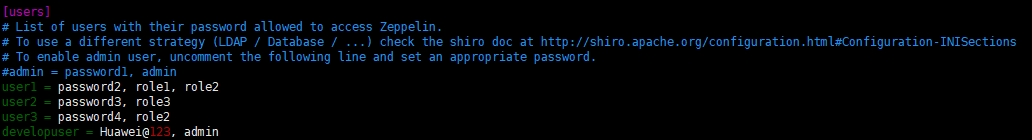
- 编辑shiro.ini文件,新增用户developuser
cp shiro.ini.template shiro.ini

vi shiro.ini
在[users]下新增用户developuser,密码Huawei@123,权限admin
developuser=Huawei@123, admin
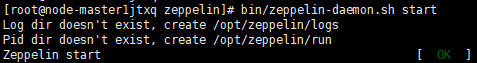
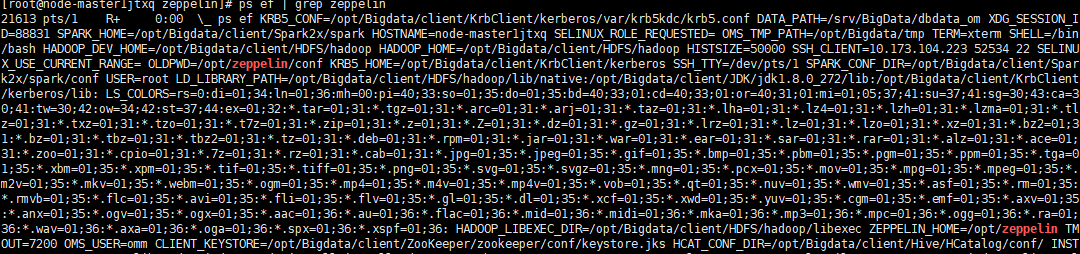
- 运行Zeppelin(并检查启动参数)
cd /opt/zeppelin

bin/zeppelin-daemon.sh start
ps ef | grep zeppelin
- 关闭防火墙,允许端口18081(此为测试环境,生产环境建议采取更安全措施) systtemctl stop firewalld
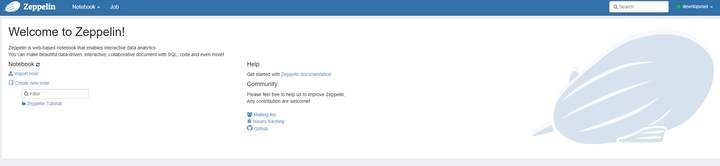
- 完成以上配置,并启动成功后,在浏览器中输入地址zeppelin_ip:18081(zeppelin_ip为安装zeppelin的HD客户端IP),即可看到如下界面。
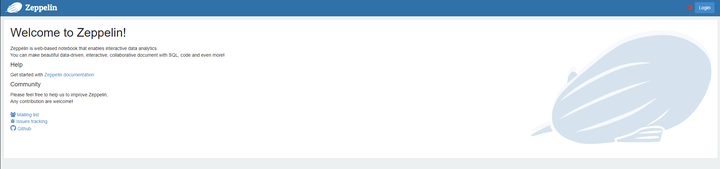
- 使用developuser登录,就可以基于note进行大数据的交互式开发了!
Zeppelin连接Hive
1、将Zeppelin中jdbc依赖的jar包替换成MRS客户端中Hive/Beeline/lib中的jar包,保证hive Interpreter依赖的Jar包存在
cp -f /opt/Bigdata/client/Hive/Beeline/lib/*.jar /opt/zeppelin/interpreter/jdbc/
2、修改Zeppelin配置,添加Client Hive Url
查询CLIENT_HIVE_URL
source /opt/hadoopclient/bigdata_env

echo $CLIENT_HIVE_URI
编辑interpreter.json,位置/usr/zeppelin/conf/interpreter.json,修改JDBC default.url,default.driver.
"jdbc": {

   "id": "jdbc",

   "name": "jdbc",

   "group": "jdbc",

   "properties": {

     "default.url": {

       "name": "default.url",

       "value": "jdbc:hive2://192.168.1.188:24002,192.168.1.234:24002,192.168.1.241:24002/;serviceDiscoveryMode\u003dzooKeeper;zooKeeperNamespace\u003dhiveserver2",

       "type": "string",

       "description": "The URL for JDBC."

     },

     "default.user": {

       "name": "default.user",

       "value": "gpadmin",

       "type": "string",

       "description": "The JDBC user name"

     },

     "default.password": {

       "name": "default.password",

       "value": "",

       "type": "password",

       "description": "The JDBC user password"

     },

     "default.driver": {

       "name": "default.driver",

       "value": "org.apache.hive.jdbc.HiveDriver",

       "type": "string",

       "description": "JDBC Driver Name"

     }
3、重启zeppelin
bin/zeppelin-daemon.sh restart
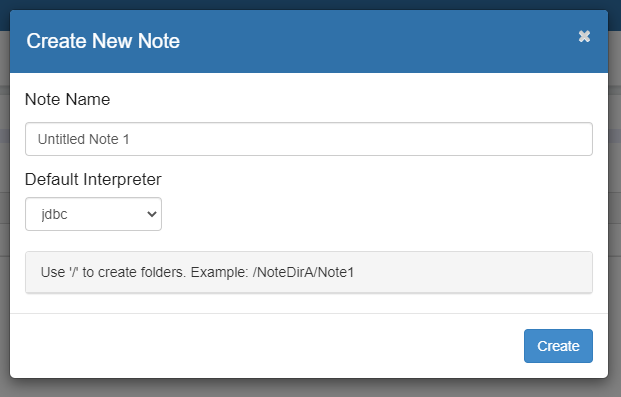
4、创建Notebook,选择default interpreter 为jdbc
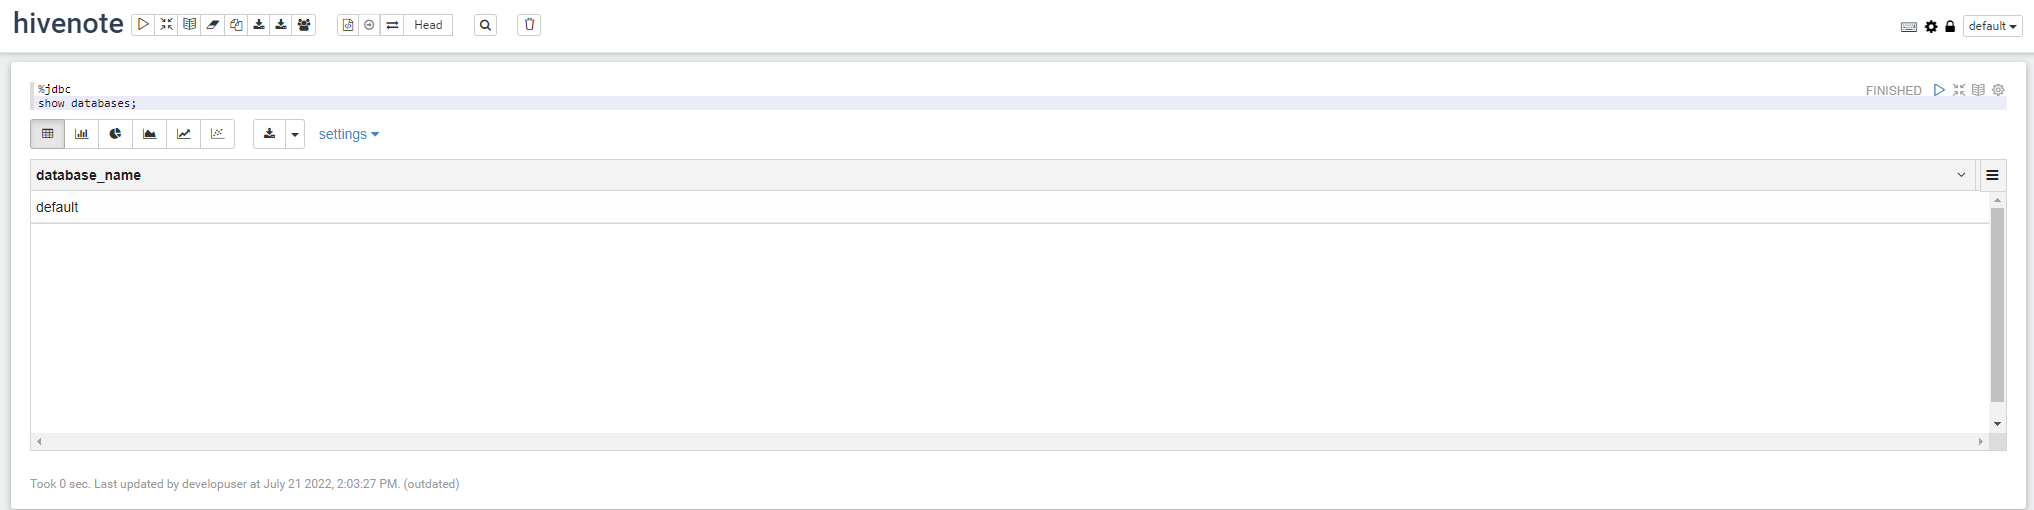
5、在notebook上使用Hive SQL进行查询
查询数据库

%jdbc

show databases;
创建Hive表

%jdbc

create external table stu (s_id string,s_name string) row format delimited fields terminated by ‘\t’;

Zeppelin连接HBase
1、将Zeppelin中hbase依赖的jar包替换成MRS客户端中HBase中的jar包,保持jar的一致
- 先将/opt/zeppelin/interpreter/hbase/目录下原本的Jar包移走
cd /opt/zeppelin/interpreter/hbase

mkdir hbase_old_jar

mv hbase*.jar hbase_old_jar

mv hadoop*.jar hbase_old_jar

mv zookeeper-3.4.6.jar hbase_old_jar
- 再将/opt/hadoopclient/HBase/hbase/lib/下的jar包拷贝至/opt/zeppelin/interpreter/hbase/。
cp -f /opt/hadoopclient/HBase/hbase/lib/*.jar /usr/zeppelin/interpreter/hbase/
2、修改Zeppelin配置
编辑zeppelin-env.sh,加入hbase环境变量
export HBASE_HOME=/opt/hadoopclient/HBase/hbase
编辑interpreter.json,位置/opt/zeppelin/conf/interpreter.json,修改hbase.home
  "hbase.home": {

        "name": "hbase.home",

        "value": "/opt/hadoopclient/HBase/hbase",

        "type": "string"

      }
3、重启zeppelin
bin/zeppelin-daemon.sh restart
4、配置Interpreter
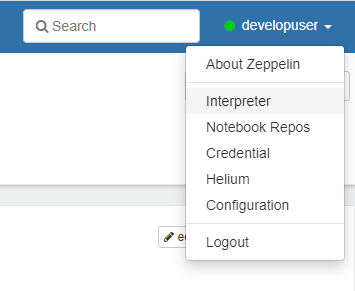
从web界面右上角菜单中Interpreter中进入,配置Interpreter
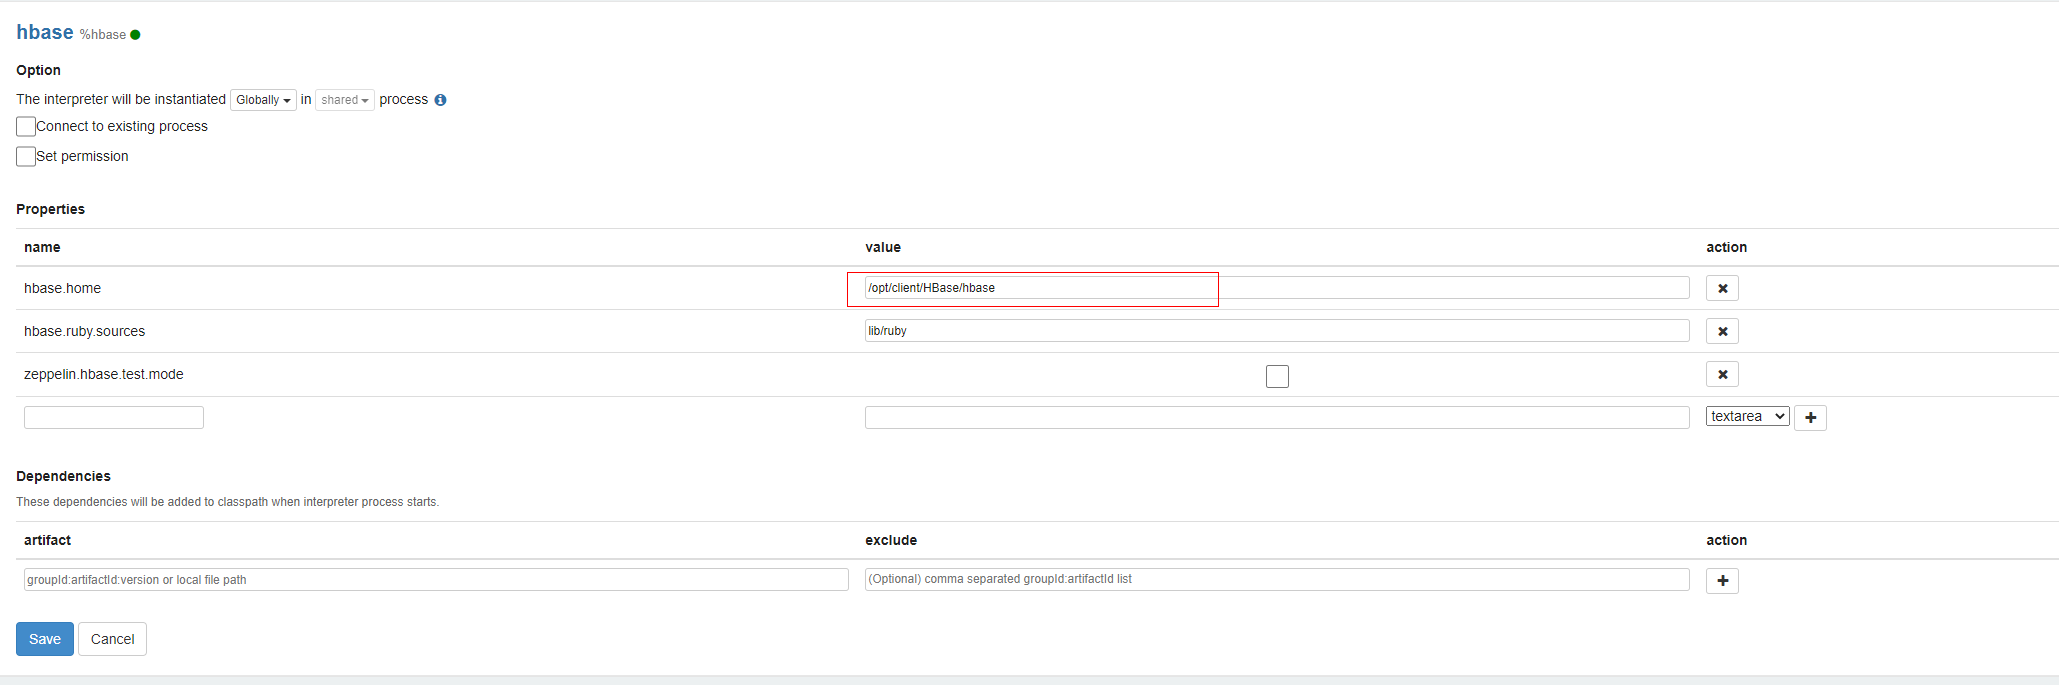
选择Hbase,修改如下配置,并保存配置。
hbase.home : /opt/client/HBase/hbase
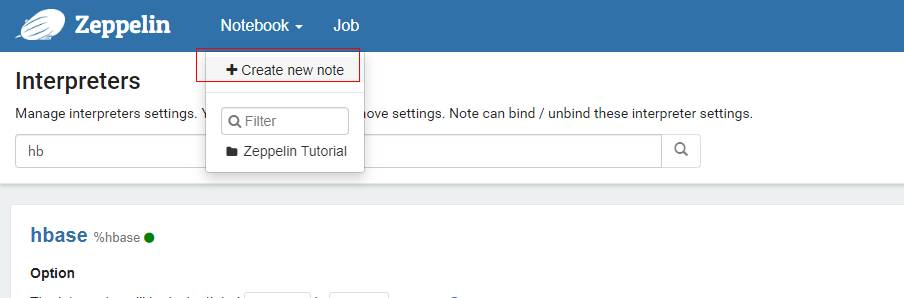
5、创建note进行数据开发
页面选择Notebook →create new note
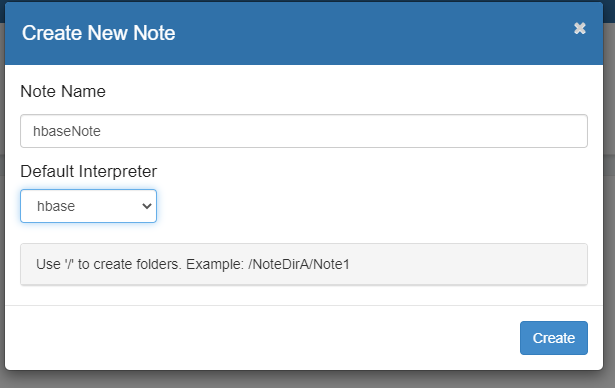
自定义Note名称,例如hbaseNote,并指定Interpreter为HBase。
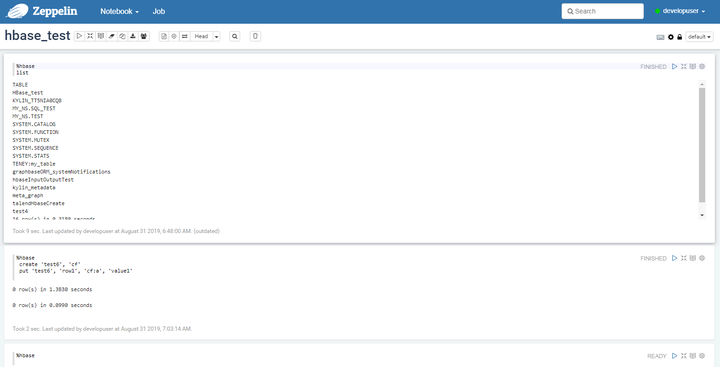
编辑Note,点击右侧“执行”按钮(三角标志)
%hbase

create ‘test6’, ‘cf’

put ‘test6’, ‘row1’, ‘cf:a’, ‘value1’
若在创建Interpreter未指定default Interpreter,需要在note最前面加上%hbase进行指定。
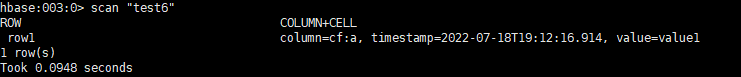
6、在FusionInsight客户端下查看刚刚通过Zeppelin创建的hbase表test6和数据
其他Hadoop生态组件在云服务MRS上的实践参考
基于云服务MRS构建DolphinScheduler2调度系统
MRS +Apache Zeppelin,让数据分析更便捷的更多相关文章
- Apache Hudi集成Apache Zeppelin实战
1. 简介 Apache Zeppelin 是一个提供交互数据分析且基于Web的笔记本.方便你做出可数据驱动的.可交互且可协作的精美文档,并且支持多种语言,包括 Scala(使用 Apache Spa ...
- Apache Zeppelin
介绍 用于做数据分析和可视化 一.二进制安装 1)下载二进制包 wget http://mirrors.tuna.tsinghua.edu.cn/apache/incubator/zeppelin/0 ...
- Apache Zeppelin是什么?
Apache Zeppelin提供了web版的类似ipython的notebook,用于做数据分析和可视化.背后可以接入不同的数据处理引擎,包括spark, hive, tajo等,原生支持scala ...
- 微信公众平台自定义菜单新增扫一扫、发图片、发位置 LBS运作更便捷
今天微信公众平台发布更新,自定义菜单新增扫一扫.发图片.发送位置等功能,这对于有意挖掘微信LBS服务的运营者来说更便捷了,订阅号不用返回微信界面就能扫图.发送图片.调用地理位置,用户体验更友好,自然也 ...
- 更便捷的css处理方式-postcss
更便捷的css处理方式-PostCSS 一般来说介绍一个东西都是要从是什么,怎么用的顺序来讲.我感觉这样很容易让大家失去兴趣,先看一下postcss能做点什么,有兴趣的话再往下看,否则可能没有耐心看下 ...
- Android源码浅析(三)——Android AOSP 5.1.1源码的同步sync和编译make,搭建Samba服务器进行更便捷的烧录刷机
Android源码浅析(三)--Android AOSP 5.1.1源码的同步sync和编译make,搭建Samba服务器进行更便捷的烧录刷机 最近比较忙,而且又要维护自己的博客,视频和公众号,也就没 ...
- 使用Zeppelin时出现at org.apache.zeppelin.interpreter.thrift.RemoteInterpreterService$Client.recv_getFormType(RemoteInterpreterService.java:288)错误的解决办法(图文详解)
不多说,直接上干货! 问题详解 org.apache.thrift.TApplicationException: Internal error processing getFormType at or ...
- 更便捷的Mybatis增强插件——EasyMybatis
easy-mybatis是一个对Mybatis的增强框架(插件).在Spring集成Mybatis的基础上,将项目开发中对数据库的常用操作统一化.使用本框架可以很便捷的对数据库进行操作,提高开发效率, ...
- HarmonyOS新能力让数据多端协同更便捷,数据跨端迁移更高效!
作者:yijian,终端OS分布式文件系统专家:gongashi,终端OS分布式数据管理专家 HarmonyOS作为分布式操作系统,其分布式数据管理能力非常重要.我们也一直围绕持续为开发者带来全局&q ...
- Exception in thread "main" java.lang.UnsupportedClassVersionError: org/apache/zeppelin/server/ZeppelinServer : Unsupported major.minor version 52.0
在启动Zeppelin时遇到了该问题: [root@quickstart bin]# ./zeppelin-daemon.sh restart Please specify HADOOP_CONF_D ...
随机推荐
- selenium 知网爬虫之根据【关键词】获取文献信息
哈喽大家好,我是咸鱼 之前咸鱼写过几篇关于知网爬虫的文章,后台反响都很不错.虽然但是,咸鱼还是忍不住想诉苦一下 有些小伙伴文章甚至代码看都没看完,就问我 "为什么只能爬这么多条文献信息?&q ...
- Markdown & typora 速查
Markdown & typora 速查 一级标题 # 一级标题 说明:#数量表示几级标题,如二级标题为"## 二级标题",支持到6级标题,#和标题中间有一个空格 typo ...
- Vue05-Vuex
01. 什么是状态管理 在开发中,我们的应用程序需要处理各种各样的数据,这些数据需要保存在我们应用程序的某一个位置,对于这些数据的管理我们就称之为 状态管理. 在Vue开发中,我们使用组件化的开发方式 ...
- vue禁止浏览器F5进行刷新和监听浏览器刷新事件
项目中有个这样的需求: 进入视频播放页后,添加一个标识,为了防止用户一次播放多个视频,当离开该页面后,如果是从当前正在播放的视频页面离开的,则离开播放页时清除标识,如果是不是则不清除,并且禁止用户按F ...
- 报错Error running 'Tomcat 9.0.68': Can't find catalina.jar【解决办法】
修改tomcat路径,肯定是你移动了jar包在硬盘的位置 将路径改成当前所在的文件位置
- 一文带你掌握C语言的循环结构
C语言循环结构详解 在C语言中,循环结构是一种重要的控制结构,它允许我们重复执行一段代码,以达到特定的目的.循环结构可以帮助我们简化重复性的任务,提高代码的效率.本篇文章将深入探讨C语言中的循环结构, ...
- [清华集训2017] Hello World!
Hello world! 题目背景 不远的一年前,小 V 还是一名清华集训的选手,坐在机房里为他已如风中残烛的OI 生涯做最后的挣扎.而如今,他已成为了一名光荣的出题人.他感到非常激动,不禁感叹道: ...
- GIS系统想要实现Cesium For Unreal的视觉效果是否有捷径可走?
对于大多数GIS开发人员来说,CesiumJS都是比较熟悉的引擎,但是相比较Cesium For Unreal而言,CesiumJS的视觉效果就显得差强人意了,因此一些GIS开发人员对Cesium F ...
- C#设计模式之享元模式(Flyweight)
using System; using System.Collections; public class Client { public static void Main(string[] args) ...
- 解决 IDEA 报错ERROR:JAVA: 无效的源发行版: 11
解决 IDEA 报错ERROR:JAVA: 无效的源发行版: 11 原因 一般都是创建工程的时候 一路next 默认选择了 Java Version 11, 而本地的jdk版本是 8 解决 File ...