
第7章 PCA与梯度上升法


主成分分析法:主要作用是降维

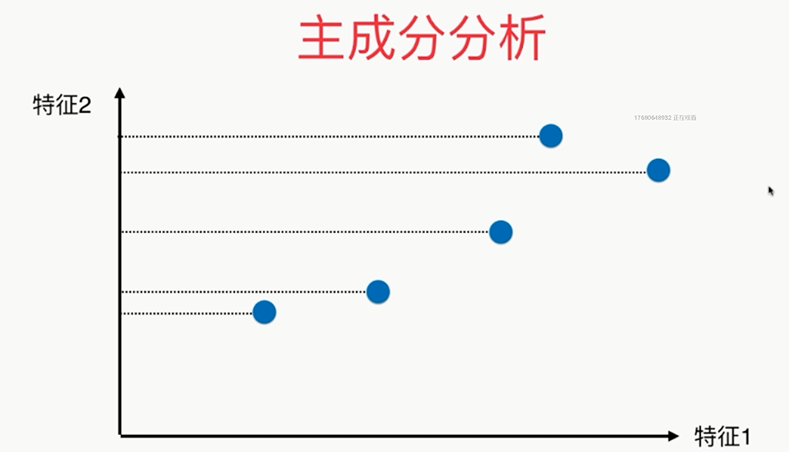

疑似右侧比较好?
第三种降维方式:
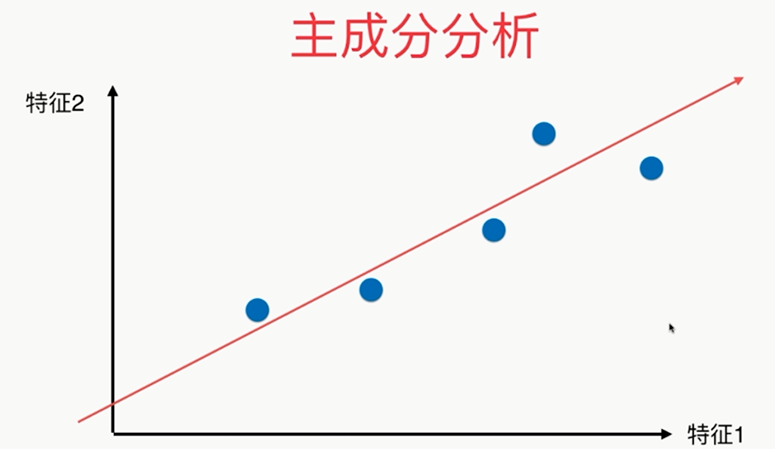
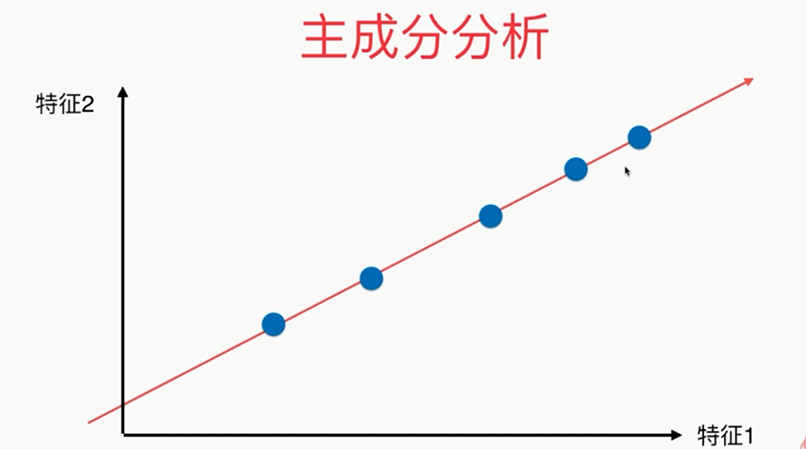
问题:?????
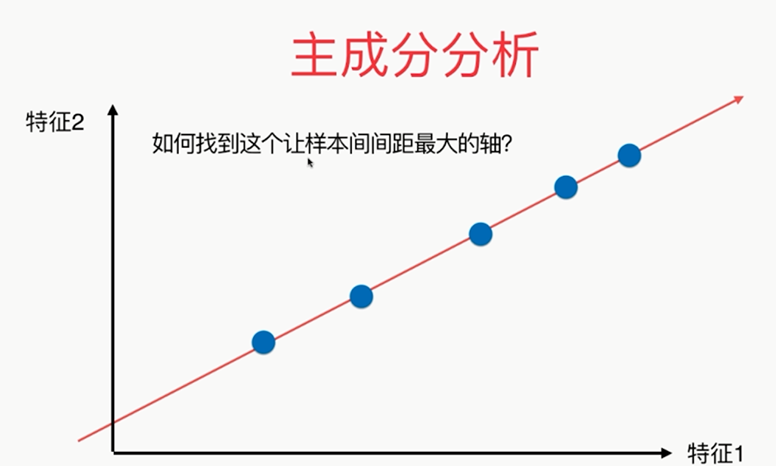

方差:描述样本整体分布的疏密的指标,方差越大,样本之间越稀疏;越小,越密集

第一步:
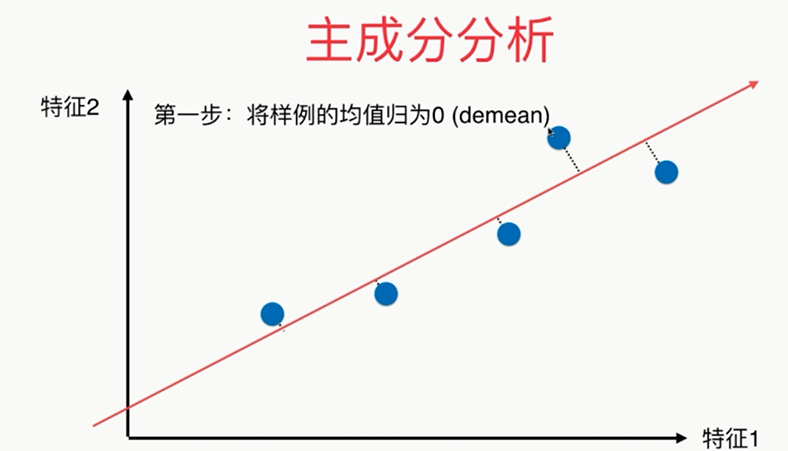
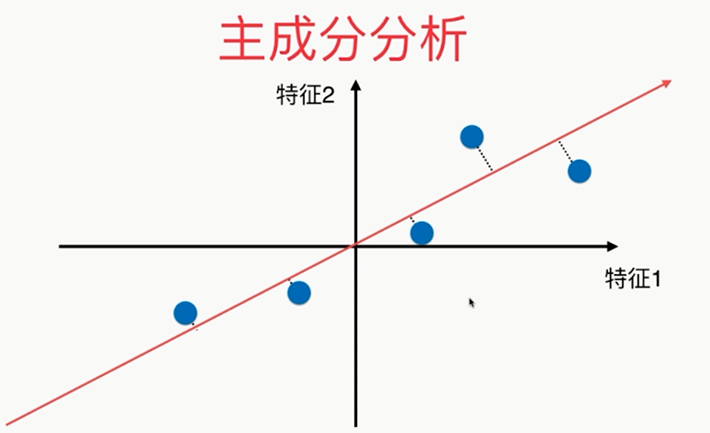
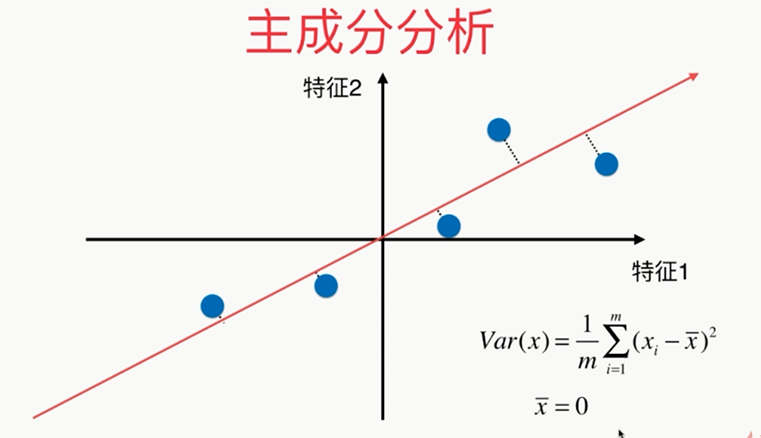

总结:
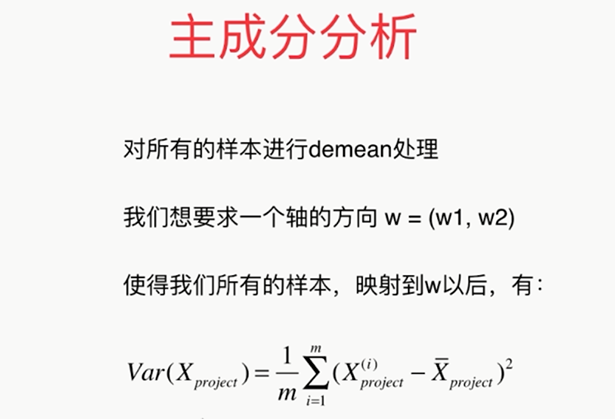

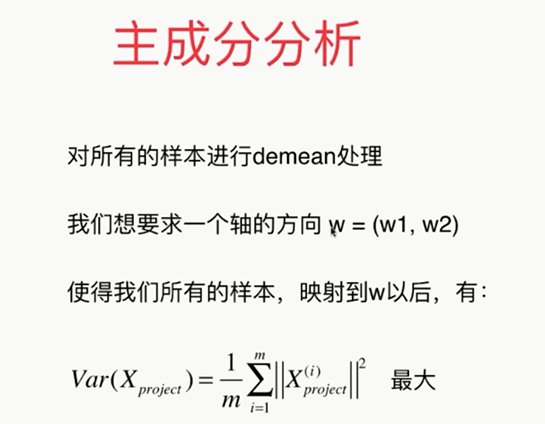
问题:????怎样使其最大
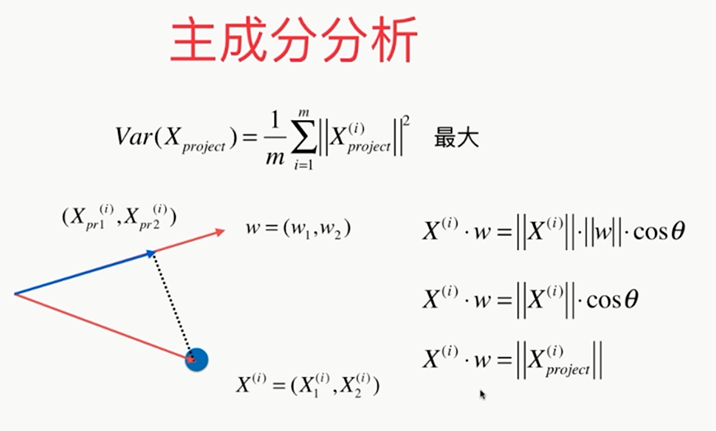
变换后:
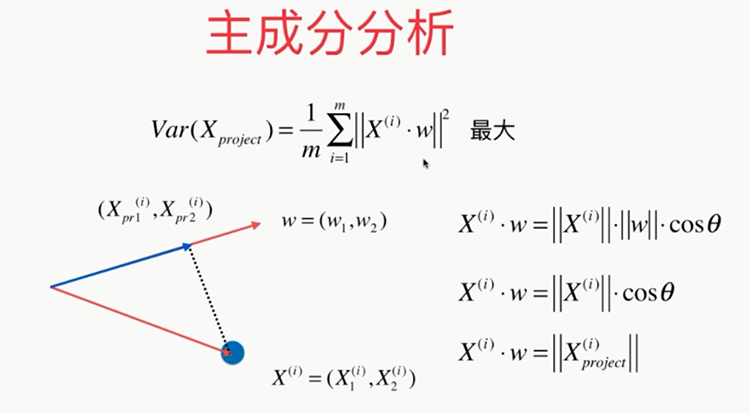


最后的问题:????
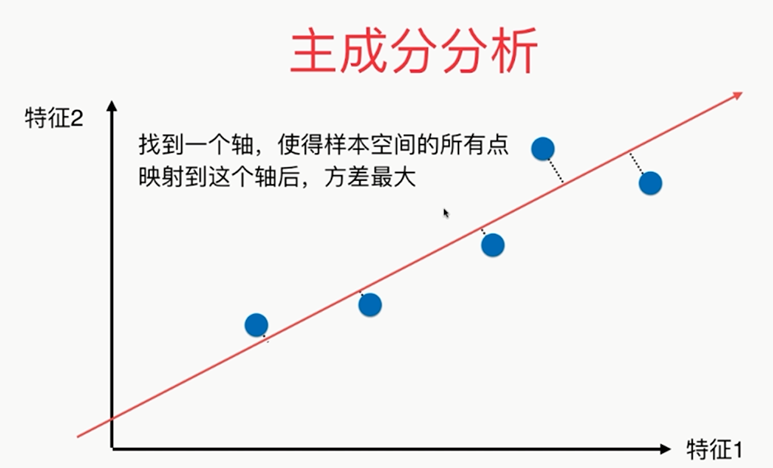
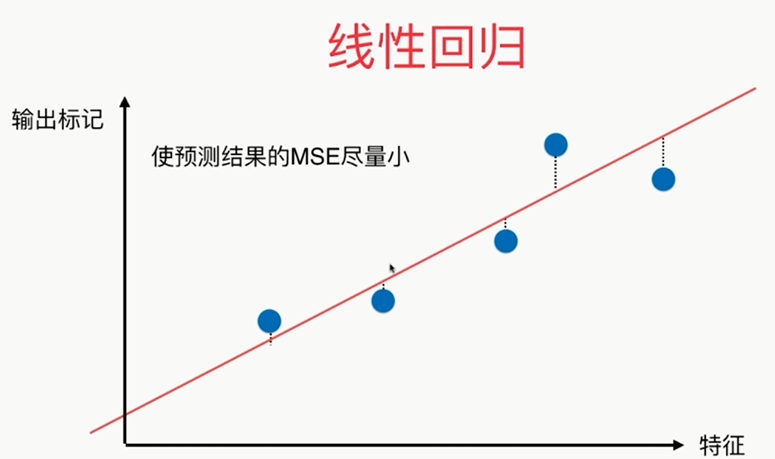
注意区别于线性回归
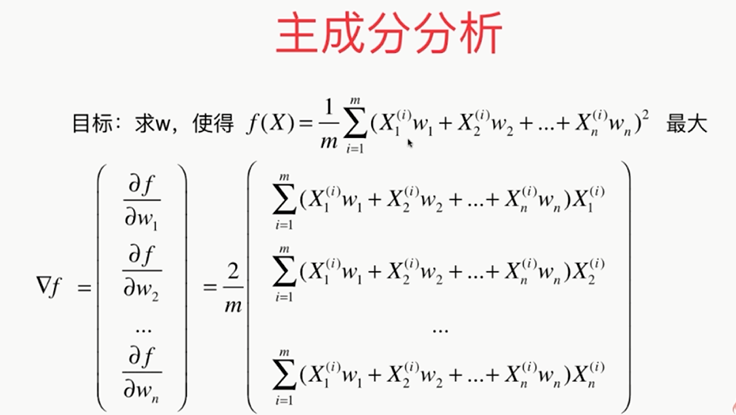
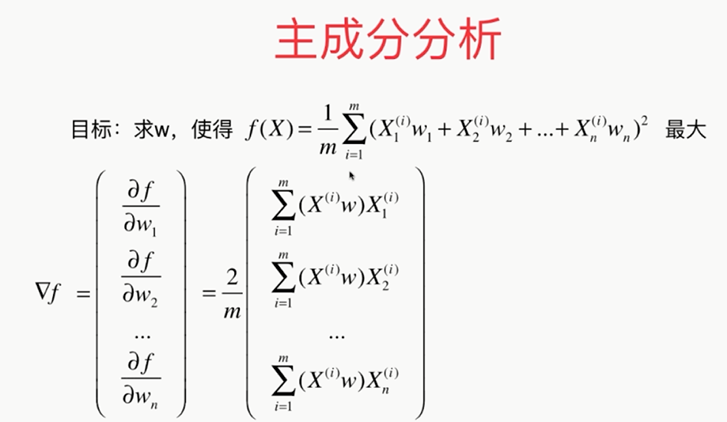
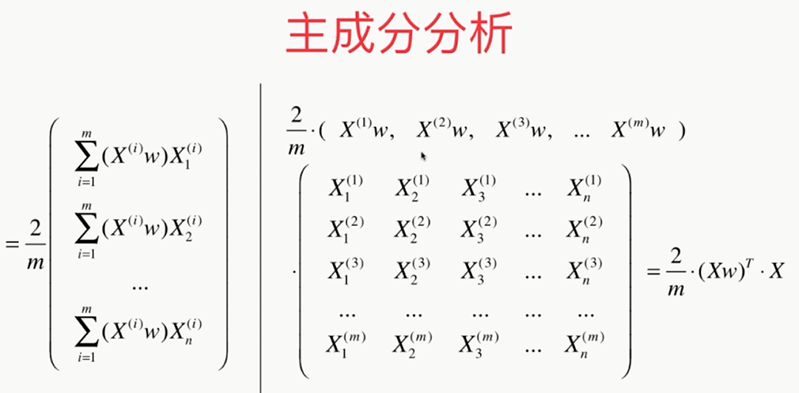
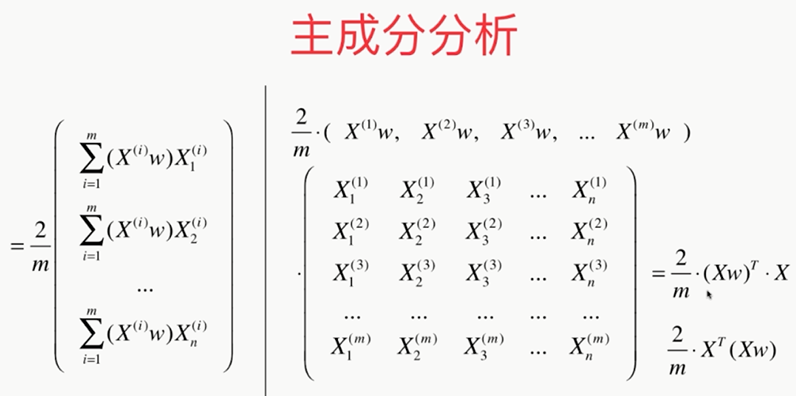
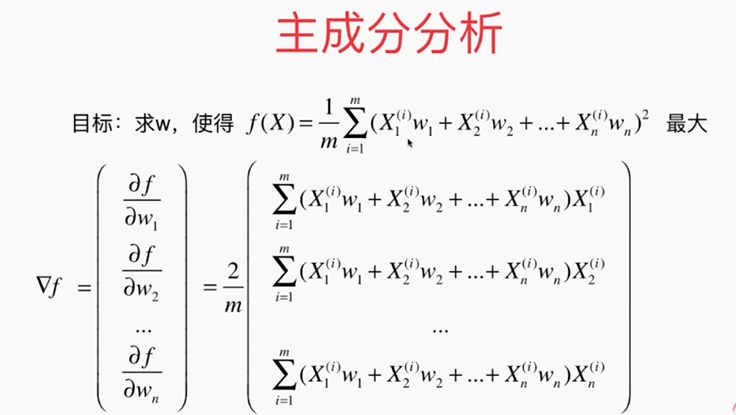
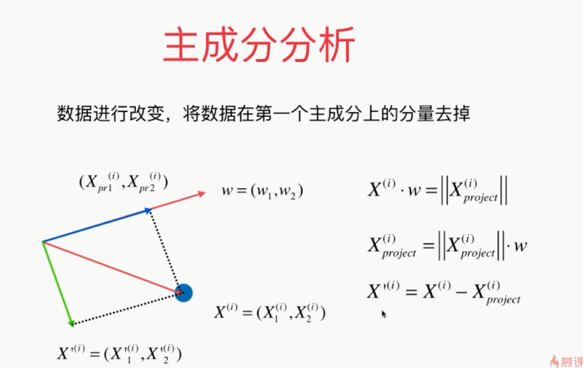
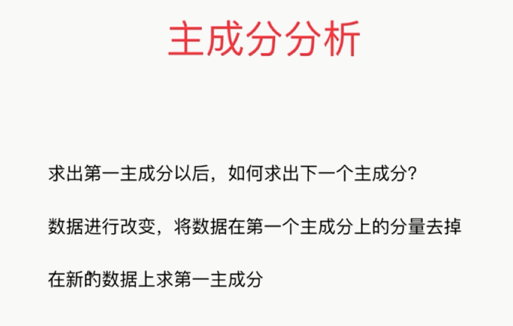
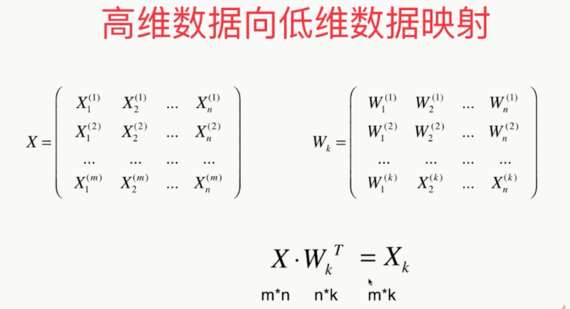
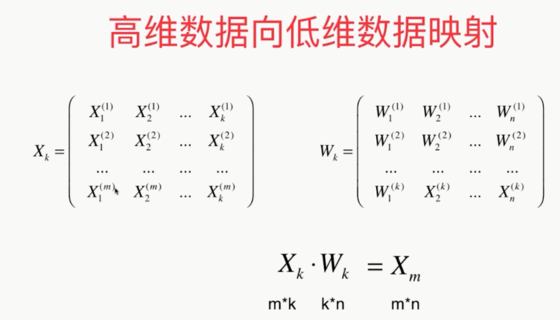
使用梯度上升法解决PCA问题:

import numpy as np

import matplotlib.pyplot as plt

from sklearn import datasets

digits = datasets.load_digits()  # 手写识别数据

X = digits.data

y = digits.target

from sklearn.model_selection import train_test_split

X_train, X_test, y_train, y_test = train_test_split(X, y, random_state=666)

# 使用K近邻

from sklearn.neighbors import KNeighborsClassifier

knn_clf=KNeighborsClassifier()

knn_clf.fit(X_train,y_train)

a1=knn_clf.score(X_test,y_test)

# print(a1)

# 使用PCA

from sklearn.decomposition import PCA

pca=PCA(n_components=2)

pca.fit(X_train)

X_train_reduction=pca.transform(X_train)

X_test_reduction=pca.transform(X_test)

knn_clf=KNeighborsClassifier()

knn_clf.fit(X_train_reduction,y_train)

a2=knn_clf.score(X_test_reduction,y_test)

# print(a2)

# print(pca.explained_variance_ratio_)

pca=PCA(n_components=X_train.shape[1])

pca.fit(X_train)

# print(pca.explained_variance_ratio_)

plt.plot([i for i in range(X_train.shape[1])],

        [np.sum(pca.explained_variance_ratio_[:i+1]) for i in range(X_train.shape[1])])

# plt.show()

pca1=PCA(0.95) # 能解释95%以上的方差

pca1.fit(X_train)

print(pca.n_components_)

from sklearn.decomposition import PCA

pca=PCA(0.95)

pca.fit(X_train)

X_train_reduction=pca.transform(X_train)

X_test_reduction=pca.transform(X_test)

knn_clf=KNeighborsClassifier()

knn_clf.fit(X_train_reduction,y_train)

a3=knn_clf.score(X_test_reduction,y_test)

print(a3)

pca=PCA(n_components=2)

pca.fit(X)

X_reduction=pca.transform(X)

for i in range(10):

    plt.scatter(X_reduction[y==i,0],X_reduction[y==i,1],alpha=0.8)

plt.show()
scikit-learn中的PCA
第7章 PCA与梯度上升法的更多相关文章
- 机器学习(七) PCA与梯度上升法 (上)
一.什么是PCA 主成分分析 Principal Component Analysis 一个非监督学的学习算法 主要用于数据的降维 通过降维,可以发现更便于人类理解的特征 其他应用:可视化:去噪 第一 ...
- 机器学习(4)——PCA与梯度上升法
主成分分析(Principal Component Analysis) 一个非监督的机器学习算法 主要用于数据的降维 通过降维,可以发现更便于人类理解的特征 其他应用:可视化.去噪 通过映射,我们可以 ...
- 4.pca与梯度上升法
(一)什么是pca pca,也就是主成分分析法(principal component analysis),主要是用来对数据集进行降维处理.举个最简单的例子,我要根据姓名.年龄.头发的长度.身高.体重 ...
- 机器学习(七) PCA与梯度上升法 (下)
五.高维数据映射为低维数据 换一个坐标轴.在新的坐标轴里面表示原来高维的数据. 低维 反向 映射为高维数据 PCA.py import numpy as np class PCA: def __ini ...
- 机器学习:PCA(使用梯度上升法求解数据主成分 Ⅰ )
一.目标函数的梯度求解公式 PCA 降维的具体实现,转变为: 方案:梯度上升法优化效用函数,找到其最大值时对应的主成分 w : 效用函数中,向量 w 是变量: 在最终要求取降维后的数据集时,w 是参数 ...
- 《机器学习实战》学习笔记——第13章 PCA
1. 降维技术 1.1 降维的必要性 1. 多重共线性--预测变量之间相互关联.多重共线性会导致解空间的不稳定,从而可能导致结果的不连贯.2. 高维空间本身具有稀疏性.一维正态分布有68%的值落于正负 ...
- 第四章 PCA降维
目录 1. PCA降维 PCA:主成分分析(Principe conponents Analysis) 2. 维度的概念 一般认为时间的一维,而空间的维度,众说纷纭.霍金认为空间是10维的. 3. 为 ...
- Python3入门机器学习经典算法与应用
<Python3入门机器学习经典算法与应用> 章节第1章 欢迎来到 Python3 玩转机器学习1-1 什么是机器学习1-2 课程涵盖的内容和理念1-3 课程所使用的主要技术栈第2章 机器 ...
- Python3入门机器学习经典算法与应用☝☝☝
Python3入门机器学习经典算法与应用 (一个人学习或许会很枯燥,但是寻找更多志同道合的朋友一起,学习将会变得更加有意义✌✌) 使用新版python3语言和流行的scikit-learn框架,算法与 ...
随机推荐
- 10倍处理能力 阿里云推云上首个支持12层4K非编NAS产品
5月23日,阿里云在2017云栖大会·成都峰会上正式推出了云上首个支持广电级非编的文件存储产品------NAS Plus,作为阿里云文件存储NAS的升级款,NAS Plus提供高达200Gbps的吞 ...
- Codeforces Round #563 (Div. 2) A-D
A. Ehab Fails to Be Thanos 这个A题很简单,就是排个序,然后看前面n个数和后面的n个数是不是相同,相同就输出-1 #include <cstdio> #inclu ...
- python学习之变量以及变量/标识符/关键字
Python成为一门易读.易维护,并且被大量用户所欢迎的.用途广泛的语言,代码简洁,功能强大,是使程序员能够专注于解决问题而不是研究语言本身.接下来我们先从它的语法开始学起 1.首先要懂得python ...
- LeetCode--Unique Email Addresses & Hamming Distance (Easy)
929. Unique Email Addresses (Easy)# Every email consists of a local name and a domain name, separate ...
- 【Kafka】自定义分区策略
自定义分区策略 思路 Command+Option+shift+N 调出查询页面,找到producer包的Partitioner接口 Partitioner下有一个DefaultPartitioner ...
- 设计模式之GOF23原型模式01
原型模式prototype 原型模式: - 通过new产生一个对象需要非常繁琐的数据准备或者访问权限,则可以使用原型模式,比如如果new对象所需时间过长,可以通过克隆产生相同的副本 - Java中的克 ...
- [hdu5195]线段树
题意:给一个DAG,最多可以删去k条边,求字典序最大的拓扑序列.思路:贪心选取当前可选的最大编号即可,同时用线段树维护下.一个节点可以被选,当且仅当没有指向它的边. #include <iost ...
- LeetCode链表专题
链表 套路总结 1.多个指针 移动 2.虚假链表头:凡是有可能删除头节点的都创建一个虚拟头节点,代码可以少一些判断(需要用到首部前一个元素的时候就加虚拟头指针) 3.快慢指针 如leetcode160 ...
- struts2 自定义tag标签
在项目中可能有很多相同的jsp页面表示功能,这时可以使用自定义的tag进行定义,渐少重复的工作量便于日后维护! 下面就基于struts2进行自定义标签的定义与实现: 首先:自定义类MyTag继承str ...
- 笨办法学习python-ex41源码加自己注释
#!/user/bin/env python #-*-coding:utf-8 -*- #Author: qinjiaxi import random from urllib import urlop ...