
Python 爬取 北京市政府首都之窗信件列表-[数据处理]
日期:2020.01.24
博客期:132
星期五
【代码说明,如果要使用此页代码,必须在本博客页面评论区给予说明】
//博客总体说明
1、准备工作
2、爬取工作
3、数据处理(本期博客)
4、信息展示
好了今天是除夕,先给大家说句吉利话,“祝大家打代码代代顺利,码码成功”!我因为回家了,今天没做太多东西... ...呼~
登录虚拟机,启动hadoop和hive,准备做数据处理部分!
//建数据库的语句

create table govdata(

   kind string,

   asker string,

   responser string,

   asktime string,

   responsetime string,

   title string,

   questionSupport int,

   responseSupport string,

   responseUnsupport string,

   questiontext string,

   responsetext string

)  row format delimited

fields terminated by '\t';
处理如下:

之后通过文件导入数据(以"\t"为分隔符进行数据导入):
//从路径为"/data/edu3/govdata"的文件导入数据

load data local inpath '/data/edu3/govdata' into table govdata;
处理如下:

之后对应需求部分的处理正在进行
下面是对数据库的测试:

之后使用文件导入方式导入到mysql (因为是以\t为分隔符所以对应以下代码)
LOAD DATA INFILE

'E:\\课件\\3-2\\大数据\\大三寒假作业\\2020-01-23\\datas.txt'

 INTO TABLE govdata

FIELDS TERMINATED BY '\t'

LINES TERMINATED BY '\n'
导入以后分别使用sql语句去建立三个需求的表:
CREATE table kinddata

As

(

select

 kind as kind,

 count(1) as num

from govdata

group by kind

order by num desc

);

CREATE table yeardata

AS

(

select

SUBSTRING(asktime,1,4) as dt,

 count(*) as num

from govdata

group by dt

)

;

CREATE table responserdata

AS

(

select

  gd.responser as responser,

  count(*) as num

from govdata gd

group by responser

order by num desc

);
得到数据表(可以提供制作网页的数据):

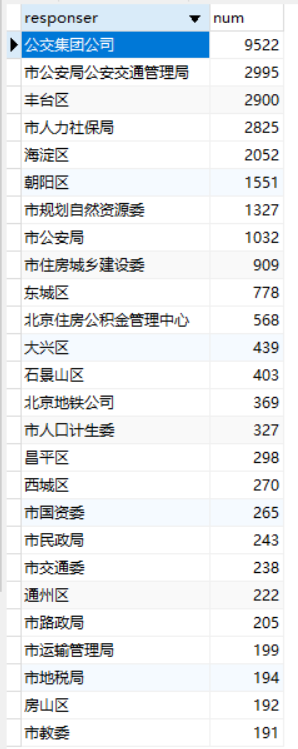

这分别对应的是每年的信件量,回答方对应的信件数,和不同类型的信件数
Python 爬取 北京市政府首都之窗信件列表-[数据处理]的更多相关文章
- Python 爬取 北京市政府首都之窗信件列表-[Scrapy框架](2020年寒假小目标04)
日期:2020.01.22 博客期:130 星期三 [代码说明,如果要使用此页代码,必须在本博客页面评论区给予说明] //博客总体说明 1.准备工作(本期博客) 2.爬取工作 3.数据处理 4.信息展 ...
- Python 爬取 北京市政府首都之窗信件列表-[后续补充]
日期:2020.01.23 博客期:131 星期四 [本博客的代码如若要使用,请在下方评论区留言,之后再用(就是跟我说一声)] //博客总体说明 1.准备工作 2.爬取工作(本期博客) 3.数据处理 ...
- Python 爬取 北京市政府首都之窗信件列表-[信息展示]
日期:2020.01.25 博客期:133 星期六 [代码说明,如果要使用此页代码,必须在本博客页面评论区给予说明] //博客总体说明 1.准备工作 2.爬取工作 3.数据处理 4.信息展示(本期博客 ...
- python爬取北京政府信件信息01
python爬取,找到目标地址,开始研究网页代码格式,于是就开始根据之前学的知识进行爬取,出师不利啊,一开始爬取就出现了个问题,这是之前是没有遇到过的,明明地址没问题,就是显示网页不存在,于是就在百度 ...
- Python爬取招聘信息,并且存储到MySQL数据库中
前面一篇文章主要讲述,如何通过Python爬取招聘信息,且爬取的日期为前一天的,同时将爬取的内容保存到数据库中:这篇文章主要讲述如何将python文件压缩成exe可执行文件,供后面的操作. 这系列文章 ...
- Python 爬取所有51VOA网站的Learn a words文本及mp3音频
Python 爬取所有51VOA网站的Learn a words文本及mp3音频 #!/usr/bin/env python # -*- coding: utf-8 -*- #Python 爬取所有5 ...
- python爬取网站数据
开学前接了一个任务,内容是从网上爬取特定属性的数据.正好之前学了python,练练手. 编码问题 因为涉及到中文,所以必然地涉及到了编码的问题,这一次借这个机会算是彻底搞清楚了. 问题要从文字的编码讲 ...
- python爬取某个网页的图片-如百度贴吧
python爬取某个网页的图片-如百度贴吧 作者:vpoet mail:vpoet_sir@163.com 注:随意copy,不用告诉我 #coding:utf-8 import urllib imp ...
- Python:爬取乌云厂商列表,使用BeautifulSoup解析
在SSS论坛看到有人写的Python爬取乌云厂商,想练一下手,就照着重新写了一遍 原帖:http://bbs.sssie.com/thread-965-1-1.html #coding:utf- im ...
随机推荐
- Android学习05
AlertDialog(对话框) 它也是其他 Dialog的的父类!比如ProgressDialog,TimePickerDialog等,而AlertDialog的父类是:Dialog! AlertD ...
- 2 数据结构的性能分析 timeit
# python数据结构的性能分析 https://www.cnblogs.com/bobo-zhang/p/10521769.html from timeit import Timer #计算运行平 ...
- P1028
一开始没看懂题,看了题解才明白的 = =.思路是,先找规律,会发现有重合部分,利用这些重合部分,写出递推公式. num = 0 时,只有 1 种组合: num = 1 时,只有 1 种组合: num ...
- Navicat连接远程主机(腾讯云服务器)的mysql失败,解决
赋予所有用户远程连接的权限,重启mysql即可连接成功: grant all privileges on . to 'root'@'%' identified by 'admin'; systemct ...
- Python - for循环的本质,迭代器,可迭代对象
参考 https://foofish.net/how-for-works-in-python.html for循环可以迭代一个可迭代(iterable)的对象 原理 生成这个可迭代对象(实现了__it ...
- Windows事件ID
51 Windows 无法找到网络路径.请确认网络路径正确并且目标计算机不忙或已关闭.如果 Windows 仍然无法找到网络路径,请与网络管理员联系. 52 由于网络上有重名,没有连接.请到“控制面板 ...
- 吴裕雄 Bootstrap 前端框架开发——Bootstrap 网格系统实例:响应式的列重置
<!DOCTYPE html> <html> <head> <meta charset="utf-8"> <title> ...
- 吴裕雄 Bootstrap 前端框架开发——Bootstrap 网格系统实例:堆叠的水平
<!DOCTYPE html> <html> <head> <meta charset="utf-8"> <title> ...
- python调用os模块锁定用户
import timeimport osuser_info = { 'mac': {'pwd': '123', 'count': 0, 'locked': False}, 'tank': {'pwd' ...
- NFS网络文件共享系统!
NFS是运行在应用层上的协议,其默认的端口为2049,它适用于linux与linux之间,也适用于linux与unix之间,亦可适用于linux与windows之间 nfs优缺点优点 节省本地硬盘的存 ...