
基于python的爬虫(一)
抓取网页
python核心库
urllib2
实现对静态网页的抓取,不得不说,“人生苦短,我用python”这句话还是有道理的,要是用java来写,这估计得20行代码
(对不住了博客园了,就拿你开刀吧)
def staticFetch():

    url = "http://www.cnblogs.com/"

    request = urllib2.Request(url)

    response = urllib2.urlopen(request)

    print response.read()
实现对动态网页的抓取,采用post请求,如果想用get方法,只需要把参数接在url后面,不需要data这个参数
def postFetch():

    data = 'Keywords:爬虫'

    url = "http://zzk.cnblogs.com/s/blogpost?Keywords=%E7%88%AC%E8%99%AB"

    request = urllib2.Request(url, data)

    response = urllib2.urlopen(request)

    print response.read()
匹配数据
|
正则表达式 |
解释 |
案例(伪代码) |
|
.* |
贪婪模式,匹配除了换行符之外的所有字符 |
str = abcbc regex = a.*c return abcbc |
|
.*? |
非贪婪模式 |
str = abcbc regex = a.*c return abc |
|
(.*?) |
表示只要匹配这一部分 如果是匹配多个则返回的是一个元组类型 |
str = abcbc regex = a(.*)c return b |
|
more |
伪造浏览器请求
urllib2.HTTPError: HTTP Error 403: Forbidden
当你在运行python的时候出现这个错误,则该网址设置过了禁止爬虫访问,需要伪装一下http的请求头,加入如下代码再运行就ok了。
head={'User-Agent':'Mozilla/5.0 (Windows; U; Windows NT 6.1; en-US; rv:1.9.1.6) Gecko/20091201 Firefox/3.5.6'}

urllib2.Request(url,headers=head)
网页乱码问题
看看爬下来的html是什么编码格式的
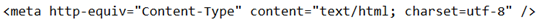
一般都是utf-8,也有gb2312和asic的,保证你的编码和网页的编码是同一种编码。
中文乱码
如果爬下来的网页打印的时候出现\xe6\x96\xb0\xe4\xba\xba这种信息,你可以用以下语句转换成字符串查看
','.join(str)
参考资料
//一个python爬虫从入门到放弃的好博客
http://cuiqingcai.com/1052.html
基于python的爬虫(一)的更多相关文章
- 基于python的爬虫项目
一.项目简介 1.1 项目博客地址 https://www.cnblogs.com/xsfa/p/12083913.html 1.2 项目完成的功能与特色 爬虫和拥有三个可视化数据分析 1.3 项目采 ...
- 基于python的爬虫流程图(精简版)
网址: https://www.processon.com/view/link/5e1148b8e4b07db4cfa9cf34 如果链接失效,请及时反馈(在评论区评论),博主会及时更新
- 一篇文章教会你利用Python网络爬虫获取电影天堂视频下载链接
[一.项目背景] 相信大家都有一种头疼的体验,要下载电影特别费劲,对吧?要一部一部的下载,而且不能直观的知道最近电影更新的状态. 今天小编以电影天堂为例,带大家更直观的去看自己喜欢的电影,并且下载下来 ...
- 基于python的知乎开源爬虫 zhihu_oauth使用介绍
今天在无意之中发现了一个知乎的开源爬虫,是基于Python的,名字叫zhihu_oauth,看了一下在github上面star数还挺多的,貌似文档也挺详细的,于是就稍微研究了一下.发现果然很好用啊.就 ...
- 基于Scrapy框架的Python新闻爬虫
概述 该项目是基于Scrapy框架的Python新闻爬虫,能够爬取网易,搜狐,凤凰和澎湃网站上的新闻,将标题,内容,评论,时间等内容整理并保存到本地 详细 代码下载:http://www.demoda ...
- 基于python的知乎开源爬虫 zhihu
今天在无意之中发现了一个知乎的开源爬虫,是基于Python的,名字叫zhihu_oauth,看了一下在github上面star数还挺多的,貌似文档也挺详细的,于是就稍微研究了一下.发现果然很好用啊.就 ...
- Python分布式爬虫打造搜索引擎完整版-基于Scrapy、Redis、elasticsearch和django打造一个完整的搜索引擎网站
Python分布式爬虫打造搜索引擎 基于Scrapy.Redis.elasticsearch和django打造一个完整的搜索引擎网站 https://github.com/mtianyan/Artic ...
- 基于python爬虫的github-exploitdb漏洞库监控与下载
基于python爬虫的github-exploitdb漏洞库监控与下载 offensive.py(爬取项目历史更新内容) #!/usr/bin/env python # -*- coding:utf- ...
- 基于python的pixiv爬虫
基于python的pixiv爬虫 1.目标 在和朋友吹逼过程中,聊到qq群机器人,突发奇想动手做一个p站每日推荐色图的色图机,遂学习爬虫. 目标: 批量下载首页推荐色图. 由于对qq机器人不熟,先利用 ...
随机推荐
- [SinGuLaRiTy] 数论基础
[SinGuLaRiTy-1004] Copyright (c) SinGuLaRiTy 2017 . All Rights Reserved. 整除: 设a,b为整数,且a不为0,如果存在一个整数q ...
- 【转】HTML5 本地存储五种方案
1.LocalStorage LocalStorage就是Key-Value的简单键值对存储结构,Web Storage除了localStorage的持久性存储外,还 有针对本次回话的sessionS ...
- 转接口IC GM7122:BT656转CVBS芯片 视频编码电路
1 概述 视频编码电路主要实现接收8位CCIR656格式的YUV数据,(例如MPEG解码数据),并编码成CVBS信号,经过D/A转换后输出.基本的编码功能包括副载波产生,色差信号调制,同步信号内 ...
- Java ---自定义标签
本篇文章介绍自定义标签,可能在工作中很少涉及到自己来定义一个标签库,因为我们基本上都是使用的大神写的标签库,基本上直接使用即可,但是从自身的发展来看,通往高级程序员的道路上,开发框架就需要大 ...
- Struts2基础学习(五)—拦截器
一.概述 1.初识拦截器 Interceptor 拦截器类似前面学过的过滤器,是可以在action执行前后执行的代码,是我们做Web开发经常用到的技术.比如:权限控制.日志等.我们也可以将多 ...
- JavaWeb总结(一)—Servlet
一.Servlet生命周期 1.Servlet生命周期 Serlet加载---->实例化---->服务---->销毁 2.init() Servlet容器启动时:读取web.xml配 ...
- 模拟退火算法(SA)求解TSP 问题(C语言实现)
这篇文章是之前写的智能算法(遗传算法(GA).粒子群算法(PSO))的补充.其实代码我老早之前就写完了,今天恰好重新翻到了,就拿出来给大家分享一下,也当是回顾与总结了. 首先介绍一下模拟退火算法(SA ...
- alert 和 console.log的区别
出走半月,一直以为 console.log 和 alert 的用法是一样的,只是表现的形式不同,alert 是以弹框的形式出现,console.log 是在后台打印输出. 但是今天在写东西的时候,发现 ...
- png、jpg、gif三种图片格式的区别
png.jpg.gif三种图片格式的区别 2014-06-17 为什么想整理这方面的类容,我觉得就像油画家要了解他的颜料和画布.雕塑家要了解他的石材一样,作为网页设计师也应该对图片格式的特性有一定 ...
- Go语言及Web框架Beego环境
Go语言及Web框架Beego环境无脑搭建 [原]Go语言及Web框架Beego环境无脑搭建 本文涉及软件均以截至到2013年10月12日的最新版本为准 1. 相关软件准备: 1) go1.2rc1. ...