
用python 抓取B站视频评论,制作词云
python 作为爬虫利器,与其有很多强大的第三方库是分不开的,今天说的爬取B站的视频评论,其实重点在分析得到的评论化作嵌套的字典,在其中取出想要的内容。层层嵌套,眼花缭乱,分析时应细致!步骤分为以下几点:
- F12进入开发者选项
进入B站你想观看的视频页面,例如我看的是咬人猫的一个视频,进入开发者选项后,向下拉取视频评论,这时评论内容才被加载出来,此刻在开发者选项中网络那里就可以看到从网站获取的很多信息,仔细查找,发现我们想要的如下图: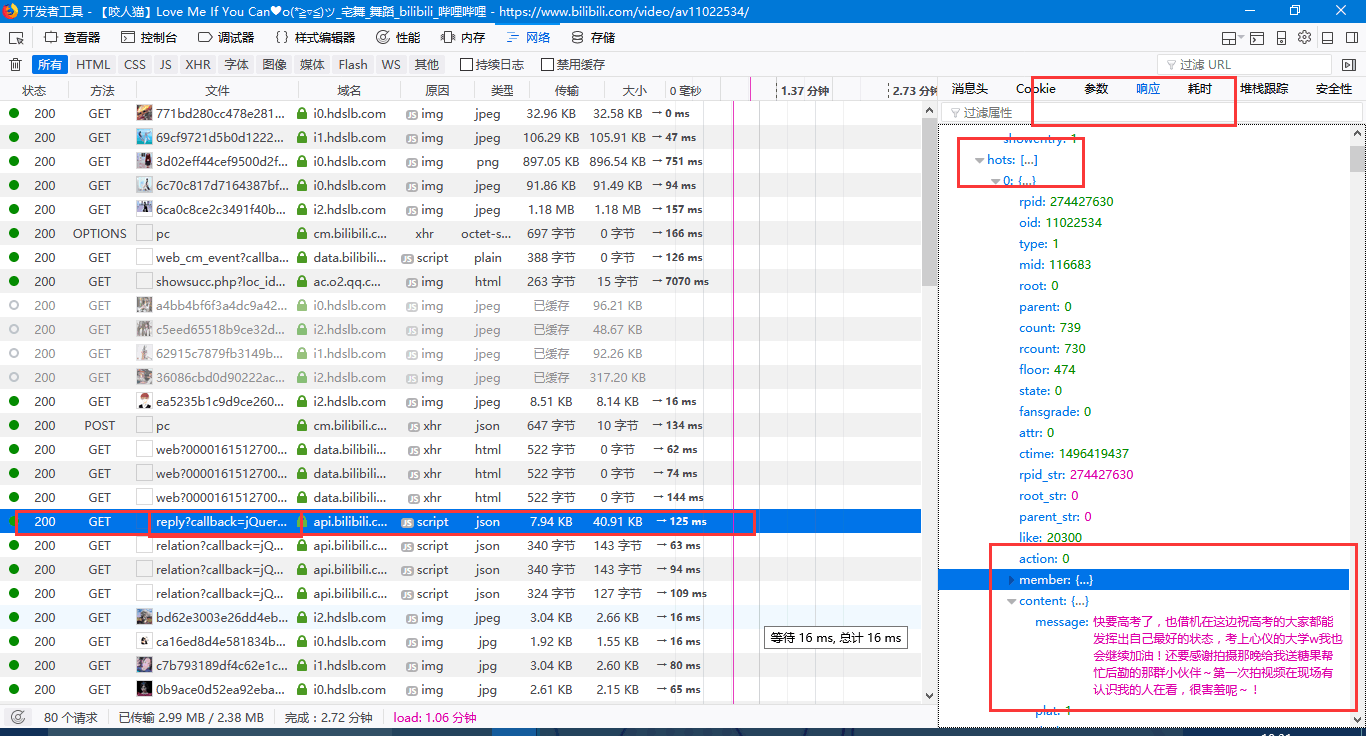
可以看到评论区的内容,点开消息头中的请求网址(https://api.bilibili.com/x/v2/reply?callback=jQuery172048896660782015544_1512700122908&jsonp=jsonp&pn=1&type=1&oid=11022534&sort=0&_=1512700148066),复制粘贴到浏览器中查看,可看到一页的评论内容,取出不必要的网址内容,剩余为:https://api.bilibili.com/x/v2/reply?pn=1&type=1&oid=11022534 ,其中pn即为第几页的评论,oid为视频的av号。 - 分析获取内容字典格式,嵌套内容的包含关系
- 代码获取内容,写入本地文件
 import requests

 import json

 def getHTML(html):

     count=1

     fi=open('bilibili.txt','w',encoding='utf-8')

     while(True):

         url=html+str(count)

         url=requests.get(url)

         if url.status_code==200:

             cont=json.loads(url.text)

         else:

             break

         lengthRpy = len(cont['data']['replies'])

         if count==1:

             try:

                 lengthHot=len(cont['data']['hots'])

                 for i in range(lengthHot):

                     # 热门评论内容

                     hotMsg=cont['data']['hots'][i]['content']['message']

                     fi.write(hotMsg + '\n')

                     leng=len(cont['data']['hots'][i]['replies'])

                     for j in range(leng):

                         # 热门评论回复内容

                         hotMsgRp=cont['data']['hots'][i]['replies'][j]['content']['message']

                         fi.write(hotMsgRp+'\n')

             except:

                 pass

         if lengthRpy!=0:

             for i in range(lengthRpy):

                 comMsg=cont['data']['replies'][i]['content']['message']

                 fi.write(comMsg + '\n')

                 # print('评论:',cont['data']['replies'][i]['content']['message'])

                 leng=len(cont['data']['replies'][i]['replies'])

                 for j in range(leng):

                     comMsgRp=cont['data']['replies'][i]['replies'][j]['content']['message']

                     fi.write(comMsgRp + '\n')

         else:

             break

         print("第%d页写入成功!"%count)

         count += 1

     fi.close()

     print(count-1,'页评论写入成功!')

 url="https://api.bilibili.com/x/v2/reply?type=1&oid="

 av=input("input your url:")

 html=url+av+'&pn='

 getHTML(html)
获取评论内容
- 绘制词云
绘制词云过程分为:读取绘制词云文本,用结巴(第三方库jieba)将文本中高频词汇分出,为词云设置背景图片(可省略),查看及保存绘制词云图
代码如下:from wordcloud import WordCloud,ImageColorGenerator
import matplotlib.pyplot as plt
from PIL import Image
import numpy as np
from os import path
import jieba lj=path.dirname(__file__) #当前文件路径
text=open(path.join(lj,'bilibili.txt'),encoding='utf-8').read() #读取的文本
jieba.add_word('咬人猫')
jieba.add_word('喵酱') #添加结巴分辨不了的词汇
jbText=' '.join(jieba.cut(text))
imgMask=np.array(Image.open(path.join(lj,'msk.png'))) #读入背景图片
wc=WordCloud(
background_color='white',
max_words=500,
font_path='msyh.ttc', #默认不支持中文
mask=imgMask, #设置背景图片
random_state=30 #生成多少种配色方案
).generate(jbText)
ImageColorGenerator(imgMask) #根据图片生成词云颜色
# plt.imshow(wc)
# plt.axis('off')
# plt.show()
wc.to_file(path.join(lj,'biliDM.png'))
print('成功保存词云图片!')词云绘制
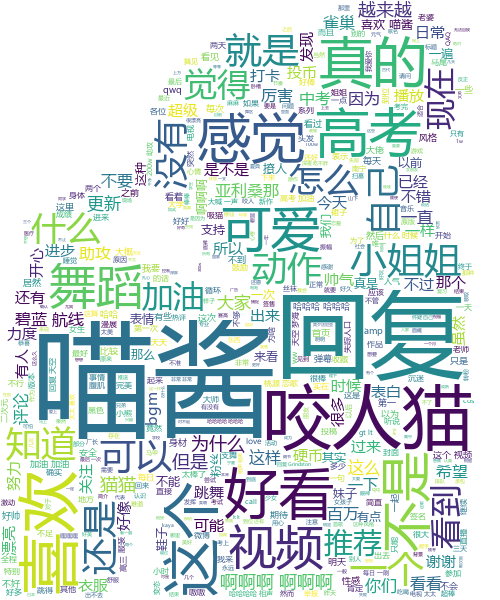
在代码极少的情况下,python就能做出如此惊人的工作,只能是 人生苦短,我用python 了。
原创不易,尊重版权。转载请注明出处:http://www.cnblogs.com/xsmile/
用python 抓取B站视频评论,制作词云的更多相关文章
- 爬取B站弹幕并且制作词云
目录 爬取弹幕 1. 从手机端口进入网页爬取找到接口 2.代码 制作词云 1.文件读取 2.代码 爬取弹幕 1. 从手机端口进入网页爬取找到接口 2.代码 import requests from l ...
- 【Python3 爬虫】16_抓取腾讯视频评论内容
上一节我们已经知道如何使用Fiddler进行抓包分析,那么接下来我们开始完成一个简单的小例子 抓取腾讯视频的评论内容 首先我们打开腾讯视频的官网https://v.qq.com/ 我们打开[电视剧]这 ...
- python爬取B站视频弹幕分析并制作词云
1.分析网页 视频地址: www.bilibili.com/video/BV19E… 本身博主同时也是一名up主,虽然已经断更好久了,但是不妨碍我爬取弹幕信息来分析呀. 这次我选取的是自己 唯一的爆款 ...
- python 爬取B站视频弹幕信息
获取B站视频弹幕,相对来说很简单,需要用到的知识点有requests.re两个库.requests用来获得网页信息,re正则匹配获取你需要的信息,当然还有其他的方法,例如Xpath.进入你所观看的视频 ...
- Python爬取B站视频信息
该文内容已失效,现已实现scrapy+scrapy-splash来爬取该网站视频及用户信息,由于B站的反爬封IP,以及网上的免费代理IP绝大部分失效,无法实现一个可靠的IP代理池,免费代理网站又是各种 ...
- python抓取知识星球精选帖,制作为pdf文件
版权声明:本文为xing_star原创文章,转载请注明出处! 本文同步自http://javaexception.com/archives/90 背景: 这两年知识付费越来越热,我也加入了不少知识星球 ...
- python抓取某学院视频
视频抓取原理:获取所有的知识类别id->然后获取其子项->根据子项链接分析获取该类课程数->循环获取链接指向的视频.需要安装python库:requestspython解析xml使用 ...
- python 爬取腾讯视频评论
import urllib.request import re import urllib.error headers=('user-agent','Mozilla/5.0 (Windows NT 1 ...
- 用Python爬取B站、腾讯视频、爱奇艺和芒果TV视频弹幕!
众所周知,弹幕,即在网络上观看视频时弹出的评论性字幕.不知道大家看视频的时候会不会点开弹幕,于我而言,弹幕是视频内容的良好补充,是一个组织良好的评论序列.通过分析弹幕,我们可以快速洞察广大观众对于视频 ...
随机推荐
- LeetCode 79. Word Search(单词搜索)
Given a 2D board and a word, find if the word exists in the grid. The word can be constructed from l ...
- 基于HTML5 Canvas的3D动态Chart图表
发现现在工业SCADA上或者电信网管方面用图表的特别多,虽然绝大部分人在图表制作方面用的是echarts,他确实好用,但是有些时候我们不能调用别的插件,这个时候就得自己写这些美丽的图表了,然而图表轻易 ...
- CodeForces - 556C Case of Matryoshkas
//////////////////////////////////////////////////////////////////////////////////////////////////// ...
- jQuery选择器(可见性选择器)第五节
<!DOCTYPE HTML PUBLIC "-//W3C//DTD HTML 4.01//EN" "http://www.w3.org/TR/html4/stri ...
- 05).30分钟学会Servlet+过滤器+监听器+实际案例
一.Servlet简介: Servlet程序处理流程 二.Servlet程序实现 实现要求 Servlet属于java ee范畴,而java和javac属于java se范畴,要想编译servlet必 ...
- 《天书夜读:从汇编语言到windows内核编程》六 驱动、设备、与请求
1)跳入到基础篇的内核编程第7章,驱动入口函数DriverEnter的返回值决定驱动程序是否加载成功,当打算反汇编阅读驱动内核程序时,可寻找该位置. 2)DRIVER_OBJECT下的派遣函数(分发函 ...
- [转载] ZooKeeper原理及使用
转载自http://www.wuzesheng.com/?p=2609 ZooKeeper是Hadoop Ecosystem中非常重要的组件,它的主要功能是为分布式系统提供一致性协调(Coordina ...
- percona_xtrabackup
原理 percona xtrabackup备份过程主要分为以下几点: 1.xtrabackup在启动时会记住LSN(log sequence number),然后复制所有的数据文件 2.xtrabac ...
- Python之函数返回多个值
#!/usr/bin/env python26 #-*- coding:utf-8-*- def test(): a = 10 b = 20 return a,b #返回一个元组 atuple= te ...
- java 之 简单工厂模式(大话设计模式)
以前只是看设计模式,每次看完都去理解一次,并没有手动去写代码,所以理解的还不是很深刻,最近查看框架源码,发现很多地方用到的都是设计模式,因为对设计模式理解的不够深刻,所以源码查看进度很慢!现在决定来温 ...