
EM算法索引
把这n个{试验结果来自B的概率}求和得到期望,平均后,得到B出正面的似然估计,同理有p和q。
重复迭代,直到收敛为止
http://blog.csdn.net/junnan321/article/details/8483343/
http://blog.csdn.net/zouxy09/article/details/8537620
http://www.hankcs.com/ml/em-algorithm-and-its-generalization.html
http://www.cnblogs.com/mindpuzzle/archive/2013/04/05/2998746.html
CNN
http://lib.csdn.net/article/deeplearning/50827
http://www.jianshu.com/p/606a33ba04ff
http://blog.csdn.net/abcjennifer/article/details/25912675
GMM:
http://www.cnblogs.com/CBDoctor/archive/2011/11/06/2236286.html(GMM聚类)
https://www.52ml.net/7890.html(Gmm01)
http://blog.csdn.net/sinat_22594309/article/details/65629407(gmm02)
EM算法二次整理:
1、对于含有隐变量的概率问题,不能直接使用最大似然函数解决的原因:运算上面最大似然函数中过多的加号,不能求解!
在推导EM算法之前,先引用《统计学习方法》中EM算法的例子:
例1. (三硬币模型) 假设有3枚硬币,分别记作A,B,C。这些硬币正面出现的概率分别为π,p和q。投币实验如下,先投A,如果A是正面,即A=1,那么选择投B;A=0,投C。最后,如果B或者C是正面,那么y=1;是反面,那么y=0;独立重复n次试验(n=10),观测结果如下: 1,1,0,1,0,0,1,0,1,1假设只能观测到投掷硬币的结果,不能观测投掷硬币的过程。问如何估计三硬币正面出现的概率,即π,p和q的值。
解:设随机变量y是观测变量,则投掷一次的概率模型为

有n次观测数据Y,那么观测数据Y的似然函数为

那么利用最大似然估计求解模型解,即
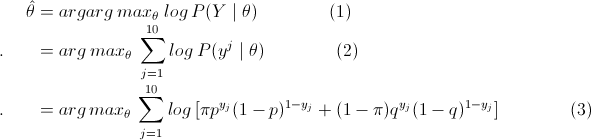
这里将概率模型公式和似然函数代入(1)式中,可以很轻松地推出 (1)=> (2) => (3),然后选取θ(π,p,q),使得(3)式值最大,即最大似然。然后,我们会发现因为(3)中右边多项式+符号的存在,使得(3)直接求偏导等于0或者用梯度下降法都很难求得θ值。
这部分的难点是因为(3)多项式中+符号的存在,而这是因为这个三硬币模型中,我们无法得知最后得结果是硬币B还是硬币C抛出的这个隐藏参数。
那么我们把这个latent 随机变量加入到 log-likelihood 函数中,得
( 对于每一个样例i,让 表示该样例隐含变量z的某种分布,
 满足的条件是
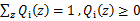 。)

略看一下,好像很复杂,其实很简单,请容我慢慢道来。首先是公式(1),这里将zi做为隐藏变量,当z1为结果由硬币B抛出,z2为结果由硬币C抛出,不难发现
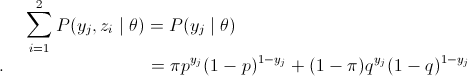
(1)到(2)比较直接,就是分子分母同乘以一个相等的函数。(2)到(3)利用了Jensen不等式
这个过程可以看作是对 求了下界。对于
 的选择,有多种可能,那种更好的?
假设 已经给定,那么
 的值就决定于
 和
 了。我们可以通过调整这两个概率使下界不断上升,以逼近
 的真实值,那么什么时候算是调整好了呢?当不等式变成等式时,说明我们调整后的概率能够等价于
 了。按照这个思路,我们要找到等式成立的条件。根据Jensen不等式,要想让等式成立,需jensen不等式,需要让:
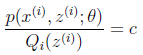 (那么对于每个样例的两个概率比值都是c)
c为常数,不依赖于 。
对此式子做进一步推导,
 ,
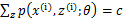
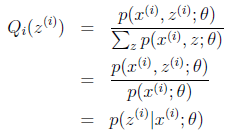
至此,我们推出了在固定其他参数 后,
 的计算公式就是后验概率,解决了
 如何选择的问题。

已经不含有“+”符号了,并且本文认为:后, 建立 的下界时可以认为 log(),这样就不存“+”问题了。接下来的M步,就是在给定
 后,调整
 ,去极大化
 的下界(在固定
 后,下界还可以调整的更大)。
EM算法索引的更多相关文章
- opencv3中的机器学习算法之:EM算法
不同于其它的机器学习模型,EM算法是一种非监督的学习算法,它的输入数据事先不需要进行标注.相反,该算法从给定的样本集中,能计算出高斯混和参数的最大似然估计.也能得到每个样本对应的标注值,类似于kmea ...
- python机器学习笔记:EM算法
EM算法也称期望最大化(Expectation-Maximum,简称EM)算法,它是一个基础算法,是很多机器学习领域的基础,比如隐式马尔科夫算法(HMM),LDA主题模型的变分推断算法等等.本文对于E ...
- 学习笔记——EM算法
EM算法是一种迭代算法,用于含有隐变量(hidden variable)的概率模型参数的极大似然估计,或极大后验概率估计.EM算法的每次迭代由两步组成:E步,求期望(expectation):M步,求 ...
- K-Means聚类和EM算法复习总结
摘要: 1.算法概述 2.算法推导 3.算法特性及优缺点 4.注意事项 5.实现和具体例子 6.适用场合 内容: 1.算法概述 k-means算法是一种得到最广泛使用的聚类算法. 它是将各个聚类子集内 ...
- EM算法总结
EM算法总结 - The EM Algorithm EM是我一直想深入学习的算法之一,第一次听说是在NLP课中的HMM那一节,为了解决HMM的参数估计问题,使用了EM算法.在之后的MT中的词对齐中也用 ...
- GMM的EM算法实现
转自:http://blog.csdn.net/abcjennifer/article/details/8198352 在聚类算法K-Means, K-Medoids, GMM, Spectral c ...
- EM算法(4):EM算法证明
目录 EM算法(1):K-means 算法 EM算法(2):GMM训练算法 EM算法(3):EM算法运用 EM算法(4):EM算法证明 EM算法(4):EM算法证明 1. 概述 上一篇博客我们已经讲过 ...
- EM算法(3):EM算法运用
目录 EM算法(1):K-means 算法 EM算法(2):GMM训练算法 EM算法(3):EM算法运用 EM算法(4):EM算法证明 EM算法(3):EM算法运用 1. 内容 EM算法全称为 Exp ...
- EM算法(2):GMM训练算法
目录 EM算法(1):K-means 算法 EM算法(2):GMM训练算法 EM算法(3):EM算法运用 EM算法(4):EM算法证明 EM算法(2):GMM训练算法 1. 简介 GMM模型全称为Ga ...
随机推荐
- 汇编指令详解--as手册
https://sourceware.org/binutils/docs/as/ Table of Contents 1 Overview 1.1 Structure of this Manual 1 ...
- 标准C程序设计七---46
Linux应用 编程深入 语言编程 标准C程序设计七---经典C11程序设计 以下内容为阅读: <标准C程序设计>(第7版) 作者 ...
- AC日记——乘积最大 洛谷 P1018
题目描述 今年是国际数学联盟确定的“2000――世界数学年”,又恰逢我国著名数学家华罗庚先生诞辰90周年.在华罗庚先生的家乡江苏金坛,组织了一场别开生面的数学智力竞赛的活动,你的一个好朋友XZ也有幸得 ...
- 洛谷——P1331 海战
P1331 海战 题目描述 在峰会期间,武装部队得处于高度戒备.警察将监视每一条大街,军队将保卫建筑物,领空将布满了F-2003飞机.此外,巡洋船只和舰队将被派去保护海岸线.不幸的是因为种种原因,国防 ...
- ElasticSearch常用结构化搜索
最近,需要用到ES的一些常用的结构化搜索命令,因此,看了一些官方的文档,学习了一下.结构化查询指的是查询那些具有内在结构的数据,比如日期.时间.数字都是结构化的. 它们都有精确的格式,我们可以对这些数 ...
- BZOJ 2131 [scoi2010] 传送带
@(BZOJ)[三分法] Description 在一个2维平面上有两条传送带,每一条传送带可以看成是一条线段. 两条传送带分别为线段AB和线段CD. lxhgww在AB上的移动速度为P,在CD上的移 ...
- arch 安装
xfce参考 http://my.oschina.net/u/1408707/blog/182581#OSC_h2_6 chm阅读 – chmsee作为一个苦逼的码农,要忍受各种chm文件的蹂躏,这个 ...
- 第四期coding_group笔记_用CRF实现分词-词性标注
一.背景知识 1.1 什么是分词? NLP的基础任务分为三个部分,词法分析.句法分析和语义分析,其中词法分析中有一种方法叫Tokenization,对汉字以字为单位进行处理叫做分词. Example ...
- PyTorch学习笔记之计算图
1. **args, **kwargs的区别 def build_vocab(self, *args, **kwargs): counter = Counter() sources = [] for ...
- 【mybatis】mybatis中insert操作,返回自增id
需求是这样的: mybatis中insert操作,返回自增id,因为这个自增id需要给后续业务用到. 原本是这样的: 将insert语句传入,正常执行insert操作,返回int永远是 0[失败] 或 ...