
Coursera在线学习---第十节.大规模机器学习(Large Scale Machine Learning)
一、如何学习大规模数据集?
在训练样本集很大的情况下,我们可以先取一小部分样本学习模型,比如m=1000,然后画出对应的学习曲线。如果根据学习曲线发现模型属于高偏差,则应在现有样本上继续调整模型,具体调整策略参见第六节的高偏差时模型如何调整;如果发现模型属于高方差,则可以增加训练样本集。
二、随机梯度下降法(Stochastic Gradient Descent)
之前在讲到优化代价函数的时候,采取的都是“批量梯度下降法”Batch Gradient,这种方法在每次迭代的时候,都需要计算所有的训练样本,对于数以亿计的大规模样本集而言,计算代价太大,再加上需要多次迭代,累加起来计算量更大,收敛速度会比较慢。
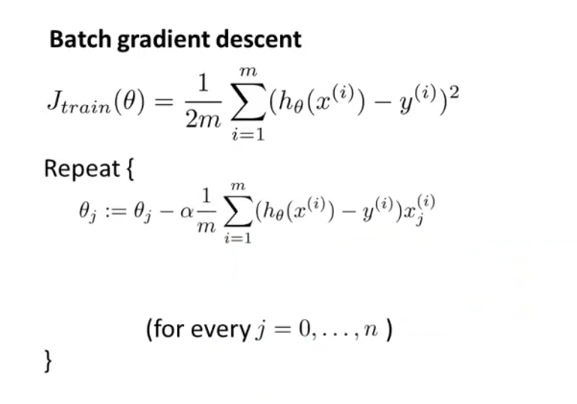
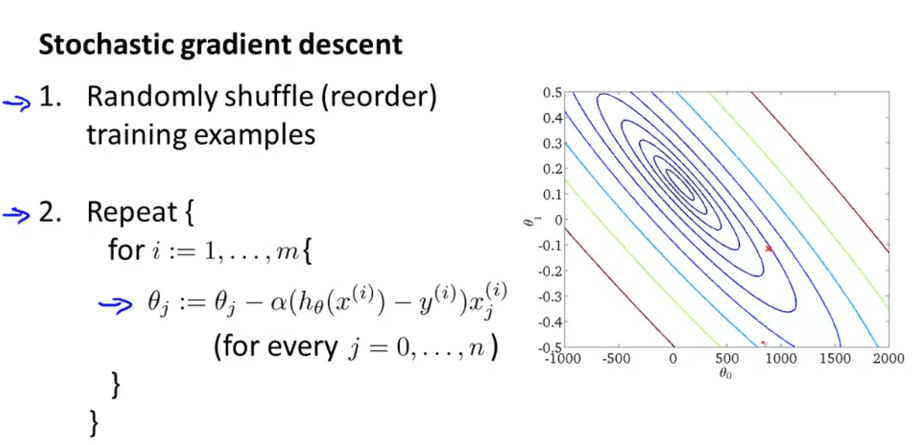
随机梯度下降法,首先打乱样本顺序,然后遍历样本集。对每一个样本就相当于迭代一次,调整一次参数,所以总体计算量小很大。对整个样本集的重复次数也就是1-10次足矣。所以,该算法要快很多。
三、小批量梯度下降法(Mini-batch Gradient Descent)
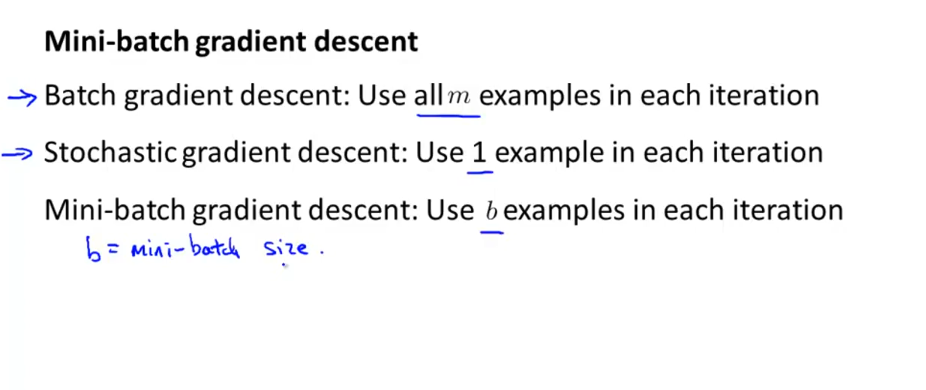
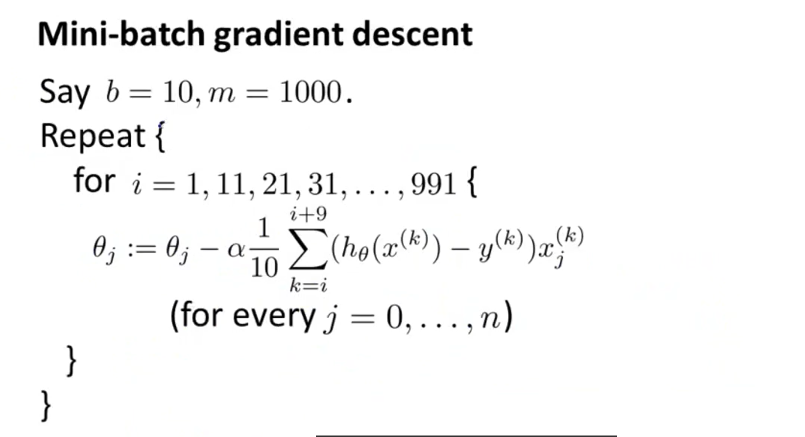
小批量梯度下降法介于批量梯度下降法与随机梯度下降法之间,每次迭代用b个样本数据,b往往=10,或者2~100的数。但是在使用小批量梯度下降法时,如果你采用的是向量化计算时,能够同时并行处理b个样本,此时效率应该比随机梯度法更好,因为其并没有并行处理数据。
四、随机梯度下降法的收敛。
随机梯度下降法最后的收敛不一定是全局最小值,这点跟批量梯度下降法不大一样,而是在全局最小值周围振荡徘徊,只要很接近全局最小值,这也是可以接受的。其实可以动态调整学习速率α=常数1/(迭代次数+常数2),这样随着迭代进行,α逐渐减小,有利于最后收敛到全局最小值。但是由于"常数1"与“常数2”不好确定,所以往往设定α是固定不变的。
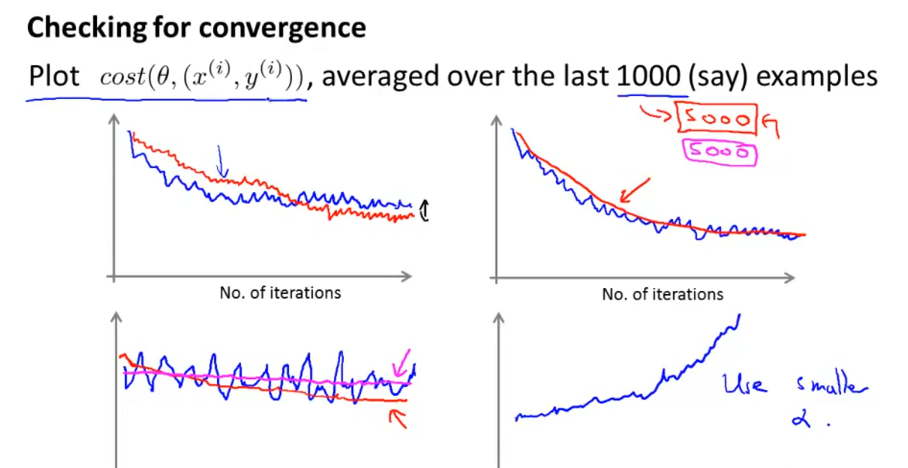
如何判断随着迭代进行,模型在收敛呢?每隔1000或5000个样本,计算这些样本的J值一个总体平均值,然后画出来,如下图所示。从图形走势看模型迭代过程中是不是在下降收敛。如第四张图,走势是上升的,则应调小学习速率α。
五、在线机器学习
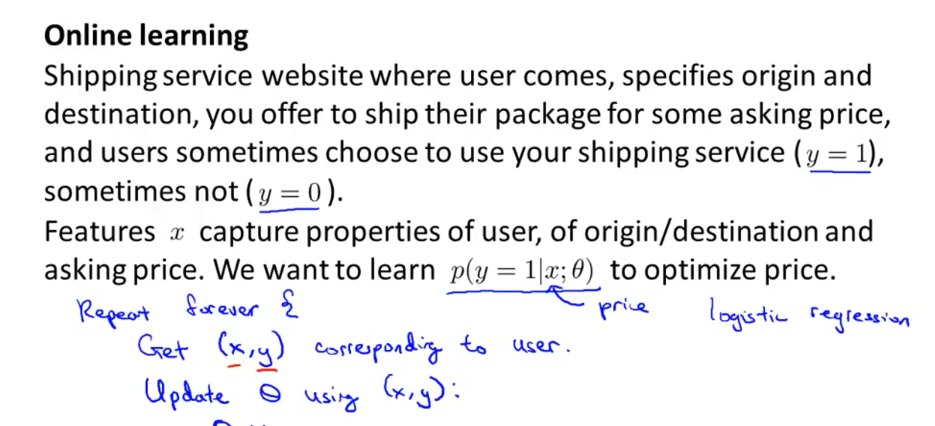
以物流运输为例,当用户登陆网站,选择包裹起始地与目的地后,网站据此提供一个服务价格,用户可能接受,也可能拒绝。一个用户完成后,我们就得到了一个样本(x,y),这样我们就可以用随机梯度下降法来学习了。当有用户源源不断进来时,模型就不断地学习调整参数Θ。即便随着经济发展,用户可以接受更高价格了,模型也能根据用户选择,动态调整参数Θ。在线机器学习的前提是,网站能源源不断地获取大量样本数据。
另一个应用例子就是用户搜索商品时,根据用户的点击情况来动态调整参数,尽量将点击率高的产品推荐给用户。
Coursera在线学习---第十节.大规模机器学习(Large Scale Machine Learning)的更多相关文章
- [C12] 大规模机器学习(Large Scale Machine Learning)
大规模机器学习(Large Scale Machine Learning) 大型数据集的学习(Learning With Large Datasets) 如果你回顾一下最近5年或10年的机器学习历史. ...
- 斯坦福第十七课:大规模机器学习(Large Scale Machine Learning)
17.1 大型数据集的学习 17.2 随机梯度下降法 17.3 微型批量梯度下降 17.4 随机梯度下降收敛 17.5 在线学习 17.6 映射化简和数据并行 17.1 大型数据集的学习
- Ng第十七课:大规模机器学习(Large Scale Machine Learning)
17.1 大型数据集的学习 17.2 随机梯度下降法 17.3 微型批量梯度下降 17.4 随机梯度下降收敛 17.5 在线学习 17.6 映射化简和数据并行 17.1 大型数据集的学习 ...
- Coursera在线学习---第六节.构建机器学习系统
备: High bias(高偏差) 模型会欠拟合 High variance(高方差) 模型会过拟合 正则化参数λ过大造成高偏差,λ过小造成高方差 一.利用训练好的模型做数据预测时,如果效果不好 ...
- 【原】Coursera—Andrew Ng机器学习—课程笔记 Lecture 17—Large Scale Machine Learning 大规模机器学习
Lecture17 Large Scale Machine Learning大规模机器学习 17.1 大型数据集的学习 Learning With Large Datasets 如果有一个低方差的模型 ...
- 大规模机器学习(Large Scale Machine Learning)
本博客是针对Andrew Ng在Coursera上的machine learning课程的学习笔记. 目录 在大数据集上进行学习(Learning with Large Data Sets) 随机梯度 ...
- 吴恩达机器学习笔记(十一) —— Large Scale Machine Learning
主要内容: 一.Batch gradient descent 二.Stochastic gradient descent 三.Mini-batch gradient descent 四.Online ...
- Coursera在线学习---第五节.Logistic Regression
一.假设函数与决策边界 二.求解代价函数 这样推导后最后发现,逻辑回归参数更新公式跟线性回归参数更新方式一摸一样. 为什么线性回归采用最小二乘法作为求解代价函数,而逻辑回归却用极大似然估计求解? 解答 ...
- Coursera在线学习---第四节.过拟合问题
一.解决过拟合问题方法 1)减少特征数量 --人为筛选 --靠模型筛选 2)正则化(Regularization) 原理:可以降低参数Θ的数量级,使一些Θ值变得非常之小.这样的目的既能保证足够的特征变 ...
随机推荐
- string字符串比较和替换
我用的是小写的string!! #include <string> #include <iostream> using namespace std; int main() { ...
- netem设置了网卡的流量控制,为啥发包的延迟就搞不定呢?
为啥我用netem做了一个流量的控制 但是发送的时候,感觉真正发送数据的时候还是没有达到每一个数据包都是1s的延迟呀,这里的1s的延迟是啥意思啊? 这里的delay并不是说每个数据包都delay 5s ...
- do_group_exit函数
一个进程在sleep状态如何获取进程的调用栈 TASK_WAKEUPKILL状态 一个进程sleep了,我如何获取他的用户态栈,如何获取用户堆栈 如何在内核态打印用户态+内核态的栈? 确定上一个调用栈 ...
- Linux面试题汇总答案(转)
转自:小女生的Linux技术~~~Linux面试题汇总答案~~ 一.填空题:1. 在Linux系统中,以 文件 方式访问设备 .2. Linux内核引导时,从文件 /etc/fstab 中读取要加载的 ...
- Hibernate使用详解(一)
一.前言 这些天都在为公司框架重构做准备,浏览了一下代码,挑了几个不熟或者没接触过的知识点进行攻坚,hibernate是其中之一.其实接触hibernate是在大学期间,应该是在2012年,已经201 ...
- WPF中DataGrid的应用-绑定,增改删,分页,样式
参考以下网址: http://www.cnblogs.com/fwbnet/archive/2012/05/08/2490974.html
- request 域 个人理解
1.转发到另一个servlet时候 地址还是输入当前的servlet 2.通过服务器转到另一个servlet时候 另一个servlet是最终接收端 端到端模式 相当于这个东西是发给自己的 只不过经过多 ...
- 【刷题】BZOJ 1717 [Usaco2006 Dec]Milk Patterns 产奶的模式
Description 农夫John发现他的奶牛产奶的质量一直在变动.经过细致的调查,他发现:虽然他不能预见明天产奶的质量,但连续的若干天的质量有很多重叠.我们称之为一个"模式". ...
- 【以前的空间】BZOJ2733[HNOI2012]永无乡
启发式合并?! 似乎当时写并查集的时候就有看到过类似于把小并查集并到大并查集上的说法,原来这就是启发式…… 具体做法就是把小树里面的一个个拿出来,然后加到大树里面去(裸的不敢相信) const max ...
- FPGA学习记录_设计一个计数器
此处设计一个数器,使 学习板上 的 LED 状态每 500ms翻转一次. 学习板上晶振为50MHz,也就是说时钟周期为 20ns , 这样可以计算得出 500ms = 500_000_000ns/20 ...