
Coursera在线学习---第六节.构建机器学习系统
备:
High bias(高偏差) 模型会欠拟合
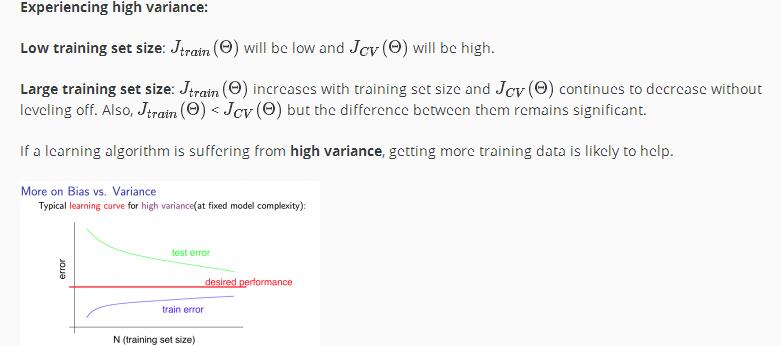
High variance(高方差) 模型会过拟合
正则化参数λ过大造成高偏差,λ过小造成高方差
一、利用训练好的模型做数据预测时,如果效果不好,下一步大概如何做?存在如下几种情况:
1)获取更多的训练样本。(高方差时用。增加训练样本能防止过度拟合,进而防止高方差,因为非常多的训练样本,很难完全拟合)
2)使用更少的特征维度。(高方差时用,因为有可能过拟合了)
3)使用更多的特征维度。(高偏差时用,因为有可能欠拟合了)
4)增加多项式特征。(高偏差时用)
5)减小λ值。(高偏差时用,因为可能欠拟合了)
6)增加λ值。(高方差时用,因为可能过拟合)
二、训练样本分割比例问题
1)通常7:3比例:70%训练样本,30%测试样本
2)另一种是6:2:2 60%训练集 20%验证集 20%测试集
在选取正则化参数λ的值与多项式预测选用最高次数时,均可以采用第(2)种分割方式。
例如:对于多项式最高次数d(d=1,2,...,10),分别用训练集训练出10个模型,然后利用学习后的参数Θ计算验证集的误差Jcv,选取使Jcv最小的一个d。
神经网络的隐藏层数,也可以采用第(2)种方式,用验证集去验证采用几个层比较好,方法同上述多项式。一般来讲,采用一个隐藏层的居多。
三、当模型处于高偏差时,此时模型过于简单,处于欠拟合状态。这个时候增加更多的训练样本,依然不会有用,因为当前的训练样本都没有拟合好,增加更多的样本,更难以拟合好,所以是模型的问题所在。
四、如何平衡查准率和召回率?
采用F1值是一个好办法。
F1=2*[(P*R)/(R+P)] 当P或R=0时,F1=0 (可以防止某一项值过低) ;当P=1且R=1时,F1=1
F1值越大的模型,相对较好一些。
五、什么条件下训练出来的模型最好(总结)?
1)拥有复杂的参数,模型可以防止高偏差。
2)拥有更多的训练样本,可以防止高方差。
所以,如果一个模型拥有相对复杂的参数(也不能太复杂),同时拥有更多的训练样本,这样出来的模型往往是一个较好的模型!
六、根据模型的学习曲线(learning curves)判断模型拟合的好与差。
因为多维数据很难直接画出数据与模型的拟合曲线,通过画模型的学习曲线可以直观看出模型的拟合情况。
High bias(高偏差)

High variance(高方差)
七、在进行多项式回归时,比如:x,x^2,x^3,...,x^8等等,一定要先对x进行归一化,否则的话,x^8的值会非常之大。
Coursera在线学习---第六节.构建机器学习系统的更多相关文章
- Coursera在线学习---第十节.大规模机器学习(Large Scale Machine Learning)
一.如何学习大规模数据集? 在训练样本集很大的情况下,我们可以先取一小部分样本学习模型,比如m=1000,然后画出对应的学习曲线.如果根据学习曲线发现模型属于高偏差,则应在现有样本上继续调整模型,具体 ...
- Coursera在线学习---第七节.支持向量机(SVM)
一.代价函数 对比逻辑回归与支持向量机代价函数. cost1(z)=-log(1/(1+e-z)) cost0(z)=-log(1-1/(1+e-z)) 二.支持向量机中求解代价函数中的C值相当于 ...
- Coursera在线学习---第五节.Logistic Regression
一.假设函数与决策边界 二.求解代价函数 这样推导后最后发现,逻辑回归参数更新公式跟线性回归参数更新方式一摸一样. 为什么线性回归采用最小二乘法作为求解代价函数,而逻辑回归却用极大似然估计求解? 解答 ...
- Coursera在线学习---第四节.过拟合问题
一.解决过拟合问题方法 1)减少特征数量 --人为筛选 --靠模型筛选 2)正则化(Regularization) 原理:可以降低参数Θ的数量级,使一些Θ值变得非常之小.这样的目的既能保证足够的特征变 ...
- Andrew Ng机器学习课程笔记(六)之 机器学习系统的设计
Andrew Ng机器学习课程笔记(六)之 机器学习系统的设计 版权声明:本文为博主原创文章,转载请指明转载地址 http://www.cnblogs.com/fydeblog/p/7392408.h ...
- VUE2.0实现购物车和地址选配功能学习第六节
第六节 地址列表过滤和展开所有的地址 html:<li v-for="(item,index) in filterAddress">js: new Vue({ el:' ...
- Coursera在线学习---第九节(1).异常数据检测(Anomaly Detection)
一.如何构建Anomaly Detection模型? 二.如何评估Anomaly Detection系统? 1)将样本分为6:2:2比例 2)利用交叉验证集计算出F1值,可以用F1值选取概率阈值ξ,选 ...
- Coursera在线学习---第九节(2).推荐系统
一.基于内容的推荐系统(Content Based Recommendations) 所谓基于内容的推荐,就是知道待推荐产品的一些特征情况,将产品的这些特征作为特征变量构建模型来预测.比如,下面的电影 ...
- Coursera在线学习---第二节.Octave学习
1)两个矩阵相乘 A*B 2)两个矩阵元素位相乘(A.B矩阵中对应位置的元素相乘) A.*B 3)矩阵A的元素进行平方 A.^2 4)向量或矩阵中的元素求倒数 1./V 或 1./A 5) ...
随机推荐
- 什么是HotSpot
Java 是动态编译,跟C++静态编译不同,这就是JIT编译器的原因(Just In Time) HotSpot会把这些部门动态地编译成机器码,Native code, 并对机器码进行优化, 静态编译 ...
- BZOJ4976 宝石镶嵌(动态规划)
显然被留下的宝石应该贡献至少一位,否则就可以扔掉.所以如果n-k>=logw,直接输出所有数的or.现在n变得和k同阶了.于是设f[i][j]为前i个数or为j时至少选几个数,转移显然.当然可以 ...
- Day20-单表中获取表单数据的3种方式
1. 搭建环境请参考:http://www.cnblogs.com/momo8238/p/7508677.html 2. 创建表结构 models.py from django.db import m ...
- Debug快捷键
Debug快捷键 1. F5单步调试进入函数内部2. F6单步调试不进入函数内部3. F7由函数内部返回到调用处4. F8一直执行到下一个断点5. F11 重新运行debug
- bzoj3143: [Hnoi2013]游走(贪心+高斯消元)
考虑让总期望最小,那么就是期望经过次数越多的边贪心地给它越小的编号. 怎么求每条边的期望经过次数呢?边不大好算,我们考虑计算每个点的期望经过次数f[x],那么一条边的期望经过次数就是f[x]/d[x] ...
- django 表单验证和字段验证
表单验证和字段验证 表单验证发生在数据验证之后.如果你需要自定义这个过程,有几个不同的地方可以修改,每个地方的目的不一样.表单处理过程中要运行三种类别的验证方法.它们通常在你调用表单的is_valid ...
- maven 启动 tomcat 及 跳过 test 安装
1.先在pom文件中配置 tomcat插件 <!-- 文件上传组件 --> <dependency> <groupId>commons-fileupload< ...
- unity直连android真机在Profiler性能分析测试
基础步骤: 1.Unity打开你要测试的项目:File–Build Settings 2.如下图,按图顺序进行1.2.3.4.5操作,如果做过了,2就是灰色的,不能被点击,4和5需要相对应. 3.确保 ...
- Linux下安装python-2.7 先zlib
2018-04-25 发布 Linux下安装python-2.7 python 1.1k 次阅读 · 读完需要 25 分钟 1 安装依赖的库 yum -y install python-deve ...
- Libevent学习笔记(五) 根据例子学习bufferevent
libevent中提供了一个Hello-world.c 的例子,从这个例子可以学习libevent是如何使用bufferevent的. 这个例子在Sample中 这个例子之前讲解过,这次主要看下buf ...