
SparkMLlib回归算法之决策树
SparkMLlib回归算法之决策树
(一),决策树概念
1,决策树算法(ID3,C4.5 ,CART)之间的比较:
1,ID3算法在选择根节点和各内部节点中的分支属性时,采用信息增益作为评价标准。信息增益的缺点是倾向于选择取值较多的属性,在有些情况下这类属性可能不会提供太多有价值的信息。
2 ID3算法只能对描述属性为离散型属性的数据集构造决策树,其余两种算法对离散和连续都可以处理
2,C4.5算法实例介绍(参考网址:http://m.blog.csdn.net/article/details?id=44726921)
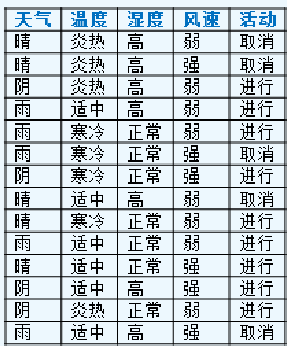
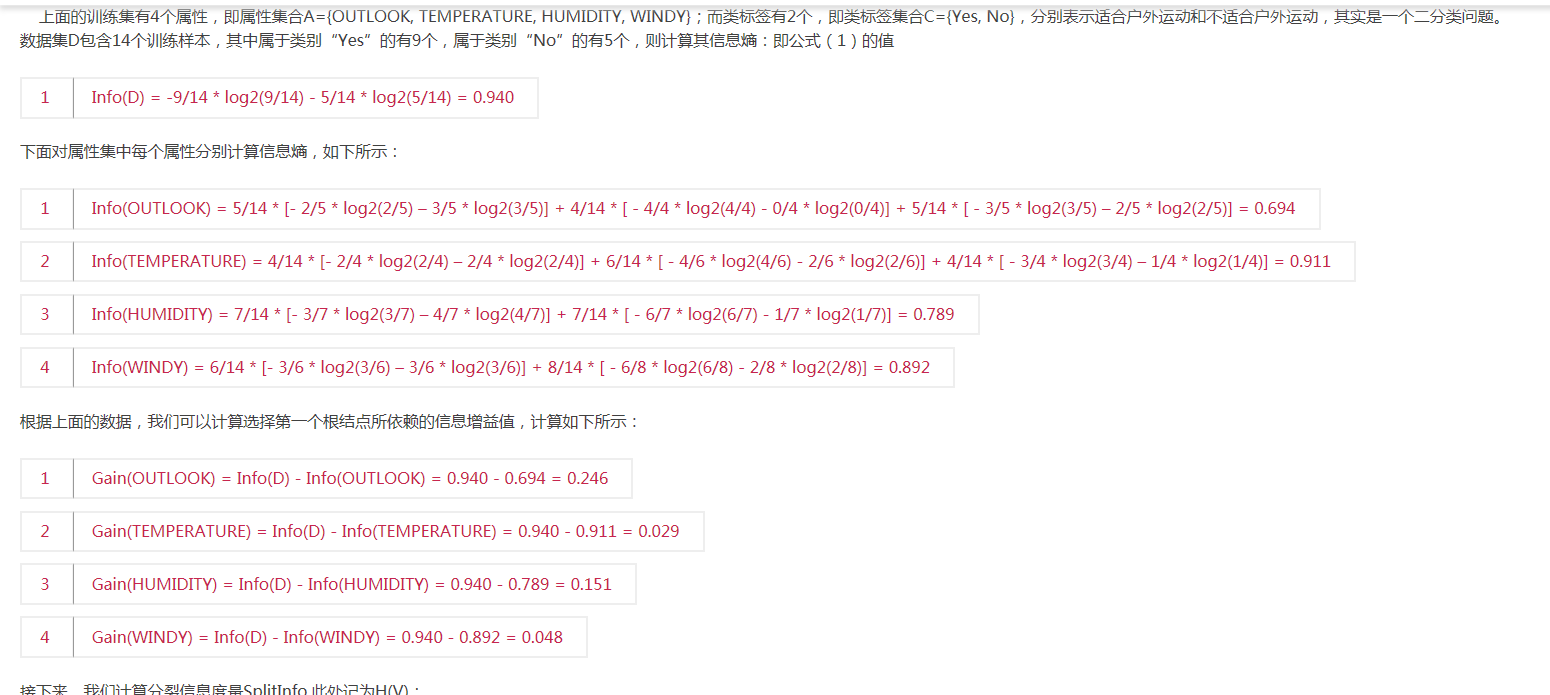
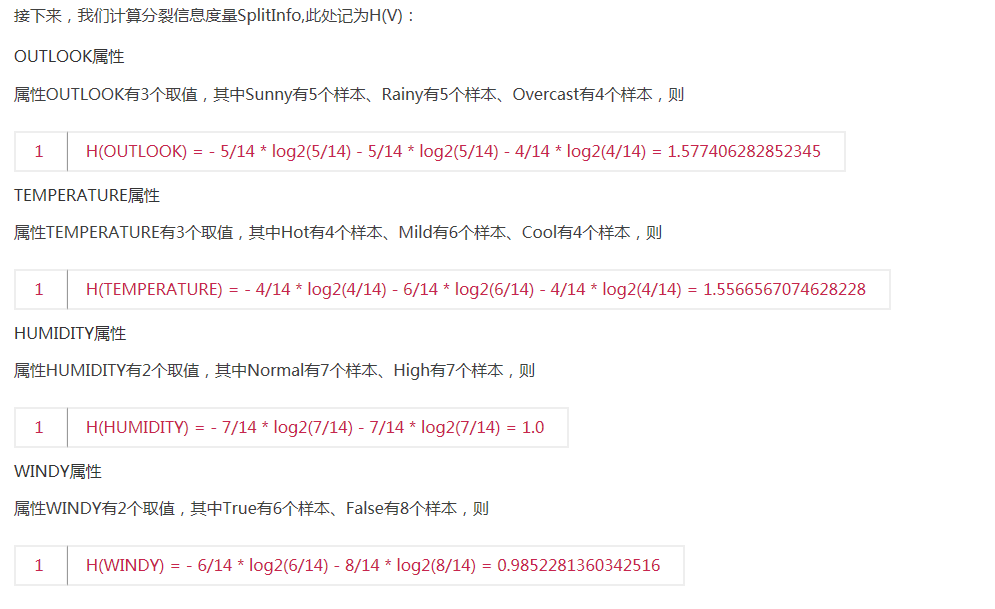
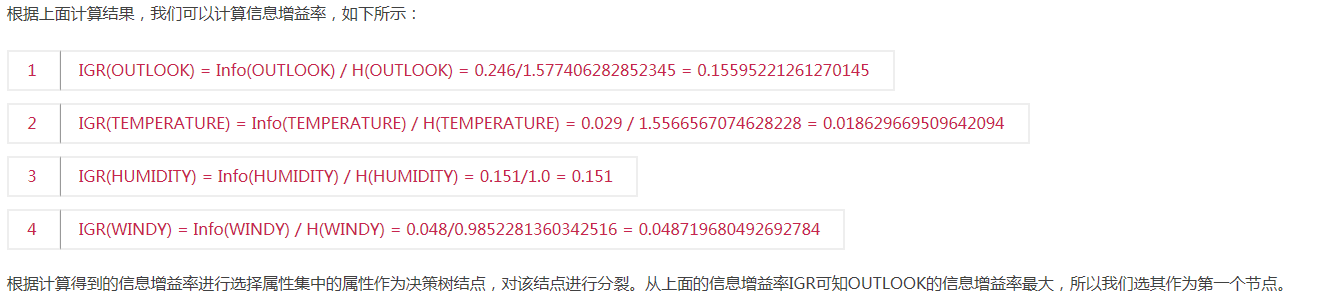
c4.5后剪枝策略:以悲观剪枝为主参考网址:http://www.cnblogs.com/zhangchaoyang/articles/2842490.html
(二) SparkMLlib决策树回归的应用
1,数据集来源及描述:参考http://www.cnblogs.com/ksWorld/p/6891664.html
2,代码实现:
2.1 构建输入数据格式:
val file_bike = "hour_nohead.csv"

    val file_tree=sc.textFile(file_bike).map(_.split(",")).map{

      x =>

        val feature=x.slice(2,x.length-3).map(_.toDouble)

        val label=x(x.length-1).toDouble

        LabeledPoint(label,Vectors.dense(feature))

    }

    println(file_tree.first())

   val categoricalFeaturesInfo = Map[Int,Int]()

    val model_DT=DecisionTree.trainRegressor(file_tree,categoricalFeaturesInfo,"variance",5,32)
2.2 模型评判标准(mse,mae,rmsle)
val predict_vs_train = file_tree.map {

        point => (model_DT.predict(point.features),point.label)

       /* point => (math.exp(model_DT.predict(point.features)), math.exp(point.label))*/

      }

      predict_vs_train.take(5).foreach(println(_))

      /*MSE是均方误差*/

      val mse = predict_vs_train.map(x => math.pow(x._1 - x._2, 2)).mean()

      /* 平均绝对误差(MAE)*/

      val mae = predict_vs_train.map(x => math.abs(x._1 - x._2)).mean()

      /*均方根对数误差(RMSLE)*/

      val rmsle = math.sqrt(predict_vs_train.map(x => math.pow(math.log(x._1 + 1) - math.log(x._2 + 1), 2)).mean())

      println(s"mse is $mse and mae is $mae and rmsle is $rmsle")

/*

mse is 11611.485999495755 and mae is 71.15018786490428 and rmsle is 0.6251152586960916

*/
(三) 改进模型性能和参数调优
1,改变目标量 (对目标值求根号),修改下面语句
LabeledPoint(math.log(label),Vectors.dense(feature))

和

 val predict_vs_train = file_tree.map {

        /*point => (model_DT.predict(point.features),point.label)*/

        point => (math.exp(model_DT.predict(point.features)), math.exp(point.label))

      }

/*结果

mse is 14781.575988339053 and mae is 76.41310991122032 and rmsle is 0.6405996100717035

*/
决策树在变换后的性能有所下降
2,模型参数调优
1,构建训练集和测试集
 val file_tree=sc.textFile(file_bike).map(_.split(",")).map{

      x =>

        val feature=x.slice(2,x.length-3).map(_.toDouble)

        val label=x(x.length-1).toDouble

      LabeledPoint(label,Vectors.dense(feature))

        /*LabeledPoint(math.log(label),Vectors.dense(feature))*/

    }

    val tree_orgin=file_tree.randomSplit(Array(0.8,0.2),11L)

    val tree_train=tree_orgin(0)

    val tree_test=tree_orgin(1)
2,调节树的深度参数
val categoricalFeaturesInfo = Map[Int,Int]()

    val model_DT=DecisionTree.trainRegressor(file_tree,categoricalFeaturesInfo,"variance",5,32)

    /*调节树深度次数*/

    val Deep_Results = Seq(1, 2, 3, 4, 5, 10, 20).map { param =>

      val model = DecisionTree.trainRegressor(tree_train, categoricalFeaturesInfo,"variance",param,32)

      val scoreAndLabels = tree_test.map { point =>

        (model.predict(point.features), point.label)

      }

      val rmsle = math.sqrt(scoreAndLabels.map(x => math.pow(math.log(x._1) - math.log(x._2), 2)).mean)

      (s"$param lambda", rmsle)

    }

/*深度的结果输出*/

    Deep_Results.foreach { case (param, rmsl) => println(f"$param, rmsle = ${rmsl}")}

/*

1 lambda, rmsle = 1.0763369409492645

2 lambda, rmsle = 0.9735820606349874

3 lambda, rmsle = 0.8786984993014815

4 lambda, rmsle = 0.8052113493915528

5 lambda, rmsle = 0.7014036913077335

10 lambda, rmsle = 0.44747906135994925

20 lambda, rmsle = 0.4769214752638845

*/
深度较大的决策树出现过拟合,从结果来看这个数据集最优的树深度大概在10左右
3,调节划分数
/*调节划分数*/

    val ClassNum_Results = Seq(2, 4, 8, 16, 32, 64, 100).map { param =>

      val model = DecisionTree.trainRegressor(tree_train, categoricalFeaturesInfo,"variance",10,param)

      val scoreAndLabels = tree_test.map { point =>

        (model.predict(point.features), point.label)

      }

      val rmsle = math.sqrt(scoreAndLabels.map(x => math.pow(math.log(x._1) - math.log(x._2), 2)).mean)

      (s"$param lambda", rmsle)

    }

    /*划分数的结果输出*/

    ClassNum_Results.foreach { case (param, rmsl) => println(f"$param, rmsle = ${rmsl}")}

/*

2 lambda, rmsle = 1.2995002615220668

4 lambda, rmsle = 0.7682777577495858

8 lambda, rmsle = 0.6615110909041817

16 lambda, rmsle = 0.4981237727958235

32 lambda, rmsle = 0.44747906135994925

64 lambda, rmsle = 0.4487531073836407

100 lambda, rmsle = 0.4487531073836407

*/
更多的划分数会使模型变复杂,并且有助于提升特征维度较大的模型性能。划分数到一定程度之后,对性能的提升帮助不大。实际上,由于过拟合的原因会导致测试集的性能变差。可见分类数应在32左右。。
SparkMLlib回归算法之决策树的更多相关文章
- SparkMLlib分类算法之决策树学习
SparkMLlib分类算法之决策树学习 (一) 决策树的基本概念 决策树(Decision Tree)是在已知各种情况发生概率的基础上,通过构成决策树来求取净现值的期望值大于等于零的概率,评价项目风 ...
- SparkMLlib学习分类算法之逻辑回归算法
SparkMLlib学习分类算法之逻辑回归算法 (一),逻辑回归算法的概念(参考网址:http://blog.csdn.net/sinat_33761963/article/details/51693 ...
- SparkMLlib分类算法之逻辑回归算法
SparkMLlib分类算法之逻辑回归算法 (一),逻辑回归算法的概念(参考网址:http://blog.csdn.net/sinat_33761963/article/details/5169383 ...
- SparkMLlib分类算法之支持向量机
SparkMLlib分类算法之支持向量机 (一),概念 支持向量机(support vector machine)是一种分类算法,通过寻求结构化风险最小来提高学习机泛化能力,实现经验风险和置信范围的最 ...
- Spark MLlib回归算法------线性回归、逻辑回归、SVM和ALS
Spark MLlib回归算法------线性回归.逻辑回归.SVM和ALS 1.线性回归: (1)模型的建立: 回归正则化方法(Lasso,Ridge和ElasticNet)在高维和数据集变量之间多 ...
- Spark MLlib架构解析(含分类算法、回归算法、聚类算法和协同过滤)
Spark MLlib架构解析 MLlib的底层基础解析 MLlib的算法库分析 分类算法 回归算法 聚类算法 协同过滤 MLlib的实用程序分析 从架构图可以看出MLlib主要包含三个部分: 底层基 ...
- Lasso回归算法: 坐标轴下降法与最小角回归法小结
前面的文章对线性回归做了一个小结,文章在这: 线性回归原理小结.里面对线程回归的正则化也做了一个初步的介绍.提到了线程回归的L2正则化-Ridge回归,以及线程回归的L1正则化-Lasso回归.但是对 ...
- 基于Python的函数回归算法验证
看机器学习看到了回归函数,看了一半看不下去了,看到能用方差进行函数回归,又手痒痒了,自己推公式写代码验证: 常见的最小二乘法是一阶函数回归回归方法就是寻找方差的最小值y = kx + bxi, yiy ...
- 机器学习之Logistic 回归算法
1 Logistic 回归算法的原理 1.1 需要的数学基础 我在看机器学习实战时对其中的代码非常费解,说好的利用偏导数求最值怎么代码中没有体现啊,就一个简单的式子:θ= θ - α Σ [( hθ( ...
随机推荐
- Android 调出和隐藏软键盘
1.弹出软键盘 public static void showSoftInputMode(Context context,View windowToken) { final InputMethodMa ...
- 在IntelliJ IDEA中添加repository模板
可以用于快速新建一个repository类,减少开发时间 在IntelliJ IDEA settings设置中(ctrl+alt+s)--Editor--File and Code Templates ...
- 倒排索引的AND操作
这是一道来自百度的面试题.倒排索引的AND操作. 倒排索引是以关键词作为索引项来索引文档的一种机制,如图中Brutus.Calpurnia.Caesar为关键词,2.4.8等等为文档ID. 现在有一个 ...
- Elasticsearch高级搜索排序( 中文+拼音+首字母+简繁转换+特殊符号过滤)
一.先摆需求: 1.中文搜索.英文搜索.中英混搜 如:"南京东路","cafe 南京东路店" 2.全拼搜索.首字母搜索.中文+全拼.中文+首字母混搜 如 ...
- React服务器渲染最佳实践
源码地址:https://github.com/skyFi/dva-starter React服务器渲染最佳实践 dva-starter 完美使用 dva react react-router,最好用 ...
- 速成制作rpm包
FPM 由于很多软件在安装时需要编译,这会浪费不少的时间,为了提升部署效率,于是就想到制作rpm包.通常rpm包的制作是使用rpmbuild命令来制作,但是你需要知道它的语法,比较繁琐.这就用到了FP ...
- 本学期微分方程数值解课程总结(matlab代码)
最简单求解一个微分方程数值解得方法:Euler法 function [x,y]=Euler_method(dufun,span,h,x0,y0) %EuLer格式, %求解方程y'=dufun(x,y ...
- iOS·UIKit框架注解 & Foundation
- 商城项目实战 | 2.2 Android 仿京东商城——自定义 Toolbar (二)
本文为菜鸟窝作者刘婷的连载."商城项目实战"系列来聊聊仿"京东淘宝的购物商城"如何实现. 上一篇文章<商城项目实战 | 2.1 Android 仿京东商城 ...
- focus、blur事件的事件委托处理(兼容各个流浏览器)
今天工作中遇到个问题,问题是这样的,一个form表单中有比较多的input标签,因为form中的input标签中的值都需要前端做客户端校验,由于本人比较懒而且特不喜欢用循环给 每个input元素添加b ...