
Spark RDD(Resilient Distributed Dataset)
基于数据集的处理:从物理存储上加载数据,然后操作数据,然后写入物理存储设备。比如Hadoop的MapReduce。
缺点:1.不适合大量的迭代 2. 交互式查询 3. 不能复用曾经的结果或中间计算结果
基于工作集的处理:如Spark的RDD。
RDD具有如下的弹性:
1. 自动的进行内存和磁盘数据存储的切换
2. 基于Lineage的高效容错
3. Task如果失败会自动进行特定次数的重试
4. Stage如果失败会自动进行特定次数的重试,而且只会计算失败的分片
5. Checkpoint和persist (用于计算结果复用)
6. 数据分片的高度弹性
RDD的写操作是粗粒度的,读操作既可以是粗粒度的也可以是细粒度的.
RDD是分布式函数式编程的抽象。
RDD通过记录数据更新的方式为何高效?
1. RDD是不可变的 + lazy
创建RDD的几种方式:1. 程序中的集合(主要用于测试) 2. 使用本地文件系统(主要用于测试较大量的数据) 3. 使用HDFS 4. 基于DB。5. 基于S3 6. 基于数据流
RDD 依赖分为宽依赖和窄依赖
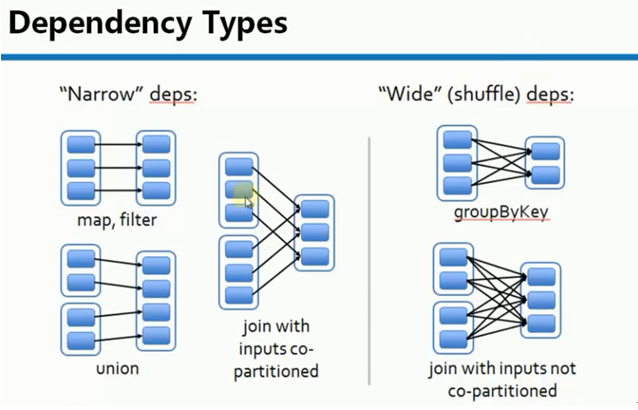
1. 窄依赖是指每个父RDD的Partition最多被子RDD的一个Partition使用。例如:map, filter等会产生窄依赖
2. 宽依赖是指一个父RDD的Partition会被多个子RDD的Partition使用。例如:groupByKey,reduceByKey等会产生宽依赖
宽依赖会产生Shuffle
特别说明:对于join操作有两种情况,如果说join的时候,每个Partition仅仅和已知的Partition进行join,则此时的join操作就是窄依赖;其它情况是宽依赖.
窄依赖不仅包含一对一的窄依赖,还包含一对固定个数的窄依赖(也就是说对父RDD的依赖的Partition的数量不会随着RDD数据规模的改变而改变)
Stage的划分:
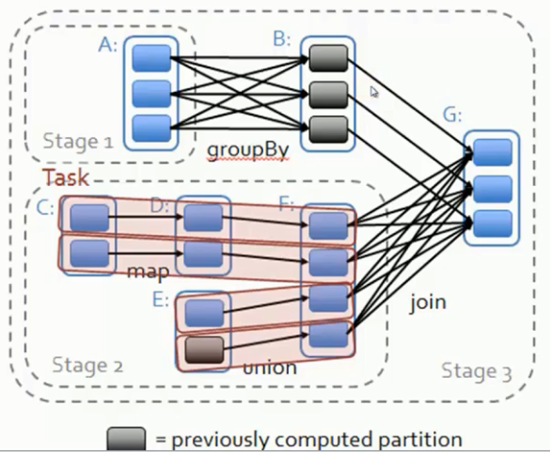
1. 从后往前推,遇到宽依赖就断开,遇到窄依赖就把当前RDD加入到Stage中
2. 每个Stage里面的Task的数量是由该Stage中最后一个RDD的Partition的数量所决定的。
3. 最后一个Stage里面的任务类型是ResultTask,前面其它所有的Stage里面的任务的类型是ShuffleMapTask
窄依赖的物理执行内幕:
一个Stage内部的RDD都是窄依赖,窄依赖计算本身,从逻辑上看是从Stage内部最左侧的RDD开始立即计算的,根据Computing Chain,数据从一个计算步骤流动到下一个计算步骤,以此类推,直到计算到Stage内部的最一个RDD来产生计算结果。
Computing Chain的构建是从后往前回溯构建而成的,而实际的物理计算则是让数据从前往后在算子上流动,直到流动到不能再流动位置才开始计算下一个Record。这就导致了一个美好的结果:后面的RDD不需要等待前面的RDD全部计算完毕才进行计算,极大的提高了计算效率。
宽依赖物理执行内幕:
必须等到依赖的父Stage中最后一个RDD把全部数据计算完毕才能够经过Shuffle来计算当前的Stage.
Spark RDD(Resilient Distributed Dataset)的更多相关文章
- 【Spark】RDD(Resilient Distributed Dataset)究竟是什么?
目录 基本概念 官方文档 概述 含义 RDD出现的原因 五大属性 以单词统计为例,一张图熟悉RDD当中的五大属性 解构图 RDD弹性 RDD特点 分区 只读 依赖 缓存 checkpoint 基本概念 ...
- spark RDD,DataFrame,DataSet 介绍
弹性分布式数据集(Resilient Distributed Dataset,RDD) RDD是Spark一开始就提供的主要API,从根本上来说,一个RDD就是你的数据的一个不可变的分布式元素集合,在 ...
- 2. RDD(弹性分布式数据集Resilient Distributed dataset)
*以下内容由<Spark快速大数据分析>整理所得. 读书笔记的第二部分是讲RDD.RDD 其实就是分布式的元素集合.在 Spark 中,对数据的所有操作不外乎创建RDD.转化已有RDD以及 ...
- [bigdata] Spark RDD整理
1. RDD是什么RDD:Spark的核心概念是RDD (resilient distributed dataset),指的是一个只读的,可分区的弹性分布式数据集,这个数据集的全部或部分可以缓存在内存 ...
- Spark RDD基本概念与基本用法
1. 什么是RDD RDD(Resilient Distributed Dataset)叫做分布式数据集,是Spark中最基本的数据抽象,它代表一个不可变.可分区.里面的元素可并行计算的集合.RDD具 ...
- RDD, DataFrame or Dataset
总结: 1.RDD是一个Java对象的集合.RDD的优点是更面向对象,代码更容易理解.但在需要在集群中传输数据时需要为每个对象保留数据及结构信息,这会导致数据的冗余,同时这会导致大量的GC. 2.Da ...
- Spark RDD理解-总结
1.spark是什么 快速.通用.可扩展的分布式计算引擎. 2. 弹性分布式数据集RDD RDD(Resilient Distributed Dataset),是Spark中最基本的数据抽象结构,表示 ...
- Spark的核心RDD(Resilient Distributed Datasets弹性分布式数据集)
Spark的核心RDD (Resilient Distributed Datasets弹性分布式数据集) 原文链接:http://www.cnblogs.com/yjd_hycf_space/p/7 ...
- RDD内存迭代原理(Resilient Distributed Datasets)---弹性分布式数据集
Spark的核心RDD Resilient Distributed Datasets(弹性分布式数据集) Spark运行原理与RDD理论 Spark与MapReduce对比,MapReduce的计 ...
随机推荐
- 九 Django框架,Form表单验证
表单提交 html <!DOCTYPE html> <html lang="en"> <head> <meta charset=" ...
- C# 多线程 线程池(ThreadPool) 2 如何控制线程池?
线程池启动了,但是没有方法去控制线程池,如果子线程出现了问题,难道线程池就死了吗? 我们可以设置线程池的线程数量,进行加入任务,线程池会自动分配并且合理的执行,但是控制不了又有啥意思呢. 线程池里线程 ...
- 幻想乡三连C:狂飙突进的幻想乡
题解: 不难发现,对于每一条从$S$到$T$的路径,设其$x.y$的和为$S_x.S_y$,其对答案的贡献是$a\cdot S_x+(1-a)\cdot S_y$,这是一个关于$a$的一次函数.而所有 ...
- 9th
2017-2018-2 20179212<网络攻防实践>第9周作业 视频学习 KaliSecurity压力测试工具 压力测试通过确定一个系统的瓶颈或者不能接受的性能点,来获得系统能够提供的 ...
- C++ STL, set用法。 待更新zzzzz
set集合容器:实现了红黑树的平衡二叉检索树的数据结构,插入元素时,它会自动调整二叉树的排列,把元素放到适当的位置,以保证每个子树根节点键值大于左子树所有节点的键值,小于右子树所有节点的键值:另外,还 ...
- ACM学习历程—HDU 5073 Galaxy(数学)
Description Good news for us: to release the financial pressure, the government started selling gala ...
- Javascript:必须知道的Javascript知识点之“单线程事件驱动”
heiboard: Javascript:必须知道的Javascript知识点之“单线程事件驱动”
- eclipse如何集成tomcat插件
刚在Eclipse官方网站下载的Eclipse,需要自己手动安装tomcat插件才能配置tomcat服务器.网上好多安装方法,这里我就不厌其烦的再写一遍,边安装边截图讲解下安装方法. 首先你要去下载E ...
- <table>的使用以及确定取消按钮的设置
<!DOCTYPE html> <html lang="en"> <head> <meta charset="UTF-8&quo ...
- [ural1132]Square Root(cipolla算法)
题意:求${x^2} \equiv n\bmod p$ 解题关键: 定理:若$a$满足$w = {a^2} - n$是模$p$的二次非剩余,即,${x^2} = w\bmod p$无解,则${(a + ...