
机器学习--k-means聚类原理
“物以类聚,人以群分”, 所谓聚类就是将相似的元素分到一"类"(有时也被称为"簇"或"集合"), 簇内元素相似程度高, 簇间元素相似程度低. 常用的聚类方法有划分聚类, 层次聚类, 密度聚类, 网格聚类, 模型聚类等. 我们这里重点介绍划分聚类.
1. 划分聚类
划分聚类, 就是给定一个样本量为N的数据集, 将其划分为K个簇(K<N), 每一个簇中至少包含一个样本点.
大部分的划分方法是基于距离的, 即簇内距离最小化, 簇间距离最大化. 常用的距离计算方法有: 曼哈顿距离和欧几里得距离. 坐标点(x1, y1)到坐标点(x2, y2)的曼哈顿距离和欧几里得距离分别表示为:
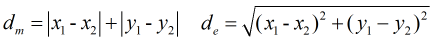
为了达到全局最优解, 传统的划分法可能需要穷举所有可能的划分点, 这计算量是相当大的. 而在实际应用中, 通常会通过计算到均值或中心点的距离进行划分来逼近局部最优, 把计算到均值和到中心点距离的算法分别称为K-MEANS算法和K-MEDOIDS算法, 在这里只介绍K-MEANS算法.
2. K-MEANS算法
K-MEANS算法有时也叫快速聚类算法, 其大致流程为:
第一步: 随机选取K个点, 作为初始的K个聚类中心, 有时也叫质心.
第二步: 计算每个样本点到K个聚类中心的距离, 并将其分给距离最短的簇, 如果k个簇中均至少有一个样本点, 那么我们就说将所有样本点分成了K个簇.
第三步: 计算K个簇中所有样本点的均值, 将这K个均值作为K个新的聚类中心.
第四步: 重复第二步和第三步, 直到聚类中心不再改变时停止算法, 输出聚类结果.
显然, 初始聚类中心的选择对迭代时间和聚类结果产生的影响较大, 选不好的话很有可能严重偏离最优聚类. 在实际应用中, 通常选取多个不同的K值以及初始聚类中心, 选取其中表现最好的作为最终的初始聚类中心. 怎么算表现最好呢? 能满足业务需求的, 且簇内距离最小的.
簇内距离可以簇内离差平方和表示:
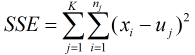
其中, K表示K个簇, nj表示第j个簇中的样本个数, xi表示样本, uj表示第j个簇的质心, K-means算法中质心可以表示为:
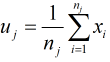
3. 优缺点及注意事项
优点:
1. 原理简单, 计算速度快
2. 聚类效果较理想.
缺点:
1. K值以及初始质心对结果影响较大, 且不好把握.
2. 在大数据集上收敛较慢.
3. 由于目标函数(簇内离差平方和最小)是非凸函数, 因此通过迭代只能保证局部最优.
4. 对于离群点较敏感, 这是由于其是基于均值计算的, 而均值易受离群点的影响.
5. 由于其是基于距离进行计算的, 因此通常只能发现"类圆形"的聚类.
注意事项:
1. 由于其是基于距离进行计算的, 因此通常需要对连续型数据进行标准化处理来缩小数据间的差异.(对于离散型, 则需要进行one-hot编码)
2. 如果采用欧几里得距离进行计算的话, 单位的平方和的平方根是没有意义的, 因此通常需要进行无量纲化处理
机器学习--k-means聚类原理的更多相关文章
- 吴裕雄 python 机器学习——K均值聚类KMeans模型
import numpy as np import matplotlib.pyplot as plt from sklearn import cluster from sklearn.metrics ...
- 机器学习算法与Python实践之(五)k均值聚类(k-means)
机器学习算法与Python实践这个系列主要是参考<机器学习实战>这本书.因为自己想学习Python,然后也想对一些机器学习算法加深下了解,所以就想通过Python来实现几个比较常用的机器学 ...
- 机器学习算法与Python实践之(六)二分k均值聚类
http://blog.csdn.net/zouxy09/article/details/17590137 机器学习算法与Python实践之(六)二分k均值聚类 zouxy09@qq.com http ...
- 100天搞定机器学习|day54 聚类系列:层次聚类原理及案例
几张GIF理解K-均值聚类原理 k均值聚类数学推导与python实现 前文说了k均值聚类,他是基于中心的聚类方法,通过迭代将样本分到k个类中,使每个样本与其所属类的中心或均值最近. 今天我们看一下无监 ...
- 机器学习实战5:k-means聚类:二分k均值聚类+地理位置聚簇实例
k-均值聚类是非监督学习的一种,输入必须指定聚簇中心个数k.k均值是基于相似度的聚类,为没有标签的一簇实例分为一类. 一 经典的k-均值聚类 思路: 1 随机创建k个质心(k必须指定,二维的很容易确定 ...
- 机器学习之路:python k均值聚类 KMeans 手写数字
python3 学习使用api 使用了网上的数据集,我把他下载到了本地 可以到我的git中下载数据集: https://github.com/linyi0604/MachineLearning 代码: ...
- 机器学习之K均值聚类
聚类的核心概念是相似度或距离,有很多相似度或距离的方法,比如欧式距离.马氏距离.相关系数.余弦定理.层次聚类和K均值聚类等 1. K均值聚类思想 K均值聚类的基本思想是,通过迭代的方法寻找K个 ...
- 100天搞定机器学习|day43 几张GIF理解K-均值聚类原理
前文推荐 如何正确使用「K均值聚类」? KMeans算法是典型的基于距离的聚类算法,采用距离作为相似性的评价指标,即认为两个对象的距离越近,其相似度就越大.该算法认为簇是由距离靠近的对象组成的,因此把 ...
- 100天搞定机器学习|day44 k均值聚类数学推导与python实现
[如何正确使用「K均值聚类」? 1.k均值聚类模型 给定样本,每个样本都是m为特征向量,模型目标是将n个样本分到k个不停的类或簇中,每个样本到其所属类的中心的距离最小,每个样本只能属于一个类.用C表示 ...
随机推荐
- mysql-xtrabackup备份sh: xtrabackup_56: command not found与error while loading shared libraries: libssl.so.6: cannot open shared object file: No such file or directory
sh: xtrabackup_56: command not foundinnobackupex: fatal error: no 'mysqld' group in MySQL options解决办 ...
- CentOS7安装HDP集群
之前安装大数据组件都是一个一个手动安装的,最多弄一个脚本自动安装.手动安装麻烦不说,还没有可以监控集群的可视化界面,而且组件的稳定性也是个问题. 所以我们应该试一试HDP和CDH这种企业级的hadoo ...
- C#对屏幕分辨率的操作
winform应用程序 1.新建Resolution.cs类 using System; using System.ComponentModel; using System.Windows.Forms ...
- fontFamily 'Ionicons' is not a system font and has not been loaded through Expo.Font.loadAsync的问题
import * as React from "react";import { Provider } from "mobx-react/native";impo ...
- Python unittest discover()方法与执行顺序补充
一.discover更多测试用例 可以根据不同的功能创建不同的测试文件,甚至是不同的测试目录,测试文件中还可以将不同的小功能划分为不同的测试类,在类下编写测试用例,让整体结构更加清晰 但通过addTe ...
- Access Token 与 Refresh Token【转载哒科普啊】
Access Token 与 Refresh Token access token 是客户端访问资源服务器的令牌.拥有这个令牌代表着得到用户的授权.然而,这个授权应该是临时的,有一定有效期.这是因 ...
- 小程序2-基本架构讲解(一)WXML 模板
项目里边生成了不同类型的文件: .json 后缀的 JSON 配置文件 .wxml 后缀的 WXML 模板文件 .wxss 后缀的 WXSS 样式文件 .js 后缀的 JS 脚本逻辑文件 WXML 模 ...
- 同一台PC,配置多个同一存储平台下的Git账号【两个码云账号,配置在同一台PC上】
问题:配置完 SSH Key, 使用[http地址]拉取代码异常.报一些没有权限的问题. 原因:配置多个gitee账号(码云)后.拉取代码时,应使用~.ssh/config中Host地址,而不是码云给 ...
- javascript 数组的简单应用
<!DOCTYPE html> <html> <head lang="en"> <meta charset="UTF-8&quo ...
- 微信小程序从零开始开发步骤-引入框架WeUI
首先来看下WeUI的官方介绍: WeUI 是一套同微信原生视觉体验一致的基础样式库,由微信官方设计团队为微信内网页和微信小程序量身设计,令用户的使用感知更加统一.在微信小程序的开发过程中,涉及到的前端 ...