
【sklearn】Toy datasets上的分类/回归问题 (XGBoost实践)
分类问题
1. 手写数字识别问题
from sklearn.datasets import load_digits

digits = load_digits()  # 加载手写字符识别数据集

X = digits.data  # 特征值

y = digits.target  # 目标值

X.shape, y.shape
((1797, 64), (1797,))
划分70%训练集,30%测试集,
from sklearn.model_selection import train_test_split

# 划分数据集,70% 训练数据和 30% 测试数据

X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3)

X_train.shape, X_test.shape, y_train.shape, y_test.shape
((1257, 64), (540, 64), (1257,), (540,))
使用默认参数,
import xgboost as xgb

model_c = xgb.XGBClassifier()

model_c
XGBClassifier(base_score=0.5, booster='gbtree', colsample_bylevel=1,
colsample_bynode=1, colsample_bytree=1, gamma=0, learning_rate=0.1,
max_delta_step=0, max_depth=3, min_child_weight=1, missing=None,
n_estimators=100, n_jobs=1, nthread=None,
objective='binary:logistic', random_state=0, reg_alpha=0,
reg_lambda=1, scale_pos_weight=1, seed=None, silent=None,
subsample=1, verbosity=1)
参数解释:
max_depth – 基学习器的最大树深度。
learning_rate – Boosting 学习率。
n_estimators – 决策树的数量。
gamma – 惩罚项系数,指定节点分裂所需的最小损失函数下降值。
booster – 指定提升算法:gbtree, gblinear or dart。
n_jobs – 指定多线程数量。
reg_alpha – L1 正则权重。
reg_lambda – L2 正则权重。
scale_pos_weight – 正负权重平衡。
random_state – 随机数种子。
model_c.fit(X_train, y_train)  # 使用训练数据训练

model_c.score(X_test, y_test)  # 使用测试数据计算准确度
0.9592592592592593
简单调参:
| max_depth | result |
|---|---|
| 1 | 0.912962962962963 |
| 2 | 0.9666666666666667 |
| 3 | 0.9592592592592593 |
| 4 | 0.9629629629629629 |
| 5 | 0.9537037037037037 |
| 6 | 0.9537037037037037 |
max_depth=2时效果最好。
| learning_rate | result |
|---|---|
| 0.05 | 0.9148148148148149 |
| 0.1 | 0.9666666666666667 |
| 0.15 | 0.9777777777777777 |
| 0.2 | 0.9814814814814815 |
| 0.25 | 0.9851851851851852 |
| 0.3 | 0.9796296296296296 |
| 0.35 | 0.9851851851851852 |
| 0.4 | 0.9851851851851852 |
learning_rate设置为0.25比较好。
| n_estimators | result |
|---|---|
| 50 | 0.9722222222222222 |
| 75 | 0.9777777777777777 |
| 100 | 0.9851851851851852 |
| 125 | 0.987037037037037 |
| 150 | 0.987037037037037 |
| 200 | 0.987037037037037 |
n_estimators设置为125比较好。
经过调参,准确率从95.9%提高到了98.7%。
from matplotlib import pyplot as plt

from matplotlib.pylab import rcParams

%matplotlib inline

# 设置图像大小

rcParams['figure.figsize'] = [50, 10]

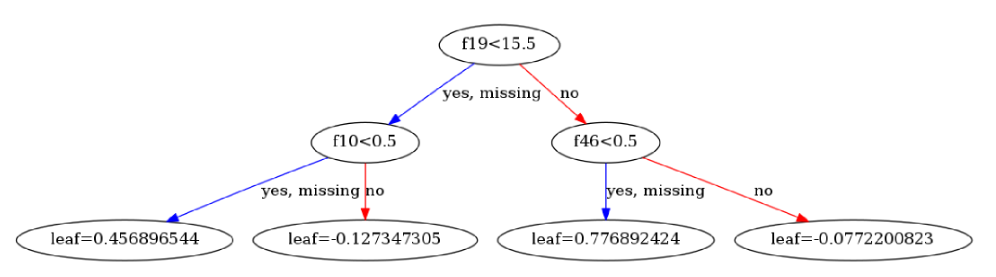
xgb.plot_tree(model_c, num_trees=1)
回归问题
1. 波士顿房价预测问题
from sklearn.datasets import load_boston

boston = load_boston()

X = boston.data  # 特征值

y = boston.target  # 目标值

# 划分数据集,80% 训练数据和 20% 测试数据

X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2)

X_train.shape, X_test.shape, y_train.shape, y_test.shape
((404, 13), (102, 13), (404,), (102,))
默认参数:
model_r = xgb.XGBRegressor()

model_r
XGBRegressor(base_score=0.5, booster='gbtree', colsample_bylevel=1,
colsample_bynode=1, colsample_bytree=1, gamma=0,
importance_type='gain', learning_rate=0.1, max_delta_step=0,
max_depth=3, min_child_weight=1, missing=None, n_estimators=100,
n_jobs=1, nthread=None, objective='reg:linear', random_state=0,
reg_alpha=0, reg_lambda=1, scale_pos_weight=1, seed=None,
silent=None, subsample=1, verbosity=1)
model_r.fit(X_train, y_train)  # 使用训练数据训练

model_r.score(X_test, y_test)  # 使用测试数据计算 R^2 评估指标
0.811524182952107
参考资料
scikit-learn toy datasets doc.
【sklearn】Toy datasets上的分类/回归问题 (XGBoost实践)的更多相关文章
- CART(分类回归树)
1.简单介绍 线性回归方法可以有效的拟合所有样本点(局部加权线性回归除外).当数据拥有众多特征并且特征之间关系十分复杂时,构建全局模型的想法一个是困难一个是笨拙.此外,实际中很多问题为非线性的,例如常 ...
- Sklearn库例子2:分类——线性回归分类(Line Regression )例子
线性回归:通过拟合线性模型的回归系数W =(w_1,…,w_p)来减少数据中观察到的结果和实际结果之间的残差平方和,并通过线性逼近进行预测. 从数学上讲,它解决了下面这个形式的问题: Lin ...
- CART决策树(分类回归树)分析及应用建模
一.CART决策树模型概述(Classification And Regression Trees) 决策树是使用类似于一棵树的结构来表示类的划分,树的构建可以看成是变量(属性)选择的过程,内部节 ...
- 连续值的CART(分类回归树)原理和实现
上一篇我们学习和实现了CART(分类回归树),不过主要是针对离散值的分类实现,下面我们来看下连续值的cart分类树如何实现 思考连续值和离散值的不同之处: 二分子树的时候不同:离散值需要求出最优的两个 ...
- 利用CART算法建立分类回归树
常见的一种决策树算法是ID3,ID3的做法是每次选择当前最佳的特征来分割数据,并按照该特征所有可能取值来切分,也就是说,如果一个特征有四种取值,那么数据将被切分成4份,一旦按某特征切分后,该特征在之后 ...
- 决策树的剪枝,分类回归树CART
决策树的剪枝 决策树为什么要剪枝?原因就是避免决策树“过拟合”样本.前面的算法生成的决策树非常的详细而庞大,每个属性都被详细地加以考虑,决策树的树叶节点所覆盖的训练样本都是“纯”的.因此用这个决策树来 ...
- 分类回归树(CART)
概要 本部分介绍 CART,是一种非常重要的机器学习算法. 基本原理 CART 全称为 Classification And Regression Trees,即分类回归树.顾名思义,该算法既 ...
- from sklearn import datasets运行错误:ImportError: DLL load failed: 找不到指定的程序------解决办法
在运行集成学习的多数投票分类代码时,出现错误 from sklearn import datasets from sklearn.model_selection import cross_val_sc ...
- 秒懂机器学习---分类回归树CART
秒懂机器学习---分类回归树CART 一.总结 一句话总结: 用决策树来模拟分类和预测,那些人还真是聪明:其实也还好吧,都精通的话想一想,混一混就好了 用决策树模拟分类和预测的过程:就是对集合进行归类 ...
随机推荐
- 实验18:HDLC和PPP
实验15-1:HDLC 和PPP 封装 Ø 实验目的通过本实验,读者可以掌握如下技能:(1) 串行链路上的封装概念(2) HDLC 封装(3) PPP 封装 Ø 实验拓扑 实验步骤n ...
- java4选择结构 二
public class jh_01_为什么使用switch选择结构 { /* * 韩嫣参加计算机编程大赛 * 如果获得第一名,将参加麻省理工大学组织的1个月夏令营 * 如果获得第二名,将奖励惠普笔记 ...
- Go语言实现:【剑指offer】数值的整数次方
该题目来源于牛客网<剑指offer>专题. 给定一个double类型的浮点数base和int类型的整数exponent.求base的exponent次方. 保证base和exponent不 ...
- Go语言实现:【剑指offer】二叉树的深度
该题目来源于牛客网<剑指offer>专题. 输入一棵二叉树,求该树的深度.从根结点到叶结点依次经过的结点(含根.叶结点)形成树的一条路径,最长路径的长度为树的深度. Go语言实现: /** ...
- 2020牛客寒假算法基础集训营4 E:最小表达式
E:最小表达式 考察点 : 贪心,高精度 坑点 : 高精度一定不要写错,一定一定不要写错 剩下的就是细节问题 侃侃 : 1.字符串长度达到 5e5,如果要涉及到加法,乘法,普通的肯定会爆 long l ...
- Python 元类 - Metaclasses
Python 元类 - Metaclasses 默认情况下儿, classes 是有 type() 构造的. 类的结构体在一个新的 namespace 被执行, 类的名字 class name 绑定( ...
- Python3(四) 分支、循环、条件与枚举
表达式 表达式(Expression)是运算符(operator)和操作数(operand)所构成的序列 >>> 1 + 1 2 >>> a = [1 ...
- saltstack集合
saltstack集合 saltstack(一): saltstack简介 saltstack(二): saltstack安装及配置 saltstack(三): saltstack远程执行 ...
- tomcat 安装在 linux
简单说下什么是tomcat?它与apache web服务器的关系? Apache是web服务器(静态解析,如HTML),tomcat是java应用服务器(动态解析,如JSP.PHP) Tomcat只是 ...
- [Redis-CentOS7]Redis设置连接密码(九)
设置Redis密码 修改/etc/redis.conf 一定要强密码redis为内存存储 抗暴力破解强 requirepass password 重启服务 systemctl restart redi ...