
Hadoop系列(二):Hadoop单节点部署
环境:CentOS 7
JDK: 1.7.0_80
hadoop:2.8.5
hadoop(192.168.56.101)
配置基础环境
1. 测试环境可以直接关闭selinux和防火墙
2. 主机添加hosts记录
# vim /etc/hosts

192.168.56.101   hadoop
3. 创建hadoop用户
# useradd hadoop

# passwd hadoop
4. 添加免密登陆(如果不添加免密登陆,后面启动服务时候会提示输入密码)
# su - hadoop

$ ssh-keygen -t rsa

$ ssh-copy-id hadoop@localhost
安装JDK
1. 卸载系统自带的openjdk
yum remove *openjdk*
2. 安装JDK
JDK下载地址:https://www.oracle.com/technetwork/java/javase/downloads/java-archive-downloads-javase7-521261.html
# tar zxvf jdk1.7.0_80.tgz -C /usr/local/

# vim /etc/profile

#添加

export JAVA_HOME=/usr/local/jdk1.7.0_80

export JAVA_BIN=$JAVA_HOME/bin

export PATH=$PATH:$JAVA_HOME/bin

export CLASSPATH=.:$JAVA_HOME/lib/dt.jar:$JAVA_HOME/lib/tools.jar

export PATH=$JAVA_HOME/bin:$JRE_HOME/bin:$PATH

# source /etc/profile

# java -version

java version "1.7.0_80"

Java(TM) SE Runtime Environment (build 1.7.0_80-b15)

Java HotSpot(TM) 64-Bit Server VM (build 24.80-b11, mixed mode)
部署Hadoop
在一台机器上配置,之后拷贝到其他节点主机
1. 安装Hadoop
# su - hadooop

$ wget https://www.apache.org/dyn/closer.cgi/hadoop/common/hadoop-2.8.5/hadoop-2.8.5.tar.gz

$ tar zxvf hadoop-2.8.5.tar.gz

$ mv hadoop-2.8.5 hadoop

#添加环境变量(每个节点都配置)

$ vim ~/.bash_profile

export HADOOP_HOME=/home/hadoop/hadoop

export HADOOP_INSTALL=$HADOOP_HOME

export HADOOP_MAPRED_HOME=$HADOOP_HOME

export HADOOP_COMMON_HOME=$HADOOP_HOME

export HADOOP_HDFS_HOME=$HADOOP_HOME

export YARN_HOME=$HADOOP_HOME

export HADOOP_COMMON_LIB_NATIVE_DIR=$HADOOP_HOME/lib/native

export PATH=$PATH:$HADOOP_HOME/sbin:$HADOOP_HOME/bin
export PATH

$ source ~/.bash_profile
2. 配置Hadoop
配置文件在`hadoop/etc/hadoop`目录下
$ cd hadoop/etc/hadoop

#1. 修改core-site.xml

$ vim core-site.xml

<configuration>

  <property>

    <name>fs.default.name</name>

    <value>hdfs://hadoop:9000</value>

  </property>

  <property>

    <name>hadoop.tmp.dir</name>

    <value>file:/home/hadoop/hadoop/tmp</value>

  </property>

</configuration>

# 2. 修改hdfs-site.xml

$ vim hdfs-site.xml

<configuration>

    <property>

    <name>dfs.replication</name>

    <value>2</value>

  </property>

  <property>

    <name>dfs.namenode.name.dir</name>

    <value>file:/home/hadoop/hadoop/tmp/dfs/name</value>

  </property>

  <property>

    <name>dfs.datanode.data.dir</name>

    <value>file:/home/hadoop/hadoop/tmp/dfs/data</value>

  </property>

  <property>

    <name>dfs.namenode.secondary.http-address</name>

    <value>hadoop:9001</value>

  </property>

</configuration>

# 3. 修改mapred-site.xml

$ cp  mapred-site.xml.template mapred-site.xml

$ vim mapred-site.xml

<configuration>

    <property>

    <name>mapreduce.framework.name</name>

    <value>yarn</value>

  </property>

</configuration>

# 4. 修改hadoop-env.sh(如果不声明JAVA_HOME,在启动时会出现找不到JAVA_HOME 错误)

$ vim hadoop-env.sh

export JAVA_HOME=${JAVA_HOME}

改为

export JAVA_HOME=/usr/local/jdk1.7.0_80

# 5. 修改yarn-env.sh(如果不声明JAVA_HOME,在启动时会出现找不到JAVA_HOME 错误)

$ vim yarn-env.sh

在脚本前面添加

export JAVA_HOME=/usr/local/jdk1.7.0_80
3. 格式化HDFS
$ hadoop namenode -format
4. 启动服务
$ sbin/start-dfs.sh

$ sbin/start-yarn.sh
查看启动情况
$ jps

16321 NameNode

16658 ResourceManager

16511 SecondaryNameNode

16927 Jps
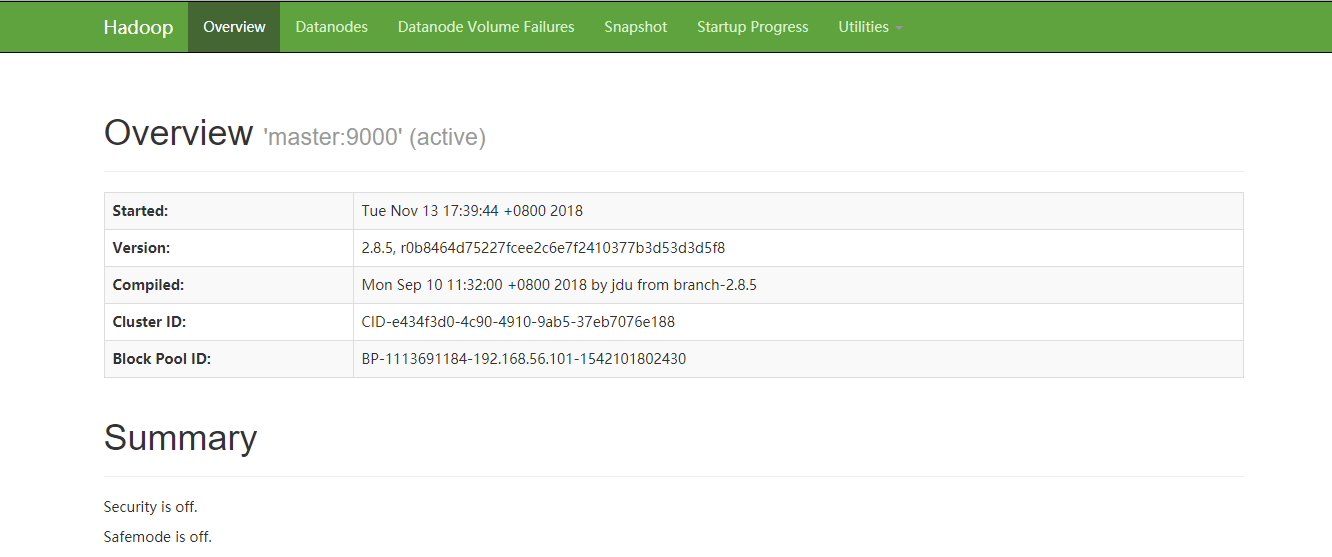
浏览器中访问http://192.168.56.101:50070 查看管理页面
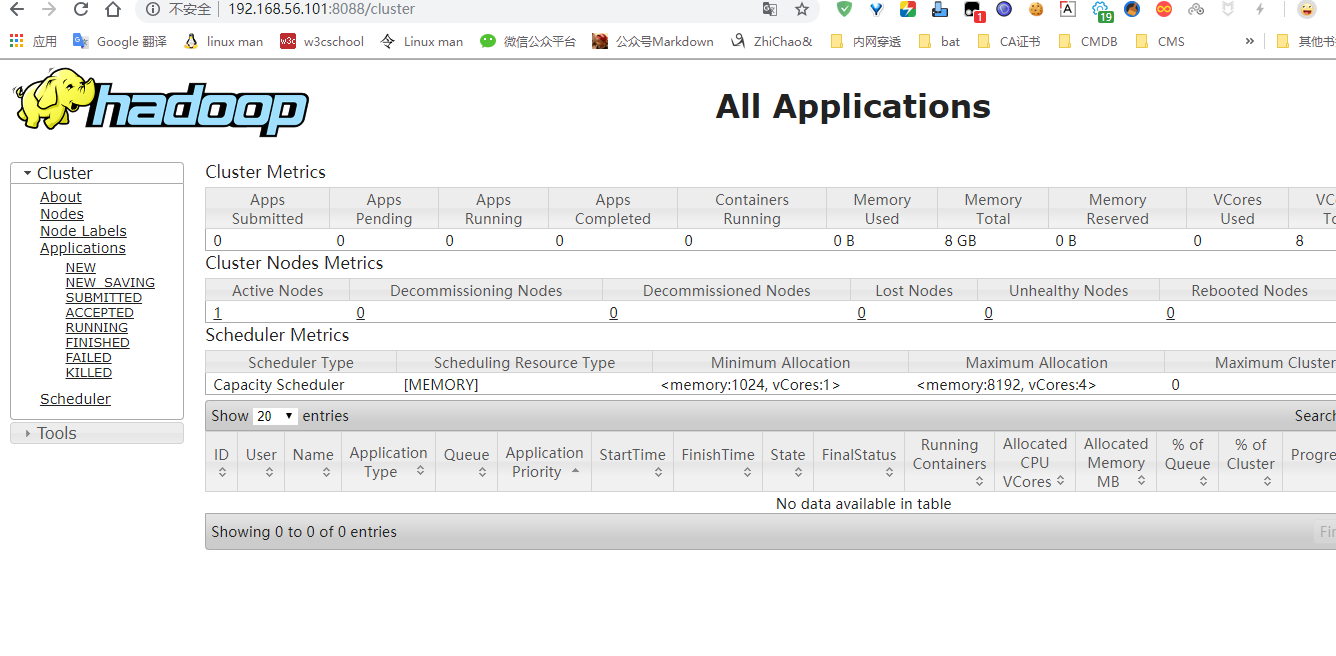
浏览器中访问http://192.168.56.101:8088
测试hadoop使用

Hadoop系列(二):Hadoop单节点部署的更多相关文章
- Hadoop 2.6.4单节点集群配置
1.安装配置步骤 # wget http://download.oracle.com/otn-pub/java/jdk/8u91-b14/jdk-8u91-linux-x64.rpm # rpm -i ...
- Ubuntu下用devstack单节点部署Openstack
一.实验环境 本实验是在Vmware Workstation下创建的单台Ubuntu服务器版系统中,利用devstack部署的Openstack Pike版. 宿主机:win10 1803 8G内存 ...
- .netcore consul实现服务注册与发现-单节点部署
原文:.netcore consul实现服务注册与发现-单节点部署 一.Consul的基础介绍 Consul是HashiCorp公司推出的开源工具,用于实现分布式系统的服务发现与配置.与其他分 ...
- HyperLedger Fabric 1.4 单机单节点部署(10.2)
单机单节点指在一台电脑上部署一个排序(Orderer)服务.一个组织(Org1),一个节点(Peer,属于Org1),然后运行官方案例中的example02智能合约例子,实现转财交易和查询功能.单机单 ...
- Kubernetes 二进制部署(一)单节点部署(Master 与 Node 同一机器)
0. 前言 最近受“新冠肺炎”疫情影响,在家等着,入职暂时延后,在家里办公和学习 尝试通过源码编译二进制的方式在单一节点(Master 与 Node 部署在同一个机器上)上部署一个 k8s 环境,整理 ...
- 单节点部署Hadoop教程
搭建HDFS 增加主机名 我这里仅仅增加了master主机名 [root@10 /xinghl/hadoop/bin]$ cat /etc/hosts 127.0.0.1 localhost 10.0 ...
- Hadoop HDFS 单节点部署方案
初学者,再次记录一下. 确保Java 和 Hadoop已安装完毕(每个人的不一定一样,但肯定都有数据,仅供参考) [root@jans hadoop-2.9.0]# pwd /usr/local/ha ...
- Hadoop入门--HDFS(单节点)配置和部署 (一)
一 配置SSH 下载ssh服务端和客户端 sudo apt-get install openssh-server openssh-client 验证是否安装成功 ssh username@192.16 ...
- Hadoop 2.2.0单节点的伪分布集成环境搭建
Hadoop版本发展历史 第一代Hadoop被称为Hadoop 1.0 1)0.20.x 2)0.21.x 3)0.22.x 第二代Hadoop被称为Hadoop 2.0(HDFS Federatio ...
随机推荐
- Centos7+LVS-DR+Apache负载均衡web实验
一.简介 1.理论已经在上一篇博客简述,不了解得可以看看 https://www.cnblogs.com/zhangxingeng/p/10497279.html 2.LVS-DR优缺点复习 关于这种 ...
- ajax的嵌套需要注意的问题
当我们要嵌套ajax的时候,需要注意 异步/同步 的处理,一般是要设置成同步,如果是异步,那么被嵌套的ajax的操作很可能获取不到想要的值,因为他可能比嵌套他的ajax跑的更早 在ajax中有一个as ...
- [转载]css菜鸟之HTML 中块级元素设置 height:100% 的实现
HTML 中块级元素设置 height:100% 的实现 当你设置一个页面元素的高度(height)为100%时,期望这样元素能撑满整个浏览器窗口的高度,但大多数情况下,这样的做法没有任何效果. 为什 ...
- flex 输入框布局
1:创建一个弹性容器(display:flex) 2:构建2个或3个弹性项目. 3:把弹性项目设置为居中对齐.(align-items:center) 4:改变input自身对齐方式,把它设置为拉伸以 ...
- 【集合框架】JDK1.8源码分析之ArrayList详解(一)
[集合框架]JDK1.8源码分析之ArrayList详解(一) 一. 从ArrayList字表面推测 ArrayList类的命名是由Array和List单词组合而成,Array的中文意思是数组,Lis ...
- What is “Neural Network”
Modern neuroscientists often discuss the brain as a type of computer. Neural networks aim to do the ...
- js清空数组的方法
方式1:splice函数 arrayObject.splice(index,howmany,element1,.....,elementX) index:必选,规定从何处添加/删除元素. howman ...
- pandas.DataFrame的pivot()和unstack()实现行转列
示例: 有如下表需要进行行转列: 代码如下: # -*- coding:utf-8 -*- import pandas as pd import MySQLdb from warnings impor ...
- Windows Server 2008远程桌面默认端口更改方法
win2008远程桌面端口默认是用的是3389端口,但是由于安全考虑,经常我们安装好系统后一般都会考虑把原来的3389端口更改为另外的端口. 本文以改为端口为25608商品为例,讲解一下具体操作过程. ...
- python之三行代码发送邮件
(1)首先进入cmd,输入pip install yagmail (2)思路:1 .连接服务器:yagmail.SMTP(邮箱账号,邮箱密码,邮箱服务器地址,邮箱服务器端口) 2 .准备正文内容:co ...