
Spark入门到精通--(第十节)环境搭建(ZooKeeper和kafka搭建)
上一节搭建完了Hive,这一节我们来搭建ZooKeeper,主要是后面的kafka需要运行在上面。
ZooKeeper下载和安装
下载ZooKeeper 3.4.5软件包 ,可以在百度网盘进行下载。链接: http://pan.baidu.com/s/1gePE9O3 密码: unmt。
下载完用Xftp上传到spark1服务器,我是放在/home/software目录下。
[root@spark1 lib]# cd /home/software/

[root@spark1 software]# tar -zxf zookeeper-3.4.5.tar.gz   //解压

[root@spark1 software]# mv zookeeper-3.4.5 /usr/lib/zookeeper  //重命名并移到/usr/lib目录下

[root@spark1 software]# cd /usr/lib
设置ZooKeeper环境变量。
[root@spark1 lib]# vi ~/.bashrc    //配置环境变量

//添加变量,别忘了Path的变量也要修改

export ZOOKEEPER_HOME=/usr/lib/zookeeper

export PATH=$PATH:$JAVA_HOME/bin:$HADOOP_HOME/bin:$HADOOP_HOME/sbin:$HIVE_HOME/bin:$ZOOKEEPER_HOME/bin    //加上ZooKeeper的路径

保存退出,是文件生效。
[root@spark1 lib]# source ~/.bashrc
完成之后我们开始配置ZooKeeper的配置文件。
- 修改zoo_sample.cfg文件,并且重命名为zoo.cfg。
[root@spark1 lib]# cd zookeeper/conf/

[root@spark1 conf]# mv zoo_sample.cfg zoo.cfg

[root@spark1 conf]# vi zoo.cfg

//修改dataDir

dataDir=/usr/lib/zookeeper/data

//添加(最少配置三个节点)

server.0=spark1:2888:3888

server.1=spark2:2888:3888

server.2=spark3:2888:3888
修改完成保存退出。
然后我们去/usr/lib/zookeeper目录下创建data文件夹,设置标示。
[root@spark1 conf]# cd ..

[root@spark1 zookeeper]# mkdir data

[root@spark1 zookeeper]# cd data

//创建一个myid文件

[root@spark1 data]# vi myid

//添加0

0
修改完成保存退出。
- 将配置文件拷贝到spark2和spark3上,同时myid文件里分别设置1和2.
[root@spark1 data]# cd /usr/lib

//拷贝到spark2上

[root@spark1 lib]# scp -r zookeeper root@spark2:/usr/lib/

[root@spark2 lib]# scp ~/.bashrc root@spark2:~/

//拷贝过去别忘了在spark2上执行source ~/.bashrc命令,使生效
完成后同样在spark3上也拷贝一份。(分别将myid文件里设置为1和2)
- 启动ZooKeeper集群
在三台服务器上分别启动,并检查ZooKeeper状态。
[root@spark1 lib]# zookeeper/bin/zkServer.sh start
三台都启动完成后执行查看启动情况。
[root@spark1 lib]# zookeeper/bin/zkServer.sh status

JMX enabled by default

Using config: /usr/lib/zookeeper/bin/../conf/zoo.cfg

Mode: leader

//关闭  zookeeper/bin/zkServer.sh stop
//重启 zookeeper/bin/zkServer.sh restart
第一台出现Mode:leader,另外2台是Mode:follower,代表OK,ZooKeeper集群完成!
Scala安装
由于之前在第二节已经讲过Scala安装的过程了,现在只要把spark2和spark3都安装上Scala就好了,就不多说了。
kafka安装
下载kafka 2.9.2软件包 ,可以在百度网盘进行下载。链接: http://pan.baidu.com/s/1gePE9O3 密码: unmt。
下载完用Xftp上传到spark1服务器,我是放在/home/software目录下。
[root@spark1 lib]# cd /home/software/

[root@spark1 software]# tar -zxf kafka_2.9.2-0.8.1.tgz

[root@spark1 software]# mv kafka_2.9.2-0.8.1 /usr/lib/kafka

[root@spark1 software]# cd /usr/lib
- 配置kafka
修改配置文件 server.properties文件。
[root@spark1 lib]# vi kafka/config/server.properties

//broker.id是唯一的,默认从0开始

broker.id=0

//修改zookeeper.connect

zookeeper.connect=spark1:2181,spark2:2181,spark3:2181
slf4j安装
下载slf4j 1.7.6软件包 ,放到/home/software目录下。
[root@spark1 software]# unzip slf4j-1.7.6.zip     //解压

//我们把slf4j-1.7.6/slf4j-nop-1.7.6.jar拷贝到kafka的lib下

[root@spark1 software]# cp slf4j-1.7.6/slf4j-nop-1.7.6.jar /usr/lib/kafka/libs/
完成后我们在spark1上的kafka安装完成,然后我们继续把kafka拷贝到spark2和spark3上。(分别将kafka/conf/下的server.properties文件里broker.id设置为1和2)
[root@spark1 lib]# scp -r kafka root@spark2:/usr/lib/
之后可能有些人kafka的集群和JVM不匹配,需要在三台服务器上做个配置。
[root@spark1 kafka]# vi bin/kafka-run-class.sh

//在配置文件中把-XX:+UseCompressedOops 给去掉
- 完成之后我们分别在三台服务器上启动kafka集群
[root@spark1 lib]# cd kafka/    //要在kafka目录下

//启动

[root@spark1 kafka]# nohup bin/kafka-server-start.sh config/server.properties &
[root@spark1 kafka]# jps
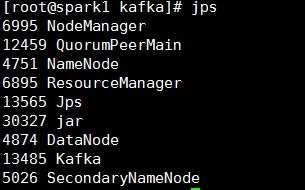
至此kafka配置完成。有问题可以看:http://www.aboutyun.com/thread-12847-1-1.html
kafka测试
//我们创建一个topic

[root@spark1 kafka]# bin/kafka-topics.sh --zookeeper spark1:2181,spark2:2181,spark3:2181 --topic TestTopic --replication-factor 1 --partitions 1 --create

//创建producer

[root@spark1 kafka]# bin/kafka-console-producer.sh --broker-list 10.168.21.169:9092,10.162.59.47:9092,10.168.42.26:9092 --topic TestTopic

//创建comsumer

[root@spark1 kafka]# bin/kafka-console-consumer.sh --zookeeper 10.168.21.169:2181,10.162.59.47:2181,10.168.42.26:2181 --topic TestTopic --from-beginning


这样我们生产者-消费者的测试hello world没问题。
Spark入门到精通--(第十节)环境搭建(ZooKeeper和kafka搭建)的更多相关文章
- Spark入门到精通--(第九节)环境搭建(Hive搭建)
上一节搭建完了Hadoop集群,这一节我们来搭建Hive集群,主要是后面的Spark SQL要用到Hive的环境. Hive下载安装 下载Hive 0.13的软件包,可以在百度网盘进行下载.链接: h ...
- Spark入门到精通--(第二节)Scala编程详解基础语法
Scala是什么? Scala是以实现scaleable language为初衷设计出来的一门语言.官方中,称它是object-oriented language和functional languag ...
- Spark修炼之道(进阶篇)——Spark入门到精通:第九节 Spark SQL执行流程解析
1.总体执行流程 使用下列代码对SparkSQL流程进行分析.让大家明确LogicalPlan的几种状态,理解SparkSQL总体执行流程 // sc is an existing SparkCont ...
- Spark入门到精通--(第一节)Spark的前世今生
最近由于公司慢慢往spark方面开始转型,本人也开始学习,今后陆续会更新一些spark学习的新的体会,希望能够和大家一起分享和进步. Spark是什么? Apache Spark™ is a fast ...
- Simulink仿真入门到精通(十九) 总结回顾&自我练习
从2019年12月27到2020年2月12日,学习了Simulink仿真及代码生成技术入门到精通,历时17天. 学习的比较粗糙,有一些地方还没理解透彻,全书梳理总结: Simulink的基础模块已基本 ...
- Spark入门到精通--(第七节)环境搭建(服务器搭建)
Spark搭建集群比较繁琐,需要的内容比较多,这里主要从Centos.Hadoop.Hive.ZooKeeper.kafka的服务器环境搭建开始讲.其中Centos的搭建不具体说了,主要讲下集群的配置 ...
- Hibernate从入门到精通(十)多对多单向关联映射
上一篇文章Hibernate从入门到精通(九)一对多双向关联映射中我们讲解了一下关于一对多关联映射的相关内容,这次我们继续多对多单向关联映射. 多对多单向关联映射 在讲解多对多单向关联映射之前,首先看 ...
- [置顶] Hibernate从入门到精通(十)多对多单向关联映射
上一篇文章Hibernate从入门到精通(九)一对多双向关联映射中我们讲解了一下关于一对多关联映射的相关内容,这次我们继续多对多单向关联映射. 多对多单向关联映射 在讲解多对多单向关联映射之前,首先看 ...
- Spark入门到精通--(第八节)环境搭建(Hadoop搭建)
上一节把Centos的集群免密码ssh登陆搭建完成,这一节主要讲一下Hadoop的环境搭建. Hadoop下载安装 下载官网的Hadoop 2.4.1的软件包.http://hadoop.apache ...
随机推荐
- DataStructure-链表实现指数非递减一元多项式的求和
// 2-链表实现多项式的求和.cpp : 定义控制台应用程序的入口点. // #include "stdafx.h" #include<stdio.h> #inclu ...
- ActiveMQ:使用Python访问ActiveMQ
Windows 10家庭中文版,Python 3.6.4,stomp.py 4.1.21 ActiveMQ支持Python访问,提供了基于STOMP协议(端口为61613)的库. ActiveMQ的官 ...
- linuxDNS
getenforce 查询状态 setenforce 0 临时关闭 永久关闭vim /etc/selinux/configlinux配置文件内容SELINUC=disabled关闭重启系统生效 ...
- redis-hash操作
hset(name, key, value) # name对应的hash中设置一个键值对(不存在,则创建:否则,修改) # 参数: # name,redis的name # key,name对应的has ...
- IISARR方式整合Tomcat失敗
需要在IIS安裝ARR 目标服务器:targetServer 配置反向代理的服务器:reveseProxServer 1.确定最终访问的网址:比如www.baidu.com .www.csdn.ne ...
- vue-创建新项目
1.安装node,下载地址:https://nodejs.org/en/download/ 2.安装完成后打开cmd,输入node-v,出现版本信息说明安装成功 3.输入npm install -g ...
- Gradle sync failed: SSL peer shut down incorrectly
http://www.th7.cn/Program/Android/201604/817127.shtml 问题是在更新版本后出现的,被墙隔断的原因 引自大神解决方案 这个问题通常出现在Android ...
- 页面报错时隐藏Tomcat信息
一.问题描述Tomcat报错页面泄漏Apache Tomcat/8.0.53相关版本号信息,是攻击者攻击的途径之一.因此实际当中建议去掉版本号信息. 二.解决办法1.进入到tomcat/lib目录下, ...
- C语言fread/fwrite填坑记
坑的描述 用fwrite把数据写入文件,再用fread读取,发现后半部分的数据可能是错的. 原因:原本要写入文件的数据中,有0x0A,如果用的是文本模式打开的文件流,在windows下0x0A会被转换 ...
- SSM框架中常用的配置文件
学习框架,刚开始的时候最烦的就是一些配置文件,有很多需要配置的东西,今天把这些配置文件信息稍微整理一下,以后说不定会用的到. web.xml文件 <?xml version="1.0& ...