
Group by 优化
一个标准的 Group by 语句包含排序、分组、聚合函数,比如 select a,count(*) from t group by a ; 这个语句默认使用 a 进行排序。如果 a 列没有索引,那么就会创建临时表来统计 a和 count(*),然后再通过 sort_buffer 按 a 进行排序。
标准的执行流程
结构:
create table t1(id int primary key, a int, b int, index(a));

delimiter ;;

create procedure idata()

begin

  declare i int;

  set i=1;

  while(i<=1000)do

    insert into t1 values(i, i, i);

    set i=i+1;

  end while;

end;;

delimiter ;

call idata();
函数就是向 t1 中插入1000条语句,从(1,1,1) 到(1000,1000,1000)。
执行 select id%10 as m, count(*) as c from t1 group by m;
解析:

Using index,表示这个语句使用了覆盖索引,选择了索引 a,不需要回表;
Using temporary,表示使用了临时表;
Using filesort,表示需要排序。
过程:
1、创建内存临时表,表里有两个字段 m 和 c,主键是 m;
2、扫描表 t1 的索引 a,依次取出叶子节点上的 id 值,计算 id%10 的结果,记为 x;
1)如果临时表中没有主键为 x 的行,就插入一个记录 (x,1);
2)如果表中有主键为 x 的行,就将 x 这一行的 c 值加 1;
第2 步如果发现内存临时表存储的总字段长度到达参数 tmp_table_size 设置的大小,那么就会将内存临时表升级为磁盘临时表,然后重新开始遍历计算。
3、遍历完成后,再根据字段 m 做排序,得到结果集返回给客户端。
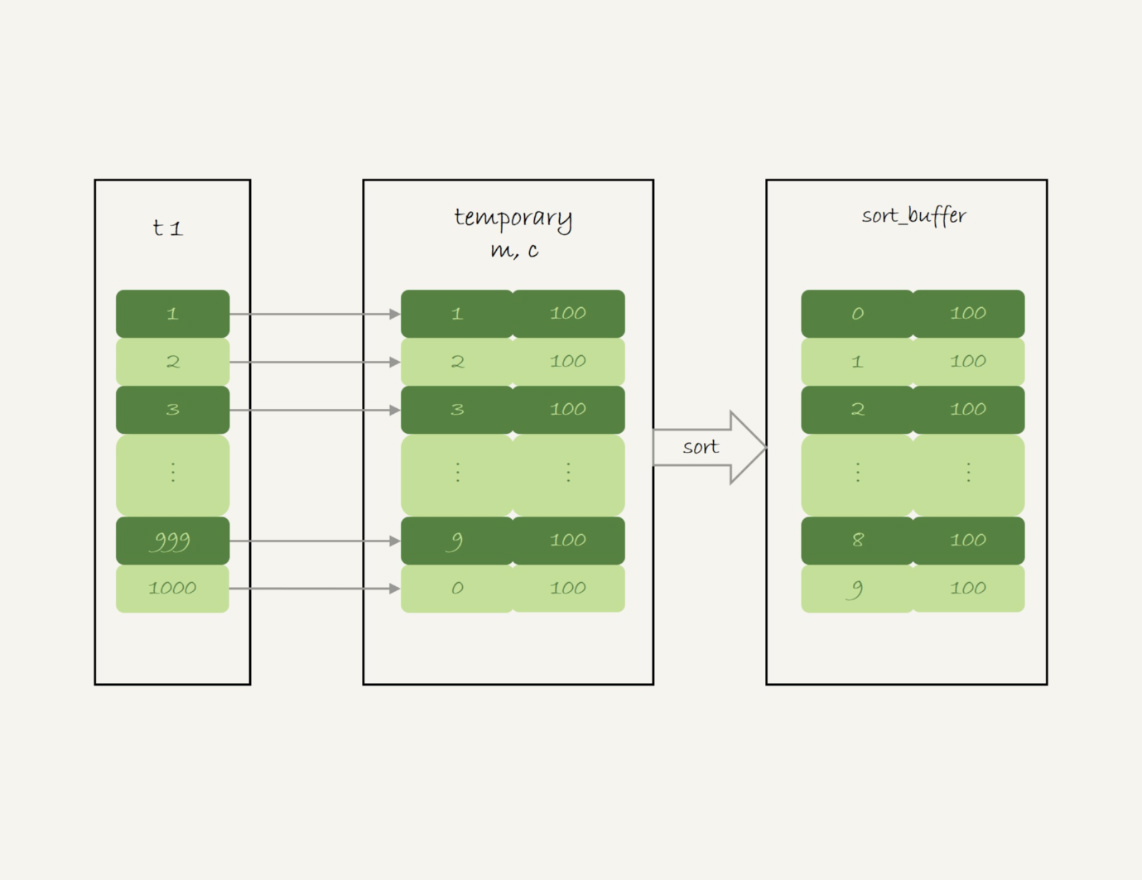
最后的排序就是下图虚线框中的操作,如果 sort_buffer 设置的大小不够大,那么就会使用临时表来辅助排序。
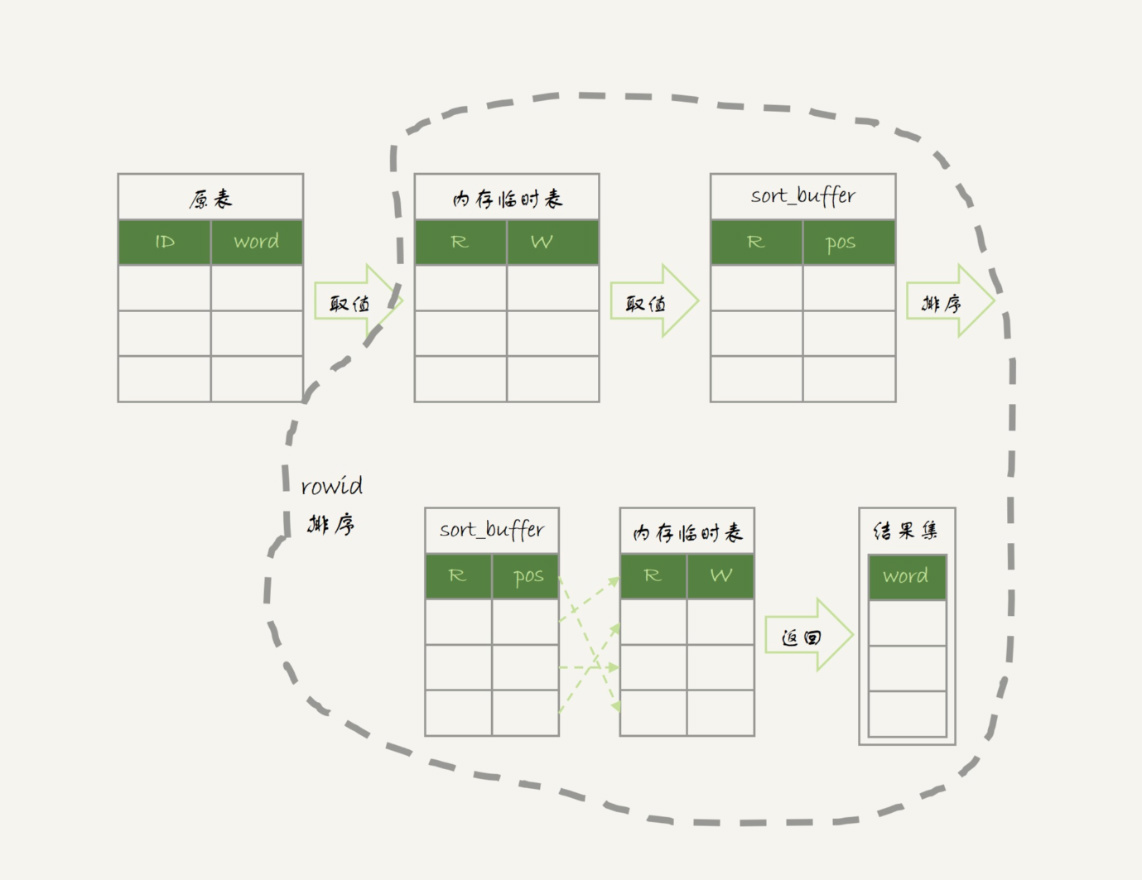
优化
未优化(也就是分组列没有索引)的 group by 的总过程可以概括为:因为数据是无序的,所以需要创建临时表,然后一个一个判断属于哪个分组,最后再根据分组列进行排序。所以,优化可以有两个思路:
去掉排序
在明确返回的数据不需要排序的情况下,可以禁止排序,也就是将上面的语句改成 select a,count(*) from t group by a order by null。
顺序排列
如果记录都按照排序字段排序,那么数据就变成了下面的结构:

这样在实际获取要返回的字段或计算聚合函数时,只需要按顺序依次访问,等到列值变成下一个就知道当前组访问结束,将之前统计的数据直接返回。这样就避免了创建临时表,同时排序也不需要使用 sort_buffer 进行额外排序。这样就极大地提高了执行的效率。
实现
1、如果分组字段适合创建索引就直接为分组字段创建索引。
MySQL 5.7 版本支持了 generated column 机制,用来实现列数据的关联更新。你可以用下面的方法创建一个列 z,然后在 z 列上创建一个索引(如果是 MySQL 5.6 及之前的版本,你也可以创建普通列和索引,来解决这个问题)
alter table t1 add column z int generated always as(id % 100), add index(z);
然后解析:
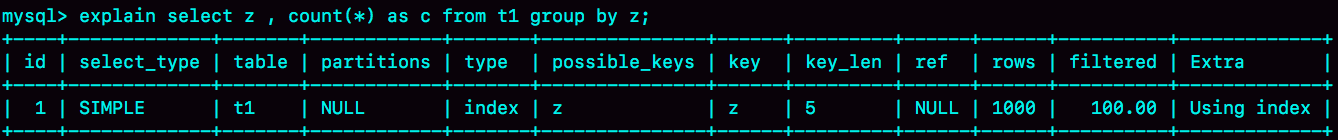
这时没有用到临时表和额外排序,所以性能提升。
2、如果分组字段不适合(使用率很低),那么可以使用 SQL_BIG_RESULT 来尝试优化。
在 group by 语句中加入 SQL_BIG_RESULT 这个提示(hint),就可以告诉优化器:这个语句涉及的数据量很大,请直接用磁盘临时表。MySQL 的优化器一看,磁盘临时表是 B+ 树存储,存储效率不如数组来得高。所以,既然使用SQL_BIG_RESULT来说明数据量很大,那从磁盘空间考虑,还是直接用数组来存吧。所以在使用 SQL_BIG_RESULT 后优化器会使用数组结构的磁盘临时表。
但是如果在未达到磁盘临时表的使用条件是不会使用磁盘临时表的,也就是在 sort_buffer 空间能够存储要返回和排序的总字段长度时,就使用数组结构的 sort_buffer ,如果总字段超过 sort_buffer 大小,那么就再加上数组结构的磁盘临时表来帮助排序。
那么在 sort_buffer 空间足够的情况下, sort_buffer 内部就会对数据进行排序,这样也就起到了索引的作用,
还是以上面的例子来看,使用 SQL_BIG_RESULT
alter table t1 add column z int generated always as(id % 100), add index(z);
具体过程如下:
1、初始化 sort_buffer,确定放入一个整型字段,记为 m;
2、扫描表 t1 的索引 a,依次取出里面的 id 值, 将 id%10 的值存入 sort_buffer 中;
3、扫描完成后,对 sort_buffer 的字段 m 做排序(如果 sort_buffer 内存不够用,就会利用磁盘临时文件辅助排序);
4、排序完成后,就得到了一个有序数组。
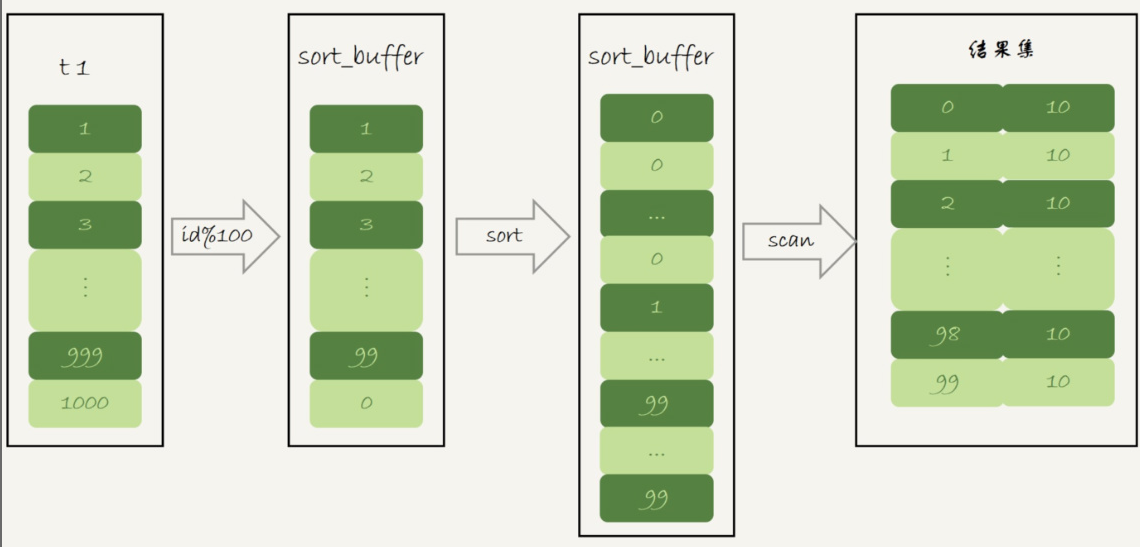
解析:

可以看到此时就没有使用临时表了,而是直接使用 sort_buffer 进行排序,这样就省去了使用临时表带来的性能消耗。
总结
1、如果对 group by 语句的结果没有排序要求,要在语句后面加 order by null;那么一般情况就不需要使用临时表了(上面两个优化都是在要求排序的前提下提出的优化方式)
2、尽量让 group by 过程用上表的索引,确认方法是 explain 结果里没有 Using temporary 和 Using filesort;
3、如果 group by 需要统计的数据量不大,尽量只使用内存临时表;也可以通过适当调大 tmp_table_size 参数,来避免用到磁盘临时表;
4、如果数据量实在太大,使用 SQL_BIG_RESULT 这个提示,来告诉优化器直接使用排序算法得到 group by 的结果。
Group by 优化的更多相关文章
- Mysql查询优化汇总 order by优化例子,group by优化例子,limit优化例子,优化建议
Mysql查询优化汇总 order by优化例子,group by优化例子,limit优化例子,优化建议 索引 索引是一种存储引擎快速查询记录的一种数据结构. 注意 MYSQL一次查询只能使用一个索引 ...
- Hive:表1inner join表2结果group by优化
问题背景 最近遇到一个比较棘手的事情:hive sql优化: lib表(id,h,soj,noj,sp,np) --一个字典表 mitem表(md,mt,soj,noj,sp,np)- ...
- 6.4 group by 优化
1.小总结 group by 实质是先排序后进行分组,遵照索引建的最佳左前缀. 当无法使用索引列,增大max_length_for_sort_data参数的设置 + 增大sort_buffer_siz ...
- MySQL高级 之 order by、group by 优化
参考: https://blog.csdn.net/wuseyukui/article/details/72627667 order by示例 示例数据: Case 1 Case 2 Case 3 ...
- mysql group by优化
mysql> explain select actor.first_name,actor.last_name,count(*) from sakila.film_actor inner join ...
- distinct用group by优化
当数据量非常大,在同一个query中计算多个不相关列的distinct时,往往很容易出现数据倾斜现象,导致运行半天都不能得到结果. 比如以下的SQL语句(a, b, c没有相关性): select d ...
- Mysql group by,order by,dinstict优化
1.order by优化 2.group by优化 3.Dinstinct 优化 1.order by优化 实现方式: 1. 根据索引字段排序,利用索引取出的数据已经是排好序的,直接返回给客户端: 2 ...
- ORDER BY,GROUP BY 和DI STI NCT 优化
读<MySQL性能调优与架构设计>笔记之ORDER BY,GROUP BY 和DI STI NCT 优化 2015年01月18日 18:51:31 lihuayong 阅读数:2593 标 ...
- [MySQL Reference Manual] 8 优化
8.优化 8.优化 8.1 优化概述 8.2 优化SQL语句 8.2.1 优化SELECT语句 8.2.1.1 SELECT语句的速度 8.2.1.2 WHERE子句优化 8.2.1.3 Range优 ...
随机推荐
- 为什么线程安全的List推荐使用CopyOnWriteArrayList,而不是Vector
注:本系列文章中用到的jdk版本均为java8 相比很多同学在刚接触Java集合的时候,线程安全的List用的一定是Vector.但是现在用到的线程安全的List一般都会用CopyOnWriteArr ...
- 使用pdf2htmlEX将pdf文件转为html
https://github.com/coolwanglu/pdf2htmlEX 参考github文档,转换出来的的效果貌似很好,可以参考OFFICE 文档转换为html在线预览. pdf2swf 和 ...
- AES 逻辑
分组长度 加密逻辑 轮函数 参考:链接 字节代换 两种方法: 1.首先(将字节看做GF(28)上的元素,映射到自己的乘法逆元)换成人话就是(对多项式的逆,参考:链接): 其次,对字节做仿射变换 2 ...
- 【转】PANDAS 数据合并与重塑(concat篇)
转自:http://blog.csdn.net/stevenkwong/article/details/52528616 1 concat concat函数是在pandas底下的方法,可以将数据根据不 ...
- docker 安装 运行 卸载
一.卸载docker 安装时使用什么工具安装的docker就用什么工具卸载docker: 1.yum卸载docker 查看已安装的docker yum list installed | grep do ...
- 什么是Solon?
Solon是参考Spring boot 和 Javalin 而设计.吸取了两者的的优点,避开了很多繁重的设计,使其支持http, websocket, socket 三种通讯信号接入.Solon 2M ...
- JavaDailyReports10_05
1 package varycode; 2 3 import java.util.ArrayList; 4 import java.util.Random; 5 6 public class Vary ...
- HTTP 常用状态码200 301 302 403 500
200(OK):成功处理了请求. 301 redirect: 301 代表永久性转移(Permanently Moved) //助记 1 永恒,如果你记住了这一条就算这篇博客没白写.302 redir ...
- Redis--部署操作
1.Redis 1.1 安装 当前ubuntu虚拟机中已经安装好了redis,以下步骤可以跳过 以后自己安装过程如下:redis下载链接:x 指的是版本号 http://download.redis. ...
- ElasticSearch教程——filter与query对比(转学习使用)
一.数据准备 PUT /company/employee/2 { "address": { "country": "china", &quo ...