
梯度下降(Gradient Descent)相关概念
梯度,直观理解:
梯度: 运算的对像是纯量,运算出来的结果会是向量在一个标量场中,
梯度的计算结果会是"在每个位置都算出一个向量,而这个向量的方向会是在任何一点上从其周围(极接近的周围,学过微积分该知道甚么叫极限吧?)标量值最小处指向周围标量值最大处.而这个向量的大小会是上面所说的那个最小与最大的差距程度"
举例子来讲会比较简单,如果现在的纯量场用一座山来表示,纯量值越大的地方越高,反之则越低.经过梯度这个运操作数的运算以后,会在这座山的每一个点上都算出一个向量,这个向量会指向每个点最陡的那个方向,而向量的大小则代表了这个最陡的方向到底有多陡.
梯度下降的直观理解:简而言之,就是下山不知道路怎么走,就走一步算一步
重要概念:
梯度下降(Gradient Descent)小结
如下图,梯度下降不一定能够找到全局的最优解,有可能是一个局部最优解。当然,如果损失函数是凸函数,梯度下降法得到的解就一定是全局最优解。
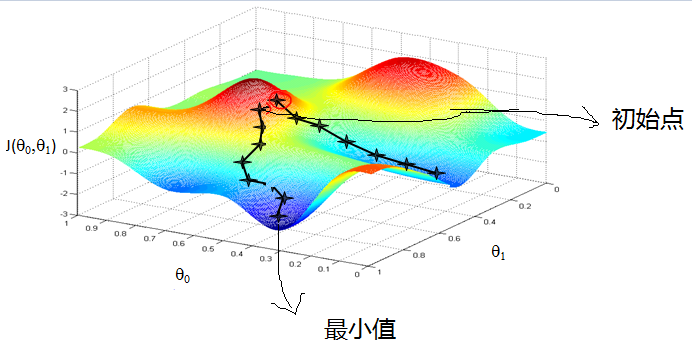
在详细了解梯度下降的算法之前,我们先看看相关的一些概念。
1. 步长(Learning rate):步长决定了在梯度下降迭代的过程中,每一步沿梯度负方向前进的长度。用上面下山的例子,步长就是在当前这一步所在位置沿着最陡峭最易下山的位置走的那一步的长度。
2.特征(feature):指的是样本中输入部分,比如样本(x0,y0),(x1,y1),则样本特征为x,样本输出为y。
3. 假设函数(hypothesis function):在监督学习中,为了拟合输入样本,而使用的假设函数,记为hθ(x)。比如对于样本(xi,yi)(i=1,2,...n),可以采用拟合函数如下: hθ(x) = θ0+θ1x。
4. 损失函数(loss function):为了评估模型拟合的好坏,通常用损失函数来度量拟合的程度。损失函数极小化,意味着拟合程度最好,对应的模型参数即为最优参数。在线性回归中,损失函数通常为样本输出和假设函数的差取平方。比如对于样本(xi,yi)(i=1,2,...n),采用线性回归,损失函数为:
\(J(\theta_0, \theta_1) = \sum\limits_{i=1}^{m}(h_\theta(x_i) - y_i)^2\)
其中\(x_i\)表示样本特征x的第i个元素,\(y_i\)表示样本输出y的第i个元素,\(h_\theta(x_i)\)为假设函数。


 表示向量x中的第i个元素;
 表示向量y中的第i个元素;
 表示已知的假设函数;
|
比如给定数据集(1,1)、(2,2)、(3,3) |
梯度下降(Gradient Descent)相关概念的更多相关文章
- 机器学习(1)之梯度下降(gradient descent)
机器学习(1)之梯度下降(gradient descent) 题记:最近零碎的时间都在学习Andrew Ng的machine learning,因此就有了这些笔记. 梯度下降是线性回归的一种(Line ...
- 梯度下降(Gradient Descent)小结 -2017.7.20
在求解算法的模型函数时,常用到梯度下降(Gradient Descent)和最小二乘法,下面讨论梯度下降的线性模型(linear model). 1.问题引入 给定一组训练集合(training se ...
- 梯度下降(gradient descent)算法简介
梯度下降法是一个最优化算法,通常也称为最速下降法.最速下降法是求解无约束优化问题最简单和最古老的方法之一,虽然现在已经不具有实用性,但是许多有效算法都是以它为基础进行改进和修正而得到的.最速下降法是用 ...
- (二)深入梯度下降(Gradient Descent)算法
一直以来都以为自己对一些算法已经理解了,直到最近才发现,梯度下降都理解的不好. 1 问题的引出 对于上篇中讲到的线性回归,先化一个为一个特征θ1,θ0为偏置项,最后列出的误差函数如下图所示: 手动求解 ...
- CS229 2.深入梯度下降(Gradient Descent)算法
1 问题的引出 对于上篇中讲到的线性回归,先化一个为一个特征θ1,θ0为偏置项,最后列出的误差函数如下图所示: 手动求解 目标是优化J(θ1),得到其最小化,下图中的×为y(i),下面给出TrainS ...
- 梯度下降(Gradient descent)
首先,我们继续上一篇文章中的例子,在这里我们增加一个特征,也即卧室数量,如下表格所示: 因为在上一篇中引入了一些符号,所以这里再次补充说明一下: x‘s:在这里是一个二维的向量,例如:x1(i)第i间 ...
- 机器学习中的数学(1)-回归(regression)、梯度下降(gradient descent)
版权声明: 本文由LeftNotEasy所有,发布于http://leftnoteasy.cnblogs.com.如果转载,请注明出处,在未经作者同意下将本文用于商业用途,将追究其法律责任. 前言: ...
- 回归(regression)、梯度下降(gradient descent)
本文由LeftNotEasy所有,发布于http://leftnoteasy.cnblogs.com.如果转载,请注明出处,在未经作者同意下将本文用于商业用途,将追究其法律责任. 前言: 上次写过一篇 ...
- 吴恩达深度学习:2.3梯度下降Gradient Descent
1.用梯度下降算法来训练或者学习训练集上的参数w和b,如下所示,第一行是logistic回归算法,第二行是成本函数J,它被定义为1/m的损失函数之和,损失函数可以衡量你的算法的效果,每一个训练样例都输 ...
- (3)梯度下降法Gradient Descent
梯度下降法 不是一个机器学习算法 是一种基于搜索的最优化方法 作用:最小化一个损失函数 梯度上升法:最大化一个效用函数 举个栗子 直线方程:导数代表斜率 曲线方程:导数代表切线斜率 导数可以代表方向, ...
随机推荐
- lapis 1.7.0 更好的openresty 版本兼容以及安全数据库支持
lapis 1.7.0 今年4月2号就发布了,一直没有注意,今天看到changelog就简单的进行了一个 测试(主要是与openresty版本的测试,新变更后边会有) 使用docker-compose ...
- tomcat源码阅读之BackupManager
一. 配置: <Cluster className="org.apache.catalina.ha.tcp.SimpleTcpCluster" channelSendOpti ...
- js 去除字符串第一位逗号的方法
<script type="text/javascript"> var s=',123456'; if (s.substr(0,1)==',') s=s.substr( ...
- ELK入门以及常见指令
ES的资源: https://www.elastic.co/guide/en/elasticsearch/reference/current/getting-started.htmlhttps://w ...
- NET设计模式 第二部分 创建型模式(5):原型模式(Prototype Pattern)
原型模式(Prototype Pattern) ——.NET设计模式系列之六 Terrylee,2006年1月 概述 在软件系统中,有时候面临的产品类是动态变化的,而且这个产品类具有一定的等级结构.这 ...
- JAVAFX 2.0 javascript中调用java代码
现在你已经知道如何在JavaFX中调用JavaScript.在本章中,你将了解到相反的功能——在web页面中调用JavaFX. 大体上的理念是在JavaFX程序中创建一个接口对象,并通过调用JSObj ...
- KC705开发板关于MIG的配置
KC705开发板关于MIG的配置
- 创建virtualenv虚拟环境
这个部分知识我在之前的随笔里记过笔记. 传送门:http://www.cnblogs.com/0bug/p/8598458.html 本文只演示Windos下virtualenv环境的使用: 首先,确 ...
- CheckFail设计很垃圾
function checkFail(node, onError, fuckIE) { var id = node.src;//检测是否死链 node.onlo ...
- windebug 与 office Home
https://officecdn.microsoft.com/sg/492350f6-3a01-4f97-b9c0-c7c6ddf67d60/media/zh-CN/HomeStudentRetai ...