
Hadoop2.8 安装
一、下载Hadoop与java
jdk-8u221-linux-x64.tar.gz Oracle官网下载
hadoop-2.8.5.tar.gz Hadoop官网下载
二、配置服务期间ssh免密互通
使用如下互信安装脚本
https://www.cnblogs.com/xibuhaohao/p/11772047.html
三、配置服务期间时钟同步服务
略
四、解压安装Hadoop文件与Java
1、解压缩(每个结点都要做)
1)安装Java
2)安装Hadoop
新建Hadoop用户
2、配置结点环境变量
cat .bash_profile
添加如下:
export CLASSPATH=.:$JAVA_HOME/jre/lib/rt.jar:$JAVA_HOME/lib/dt.jar:$JAVA_HOME/lib/tools.jar
export PATH=$JAVA_HOME/jre/bin:$PATH
export PATH=$PATH:$JAVA_HOME/bin:$HADOOP_HOME/bin
五、修改配置文件
cd /home/hadoop/hadoop-2.8.5/etc/hadoop
1、core-site.xml
<property>
<name>fs.defaultFS</name>
<value>hdfs://data0:9000</value>
</property>
<property>
<name>io.file.buffer.size</name>
<value>4096</value>
</property>
<!-- 配置临时数据存储目录 -->
<property>
<name>hadoop.tmp.dir</name>
<value>/home/hadoop/hadoop-2.8.5/tmp</value>
</property>
2、hdfs-site.xml
<property>
<name>dfs.replication</name>
<value>3</value>
</property>
<!--hdfs的元数据存储位置-->
<property>
<name>dfs.namenode.name.dir</name>
<value>/home/hadoop/hadoop-2.8.5/hdfs/name</value>
</property>
<!--hdfs的数据存储位置-->
<property>
<name>dfs.datanode.data.dir</name>
<value>/home/hadoop/hadoop-2.8.5/hdfs/data</value>
</property>
<!--hdfs的namenode的web ui 地址-->
<property>
<name>dfs.http.address</name>
<value>data0:50070</value>
</property>
<!--hdfs的snn的web ui 地址-->
<!-- <property>
<name>dfs.secondary.http.address</name>
<value>data0:50090</value>
</property>
<!--是否开启web操作hdfs-->
<property>
<name>dfs.webhdfs.enabled</name>
<value>true</value>
</property>
<!--是否启用hdfs权限(acl)-->
<property>
<name>dfs.permissions</name>
<value>false</value>
</property>
</configuration>
3、mapred-site.xml
<property>
<name>mapreduce.framework.name</name>
<value>yarn</value> </property>
<!--历史服务的通信地址-->
<property>
<name>mapreduce.jobhistory.address</name>
<value>data0:10020</value>
</property>
<!--历史服务的web ui地址-->
<property>
<name>mapreduce.jobhistory.webapp.address</name>
<value>data0:19888</value>
</property>
4、yarn-site.xml
<property>
<name>yarn.resourcemanager.hostname</name>
<value>data0</value>
</property>
<!--指定mapreduce的shuffle-->
<property>
<name>yarn.nodemanager.aux-services</name>
<value>mapreduce_shuffle</value>
</property>
<!--指定resourcemanager的内部通讯地址-->
<property>
<name>yarn.resourcemanager.address</name>
<value>data0:8032</value>
</property>
<!--指定scheduler的内部通讯地址-->
<property>
<name>yarn.resourcemanager.scheduler.address</name>
<value>data0:8030</value>
</property>
<!--指定resource-tracker的内部通讯地址-->
<property>
<name>yarn.resourcemanager.resource-tracker.address</name>
<value>data0:8031</value>
</property>
<!--指定resourcemanager.admin的内部通讯地址-->
<property>
<name>yarn.resourcemanager.admin.address</name>
<value>data0:8033</value>
</property>
<!--指定resourcemanager.webapp的ui监控地址-->
<property>
<name>yarn.resourcemanager.webapp.address</name>
<value>data0:8088</value>
</property>
六、启动Hadoop
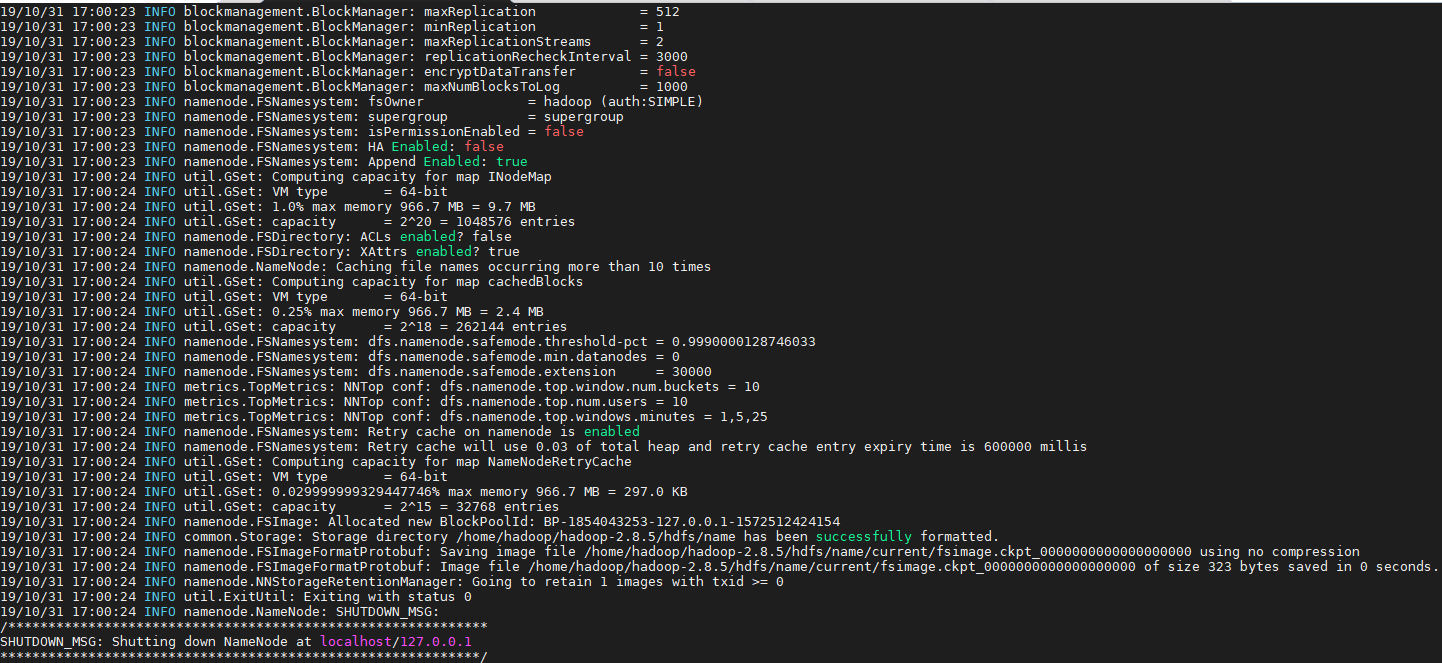
1、初始化Namenode
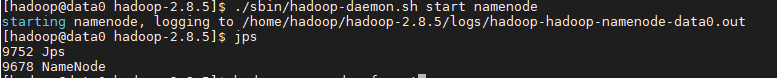
2、开启namenode
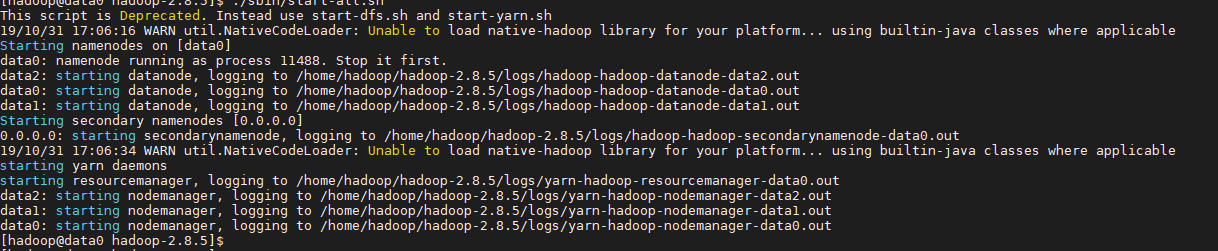
3、启动集群
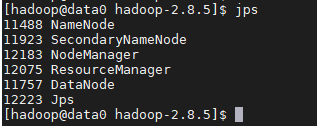
4、查看集群个资源是否启动
2)datanode1
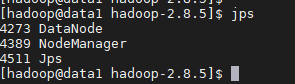
3)datanode2

七、网页登录
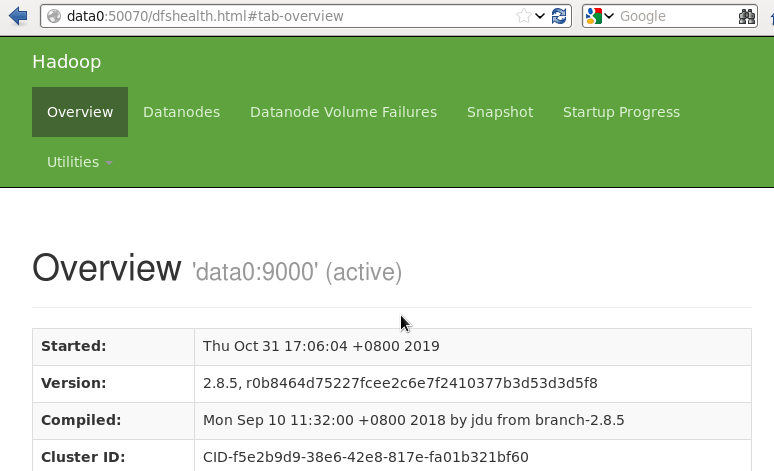
1、namenode
data0:50070
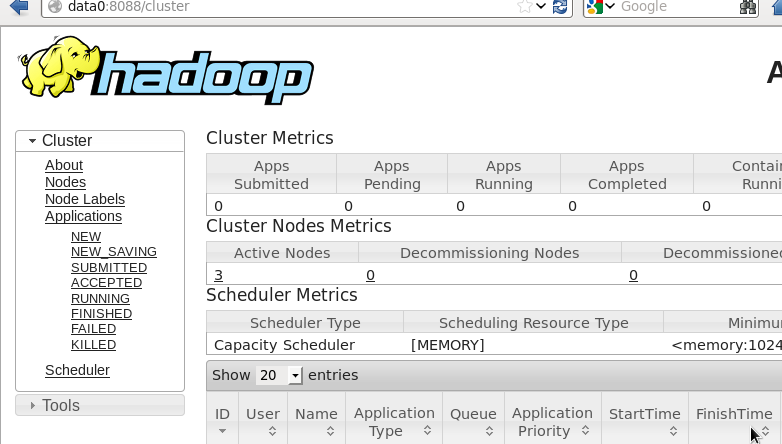
2、Hadoop
data0:8088
Hadoop2.8 安装的更多相关文章
- 跟我一起hadoop(1)-hadoop2.6安装与使用
伪分布式 hadoop的三种安装方式: Local (Standalone) Mode Pseudo-Distributed Mode Fully-Distributed Mode 安装之前需要 $ ...
- 完全分布式Hadoop2.3安装与配置
一.Hadoop基本介绍 Hadoop优点 1.高可靠性:Hadoop按位存储和处理数据 2.高扩展性:Hadoop是在计算机集群中完成计算任务,这个集群可以方便的扩展到几千台 3.高效性:Hadoo ...
- hadoop-2.5安装与配置
安装之前准备4台机器:bluejoe0,bluejoe4,bluejoe5,bluejoe9 bluejoe0作为master,bluejoe4,5,9作为slave bluejoe0作为nameno ...
- hadoop2.x 安装配置
hadoop2.x在系统架构上与hadoop1.x有很大的变化 原文地址: http://www.ibm.com/developerworks/cn/opensource/os-cn-hadoop-y ...
- CentOS7.4 + Hadoop2.9安装配置管理(分布式)
1. 规划 1.1. 机器列表 NameNode SecondaryNameNode DataNodes 192.168.1.121 192.168.1.122 192.168.1.101 192 ...
- Hadoop2.6 安装布置问题总结(单机、分布式)
在debian7虚拟机上安装hadoop2.6,期间遇到一些问题在此记录一下. 安装参考: Hadoop安装教程_单机/伪分布式配置_Hadoop2.6.0/Ubuntu14.04 Hadoop集群安 ...
- centos6.5系统hadoop2.7安装sqoop
一.sqoop简介 Sqoop是一款开源的工具,主要用于在Hadoop(Hive)与传统的数据库(mysql.postgresql...)间进行数据的传递,可以将一个关系型数据库(例如 : MySQL ...
- hadoop2.3安装过程及问题解决
三台serveryiprod01,02,03,当中01为namenode,02为secondarynamenode.3个均为datanode 3台server的这里提到的配置均需一样. 0.安装前提条 ...
- hadoop2.x安装配置
1.首先准备hadoop2.2.0的安装包,从官网获取,略. 2.加压安装包,进行配置.假设hadoop安装到/usr/hadoop-2.2.0目录,则进行如下配置: (1)/etc/profile配 ...
- Hadoop2.0安装之非HA版
主要步骤跟Hadoop1.0(1.0安装地址)一致,主要在配置这块有更改 安装 下载地址:http://archive.apache.org/dist/hadoop/core/hadoop-2.6.5 ...
随机推荐
- pt-archiver 归档历史数据及参数详解
目录 1. 背景 2. 操作步骤 2.1. 确认数据归档条件,此次操作开发按照非主键列 server_time 按时间进行删除并保存,需要转化为主键列条件. 2.2. 由于历史表文件较大,按月归档.删 ...
- Python基础 — eval 函数的作用
eval函数就是实现list.dict.tuple与str之间的相互转化str函数把list,dict,tuple转为为字符串 # 字符串转换成列表a = "[[1,2], [3,4], [ ...
- 38 多线程(十)——volatile 数据同步
在多线程并发的情况下,同一个变量被多个线程调用,那修改的数据就不会每分每秒保持一致.例如,对于某个变量a,线程1对它进行一套操作,线程2又对它进行另一套操作,但如果cpu太忙了,太忙了,假设cpu都用 ...
- Find the median(线段树+离散化)(2019牛客暑期多校训练营(第七场))
题目出处:Find the median 示例: 输入: 53 1 4 1 5 92 7 1 8 2 9 输出:3 4 5 4 5 说明:L = [3, 2 ,4, 1, 7],R = [4, 8, ...
- Linux 打包和压缩
常用的打包压缩方式 windows常用rar mac常用zip linux常用tar.gz 打包/解包 tar是linux中最常用的备份工具,此命令可以把一系列的文件打包到一个大文件中,也可以把一个打 ...
- 路由Routers
路由Routers 对于视图集ViewSet,我们除了可以自己手动指明请求方式与动作action之间的对应关系外,还可以使用Routers来帮助我们快速实现路由信息. REST framework提供 ...
- REST-framework之频率组件
REST-framework之频率控制 一 频率简介 为了控制用户对某个url请求的频率,比如,一分钟以内,只能访问三次 二 自定义频率类,自定义频率规则 自定义的逻辑 ""&qu ...
- Linux中添加用户与删除用户
注意:添加用户和删除用户需要root来执行. 添加用户 用useradd命令,例如: # useradd -d/home/tom -s/bin/bash -u1000 tom 这样就添加了新用户to ...
- kubernetes第二章--集群搭建
- dubbo源码阅读之负载均衡
负载均衡 在之前集群的文章中,我们分析了通过监听注册中心可以获取到多个服务提供者,并创建多个Invoker,然后通过集群类如FailoverClusterInvoker将多个Invoker封装在一起, ...