
吴恩达深度学习笔记(deeplearning.ai)之循环神经网络(RNN)(三)
1. 导读
本节内容介绍普通RNN的弊端,从而引入各种变体RNN,主要讲述GRU与LSTM的工作原理。
事先声明,本人采用ng在课堂上所使用的符号系统,与某些学术文献上的命名有所不同,不过核心思想都是相同的。
2. 普通RNN的弊端
- 在NLP中,句子内部以及句子之间可能存在很长的依赖关系(long-term dependecies),最前边的单词对句子后面的单词产生影响。但是普通RNN不擅长捕获这种长期依赖关系。因为RNN相当于很深的权重共享的神经网络,因此在反向传播的过程中存在很严重的梯度消失现象,损失函数得到的输出误差很难影响到前面层的计算。
对于深度神经网络,不光存在梯度消失,也存在梯度爆炸的现象,以至于网络参数崩溃(当参数梯度指数级增长时,你会看到很多参数值为NaN,这意味着网络发生了数值溢出)。普通RNN也是如此,但是相比于梯度消失,梯度爆炸比较容易解决,可以采用梯度修剪(gradient clipping)的处理方法。
梯度修剪,指当梯度向量大于某个阈值时,re-scale梯度向量,保证它不会数值爆炸。
3. GRU
3.1 简化GRU(便于理解)
与普通RNN相比,GRU添加了门控单元,改变了RNN的隐藏层,使得其能更好捕获长距离依赖关系,并且有效解决了梯度消失问题。下面对GRU进行详细的介绍:
- 在GRU中,人们引入了新的概念,memory cell,用符号\(c\)来表示,其提供了记忆能力。比如在英文句子中,网络能够记住前文的主语是单数还是复数,因此当网络看到之后的动词,仍然可以联想到前文的主语 。
- 在GRU中,\(t\)时刻有\(c^{<t>}=a^{<t>}\),\(a^{<t>}\)是t时刻的激活值。尽管这两个值相同,我们仍然用两个不同的符号来表示,因为其分别是记忆细胞的值与输出的激活值,在LSTM中二者并不相同。 在每个时间戳,我们将用一个候选值\(\tilde{c}^{<t>}\)重写记忆细胞,每一时刻都对其进行更新。
- 在每个时间戳\(t\)中,需要用上一时刻的记忆细胞\(c^{<t-1>}\),以及当前时刻的候选值\(\tilde{c}^{<t>}\),来更新当前时刻的记忆细胞\(c^{<t>}\)。
- GRU最重要的思想是让我们拥有了一个叫做\(\gamma_u\)(下标\(u\)代表更新门 )的门,该值位于0到1之间,该门用来决定,在每个时刻该如何更新记忆细胞的值。
以下是简化GRU的计算公式:
\[\tilde{c}^{<t>}=tanh(W_c[c^{<t-1>},x^{<t>}]+b_c)\]
\[\gamma_u = \sigma (W_u[c^{<t-1>},x^{<t>}]+b_u)\]
\[c^{<t>}=\gamma_u * \tilde{c}^{<t>} + (1-\gamma_u) * c^{<t-1>}\]
\[a^{<t>} = c^{<t>}\]
GRU实现细节:
- \(c^{<t>}\)、\(\tilde{c}^{<t>}\)、\(\gamma_u\)是具有相同维度的向量,因此在更新\(c^{<t>}\)时,\(\gamma_u * \tilde{c}^{<t>}\)中的\(*\)代表向量间的点乘操作。
3.2 Full GRU (完整版本)
通过上文的介绍,相信你已经对GRU有了简单的理解,出于入门的考虑,上述GRU并不完整,这里将介绍其余下的部分。
以下是完整GRU的计算公式:
\[\tilde{c}^{<t>}=tanh(W_c[\gamma_r * c^{<t-1>},x^{<t>}]+b_c)\]
\[\gamma_u = \sigma (W_u[c^{<t-1>},x^{<t>}]+b_u)\]
\[\gamma_r = \sigma (W_r[c^{<t-1>},x^{<t>}]+b_r)\]
\[c^{<t>}=\gamma_u * \tilde{c}^{<t>} + (1-\gamma_u) * c^{<t-1>}\]
\[a^{<t>} = c^{<t>}\]
这里引入了另一个门\(\gamma_r\)——the relevance gate。
ng在课上讲,可以认为r代表相关性,\(\gamma_r\)门告诉你计算出的\(\tilde{c}^{<t>}\)与\(c^{<t-1>}\)有多大的相关性。
我对GRU中“门”这一概念的理解如下:
- 无论是\(\gamma_u\),还是\(\gamma_r\),其本质都是一个线性函数通过激活函数(sigmoid)得到的激活值,而该线性函数是以\(x^{<t>}\),\(c^{<t-1>}\)作为输入。
- 也就是说,每个门的向量值是由\(x^{<t>}\),\(c^{<t-1>}\)这两个值以及线性函数的权重、偏置计算得到的。
- 反向传播通过梯度下降改变线性函数的参数来改变门的向量值。
4. LSTM
LSTM存在很多变体,这里介绍经典LSTM。
4.1 经典LSTM
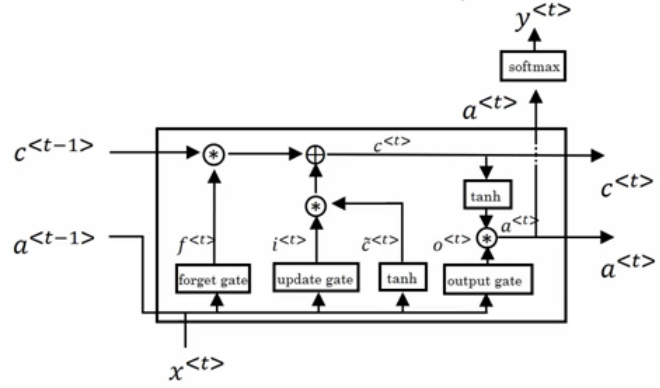
LSTM的计算公式如下所示(\(a^{<t>}\)指时刻t的隐状态):
\[\tilde{c}^{<t>}=tanh(W_c[a^{<t-1>},x^{<t>}]+b_c)\]
\[\gamma_u = \sigma (W_u[a^{<t-1>},x^{<t>}]+b_u)\]
\[\gamma_f = \sigma (W_f[a^{<t-1>},x^{<t>}]+b_f)\]
\[\gamma_o = \sigma (W_o[a^{<t-1>},x^{<t>}]+b_o)\]
\[c^{<t>}=\gamma_u * \tilde{c}^{<t>} + \gamma_f * c^{<t-1>}\]
\[a^{<t>} = \gamma_o * tanh(c^{<t>})\]
LSTM与GRU的区别:
- LSTM中有三个门,分别是更新门\(\gamma_u\),遗忘门\(\gamma_f\),输出门\(\gamma_o\)。
- LSTM中使用遗忘门\(\gamm_f\),来代替GRU中的系数\((1-\gamma_u)\),这样是的模型更加完备,但是也引入更多的学习参数。
- LSTM的三个门,实际上是线性函数的激活值(sigmoid),而线性函数的输入是\(a^{t-1}\),\(x^{<t>}\)。
有些论文提到了peephole connection这一概念,其目的是为了LSTM在计算门值的时候能够获得上一时刻\(c^{<t-1>}\)的信息,即将线性函数的输入扩增为\(a^{t-1}\),\(x^{<t>}\),\(c^{<t-1>}\)。
\(c^{<t-1>}\)与\(\gamma_u\)、\(\gamma_f\)、\(\gamma_o\)是维度相同的向量。\(c^{<t-1>}\)的每个维度,与三个门的每个维度一一对应,\(c^{<t-1>}\)中每个维度的数值只会影响到三个门中对应维度的数值。
吴恩达深度学习笔记(deeplearning.ai)之循环神经网络(RNN)(三)的更多相关文章
- 【Deeplearning.ai 】吴恩达深度学习笔记及课后作业目录
吴恩达深度学习课程的课堂笔记以及课后作业 代码下载:https://github.com/douzujun/Deep-Learning-Coursera 吴恩达推荐笔记:https://mp.weix ...
- 吴恩达深度学习笔记(deeplearning.ai)之卷积神经网络(CNN)(上)
作者:szx_spark 1. Padding 在卷积操作中,过滤器(又称核)的大小通常为奇数,如3x3,5x5.这样的好处有两点: 在特征图(二维卷积)中就会存在一个中心像素点.有一个中心像素点会十 ...
- 吴恩达深度学习笔记(deeplearning.ai)之卷积神经网络(二)
经典网络 LeNet-5 AlexNet VGG Ng介绍了上述三个在计算机视觉中的经典网络.网络深度逐渐增加,训练的参数数量也骤增.AlexNet大约6000万参数,VGG大约上亿参数. 从中我们可 ...
- 吴恩达深度学习笔记(deeplearning.ai)之卷积神经网络(一)
Padding 在卷积操作中,过滤器(又称核)的大小通常为奇数,如3x3,5x5.这样的好处有两点: 在特征图(二维卷积)中就会存在一个中心像素点.有一个中心像素点会十分方便,便于指出过滤器的位置. ...
- 吴恩达深度学习笔记(八) —— ResNets残差网络
(很好的博客:残差网络ResNet笔记) 主要内容: 一.深层神经网络的优点和缺陷 二.残差网络的引入 三.残差网络的可行性 四.identity block 和 convolutional bloc ...
- 吴恩达深度学习笔记(十二)—— Batch Normalization
主要内容: 一.Normalizing activations in a network 二.Fitting Batch Norm in a neural network 三.Why does ...
- 吴恩达深度学习笔记(七) —— Batch Normalization
主要内容: 一.Batch Norm简介 二.归一化网络的激活函数 三.Batch Norm拟合进神经网络 四.测试时的Batch Norm 一.Batch Norm简介 1.在机器学习中,我们一般会 ...
- 吴恩达深度学习笔记1-神经网络的编程基础(Basics of Neural Network programming)
一:二分类(Binary Classification) 逻辑回归是一个用于二分类(binary classification)的算法.在二分类问题中,我们的目标就是习得一个分类器,它以对象的特征向量 ...
- 吴恩达深度学习笔记(十一)—— dropout正则化
主要内容: 一.dropout正则化的思想 二.dropout算法流程 三.dropout的优缺点 一.dropout正则化的思想 在神经网络中,dropout是一种“玄学”的正则化方法,以减少过拟合 ...
随机推荐
- ZooKeeper(六)-- CAP和BASE理论、ZAB协议
一.CAP理论和BASE理论 1.CAP理论 CAP理论,指的是在一个分布式系统中,不可能同时满足Consistency(一致性). Availability(可用性).Partition toler ...
- cocos2d-x游戏引擎核心之一——坐标系
cocos2d-x:OpenGL坐标系.绝对坐标系.相对坐标系.屏幕坐标系 cocos2d-x采用的是笛卡尔平面坐标系,也就是平面上两条垂直线构成的坐标系,平面上任意一点都可以用(x,y)来表示. ( ...
- 在SQL数据库中怎么去掉某一列的中的一写特殊字符
用REPLACE函数,把空格替换成 ''. 例:去除 表table 中 col 列的空字符去除空格符:update table set col = REPLACE(col,' ','') 还有tab制 ...
- 【PHP】使用openssl进行Rsa长数据加密(117)解密(128)
PHP使用openssl进行Rsa加密,如果要加密的明文太长则会出错,解决方法:加密的时候117个字符加密一次,然后把所有的密文拼接成一个密文:解密的时候需要128个字符解密一下,然后拼接成数据. 加 ...
- MongoDB复制集原理
版权声明:本文由孔德雨原创文章,转载请注明出处: 文章原文链接:https://www.qcloud.com/community/article/136 来源:腾云阁 https://www.qclo ...
- setTimeout/setInterval伪异步
setTimeout(function(){alert(1);}, 1000); 在使用setTimeout.setInterval的时候,会传一个时间来控制代码的执行时机.在经过了设置的时间段后,代 ...
- java如何重命名文件?
/** * 修改文件名 * @param oldFilePath 原文件路径 * @param newFileName 新文件名称 * @param overriding 判断标志(如果存在相同名的文 ...
- mysql格式化日期的函数
转自:https://www.cnblogs.com/duhuo/p/5650876.html mysql格式化日期 mysql查询记录如果有时间戳字段时,查看结果不方便,不能即时看到时间戳代表的 ...
- 模拟退火算法A Star not a Tree?(poj2420)
http://write.blog.csdn.net/postedit A Star not a Tree? Time Limit: 1000MS Memory Limit: 65536K Tot ...
- HDU Humble Numbers
Problem Description A number whose only prime factors are 2,3,5 or 7 is called a humble number. The ...