
postgres SQL编译过程
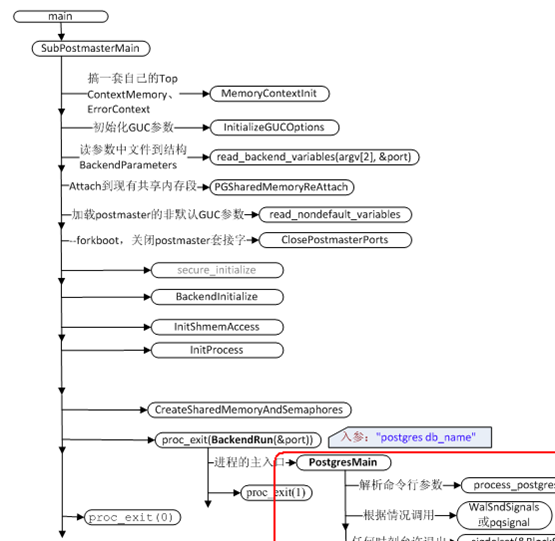

PG启动首先完成主进程和后台进程的启动,启动时完成数据库文件的打开,共享内存的建立等。接着,所有SQL都会启动1个单独的进程处理SQL的执行过程。
新的进程首先是进行自身的初始化,最主要的是初始化内存上下文,准备好SQL处理过程。
进入PostgresMain后,解析客户端命令行参数dbname;做文件、存储、缓存的初始化;设置合适的信号处理句柄;调用InitPostgres方法给portgres服务进程做相关初始化,这个方法里初始化了relcache和catcache,初始化了执行查询计划的portal的管理器,填充本进程PGPROC结构相关部分成员等。进入无限循环,检查并处理任何请求或者最近收到的信号。然后再接着循环。
循环一直在ReadCommand。 进入无限循环后,切换到内存上下文"MessageContext"并清理干净该内存上下文;读取客户端命令;根据客户端各种命令分别进行处理。

客户端发起请求,pg服务器为该请求启动一个postgres访问进程为该客户端通过访问,建立了连接。这个postgres访问进程进入无限循环,等待客户端请求并为其通过服务,直到进程终止,连接断口。
当客户端给服务器端发出查询SQL后,建立连接时已经启动且进入无限循环的服务器端的postgres服务进程处理步骤如下:
(1)调用MemoryContextSwitchTo切换内存上下文到"MessageContext"。
(2)调用MemoryContextResetAndDeleteChildren清理上次为相同连接服务时"MessageContext"内存上下文里遗留的对象。
(3)调用ReadCommand读取客户端的请求。
(4)根据客户端请求判断要提供何种服务,进入相应分支。
从源码的角度分析sql编译过程:
对于一个简单SQL查询,主要的处理过程是先调用start_xact_command方法开启一个事务,再用pg_parse_query方法用词法语法解析工具把查询命令解析为解析树parsetree,根据需要调用PushActiveSnapshot方法搞一个快照,调用pg_analyze_and_rewrite方法分析、根据规则重写解析树为查询树querytree,调用pg_plan_queries方法把查询树转换到执行计划树plantree,在调用相应方法创建portal和在postal中执行执行计划树并给客户端发回结果。然后退出当前事务,清理内存。
src/backend/parser下,scan.l为词法定义,gram.y为语法定义。
postgres SQL编译过程的更多相关文章
- Hive SQL 编译过程
转自:http://www.open-open.com/lib/view/open1400644430159.html Hive跟Impala貌似都是公司或者研究所常用的系统,前者更稳定点,实现方式是 ...
- Hive SQL编译过程(转)
转自:https://www.cnblogs.com/zhzhang/p/5691997.html Hive是基于Hadoop的一个数据仓库系统,在各大公司都有广泛的应用.美团数据仓库也是基于Hive ...
- 【转】Hive SQL的编译过程
Hive是基于Hadoop的一个数据仓库系统,在各大公司都有广泛的应用.美团数据仓库也是基于Hive搭建,每天执行近万次的Hive ETL计算流程,负责每天数百GB的数据存储和分析.Hive的稳定性和 ...
- Hive SQL的编译过程
文章转自:http://tech.meituan.com/hive-sql-to-mapreduce.html Hive是基于Hadoop的一个数据仓库系统,在各大公司都有广泛的应用.美团数据仓库也是 ...
- 转:Hive SQL的编译过程
Hive是基于Hadoop的一个数据仓库系统,在各大公司都有广泛的应用.美团数据仓库也是基于Hive搭建,每天执行近万次的Hive ETL计算流程,负责每天数百GB的数据存储和分析.Hive的稳定性和 ...
- Hive SQL的编译过程[转载自https://tech.meituan.com/hive-sql-to-mapreduce.html]
https://tech.meituan.com/hive-sql-to-mapreduce.html Hive是基于Hadoop的一个数据仓库系统,在各大公司都有广泛的应用.美团数据仓库也是基于Hi ...
- Hive SQL的底层编译过程详解
本文结构采用宏观着眼,微观入手,从整体到细节的方式剖析 Hive SQL 底层原理.第一节先介绍 Hive 底层的整体执行流程,然后第二节介绍执行流程中的 SQL 编译成 MapReduce 的过程, ...
- 对MySql查询缓存及SQL Server过程缓存的理解及总结
一.MySql的Query Cache 1.Query Cache MySQL Query Cache是用来缓存我们所执行的SELECT语句以及该语句的结果集.MySql在实现Query Cache的 ...
- Spark源码的编译过程详细解读(各版本)
说在前面的话 重新试多几次.编译过程中会出现下载某个包的时间太久,这是由于连接网站的过程中会出现假死,按ctrl+c,重新运行编译命令. 如果出现缺少了某个文件的情况,则要先清理maven(使用命 ...
随机推荐
- python之动态参数 *args,**kwargs(聚合,打散)
一.函数的动态参数 *args,**kwargs, 形参的顺序1.你的函数,为了拓展,对于传入的实参数量应该是不固定,所以就需要用到万能参数,动态参数,*args, **kwargs 1,*args ...
- 修复Centos7双系统引导
1.进入CentOS系统 2.命令行输入 vi /boot/grub2/grub.cfg 3.在文件空白处添加下列代码 menuentry 'Windows 7'{ insmod part_msdos ...
- Java日志实战及解析
Java日志实战及解析 日志是程序员必须掌握的基础技能之一,如果您写的软件没有日志,可以说你没有成为一个真正意义上的程序员. 为什么要记日志? • 监控代码 • 变量变化情况, ...
- RHEL7网卡命名规则
systemd 和 udev 引入了一种新的网络设备命名方式:一致网络设备命名(CONSISTENT NETWORK DEVICE NAMING).根据固件.拓扑.位置信息来设置固定名字,带来的好处是 ...
- Android隐藏软键盘收回软键盘
代码改变世界 Android隐藏软键盘收回软键盘 InputMethodManager imm = (InputMethodManager) getSystemService(Context.INPU ...
- 【Luogu】P1948电话线(二分SPFA)
题目链接 二分最长的电话线长度.把所有大于这个长度的边权设成1,小于等于的设成零,然后跑SPFA看dis[n]是否>k.若>k则l=mid+1 否则r=mid-1 放代码 #include ...
- 【Luogu】P3387缩点(Tarjan缩点+深搜DP)
题没什么好说的,因为是模板题.求值我用的是dfs. 不能直接在原图上dfs,因为原图上有环的话会发生一些滑稽的事情.所以我们要用Tarjan缩点.因为此题点权全为正,所以如果在图上走一个环当然可以全走 ...
- UOJ 274 【清华集训2016】温暖会指引我们前行 ——Link-Cut Tree
魔法森林高清重置, 只需要维护关于t的最大生成树,然后链上边权求和即可. 直接上LCT 调了将近2h 吃枣药丸 #include <cstdio> #include <cstring ...
- 【2017.12.18】Dijkstra专题
先友情提示一下,作者很早就会这个算法了,只不过这么久以来没怎么写过博客.现在正在学习它的拓展,干脆就把这个算法相关的内容整个敲一遍吧!本章把迪杰斯特拉从基础到拓展全都说一遍咯. 下面是优先队列(堆)优 ...
- FreeMarker数据模板引擎全面教程mark
http://blog.csdn.net/fhx007/article/details/7902040/#comments 以下内容全部是网上收集: FreeMarker的模板文件并不比HTML页面复 ...