
强化学习--DeepQnetwork 的一些改进
Double DQN
算Q值 与选Q值是分开的,2个网络。

Multi-step

Dueling DQN

如果更新了,即使有的action没有被采样到,也会更新Q值

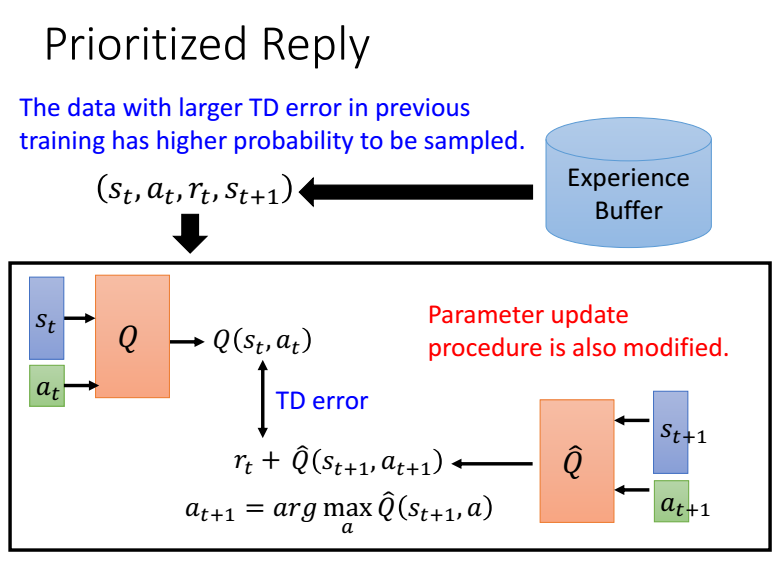
Prioritized Reply
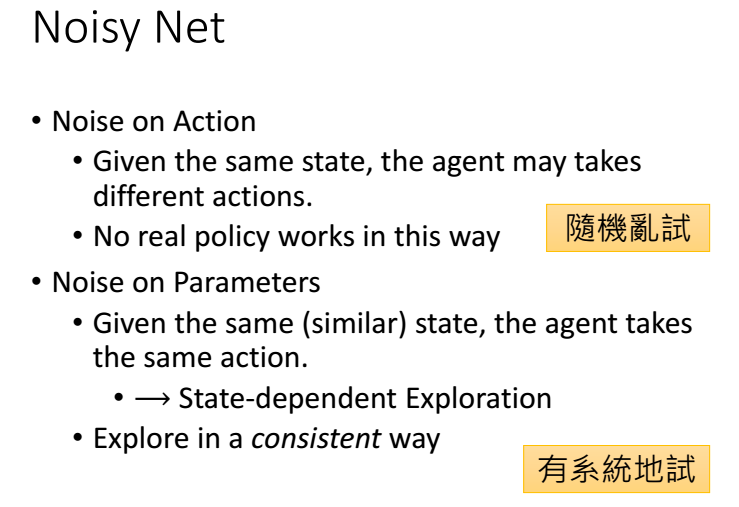
Noisy Net
Epsilon Greedy 存在的问题是在一局游戏中,
即使是同一个agent也有可能坐车不不同的选择,这是不合理的,
所以在一局游戏中, 我们使用同一个q网络,在不回的回合给q网络
加入noise保证探索性。

强化学习--DeepQnetwork 的一些改进的更多相关文章
- 【强化学习】DQN 算法改进
DQN 算法改进 (一)Dueling DQN Dueling DQN 是一种基于 DQN 的改进算法.主要突破点:利用模型结构将值函数表示成更加细致的形式,这使得模型能够拥有更好的表现.下面给出公式 ...
- 【转】强化学习(一)Deep Q-Network
原文地址:https://www.hhyz.me/2018/08/05/2018-08-05-RL/ 1. 前言 虽然将深度学习和增强学习结合的想法在几年前就有人尝试,但真正成功的开端就是DeepMi ...
- 【整理】强化学习与MDP
[入门,来自wiki] 强化学习是机器学习中的一个领域,强调如何基于环境而行动,以取得最大化的预期利益.其灵感来源于心理学中的行为主义理论,即有机体如何在环境给予的奖励或惩罚的刺激下,逐步形成对刺激的 ...
- 强化学习之 免模型学习(model-free based learning)
强化学习之 免模型学习(model-free based learning) ------ 蒙特卡罗强化学习 与 时序查分学习 ------ 部分节选自周志华老师的教材<机器学习> 由于现 ...
- 强化学习(十九) AlphaGo Zero强化学习原理
在强化学习(十八) 基于模拟的搜索与蒙特卡罗树搜索(MCTS)中,我们讨论了MCTS的原理和在棋类中的基本应用.这里我们在前一节MCTS的基础上,讨论下DeepMind的AlphaGo Zero强化学 ...
- 强化学习(十六) 深度确定性策略梯度(DDPG)
在强化学习(十五) A3C中,我们讨论了使用多线程的方法来解决Actor-Critic难收敛的问题,今天我们不使用多线程,而是使用和DDQN类似的方法:即经验回放和双网络的方法来改进Actor-Cri ...
- 强化学习(十四) Actor-Critic
在强化学习(十三) 策略梯度(Policy Gradient)中,我们讲到了基于策略(Policy Based)的强化学习方法的基本思路,并讨论了蒙特卡罗策略梯度reinforce算法.但是由于该算法 ...
- 强化学习(十三) 策略梯度(Policy Gradient)
在前面讲到的DQN系列强化学习算法中,我们主要对价值函数进行了近似表示,基于价值来学习.这种Value Based强化学习方法在很多领域都得到比较好的应用,但是Value Based强化学习方法也有很 ...
- 强化学习(十二) Dueling DQN
在强化学习(十一) Prioritized Replay DQN中,我们讨论了对DQN的经验回放池按权重采样来优化DQN算法的方法,本文讨论另一种优化方法,Dueling DQN.本章内容主要参考了I ...
随机推荐
- sparking water
1 2 It provides a way to initialize H2O services on each node in the Spark cluster and to access dat ...
- linux查内存操作:cat /proc/meminfo
https://www.cnblogs.com/zhuiluoyu/p/6154898.html cat /proc/meminfo
- 内部排序->插入排序->直接插入排序
文字描述: 将一个记录插入到已排好序的有序表中,从而得到一个新的.记录数增1的有序表 示意图: 算法分析: 时间复杂度为n*n,辅助存储为1,是稳定的排序方法. 代码实现: #include < ...
- 抽屉之Tornado实战(1)--分析与架构
抽屉之Tornado实战(1)--分析与架构 项目模拟地址:http://dig.chouti.com/ 知识点应用: AJAX 用于偷偷发请求 原生ajax jQuery ajax($.aj ...
- 【PyQt5-Qt Designer】QSlider滑块
QSlider滑块 QSlider简介 QSlider小部件提供了一个垂直或水平滑块. 滑块是控制有界值的经典控件.它允许用户沿水平或垂直凹槽移动滑块手柄,并将手柄的位置转换为合法范围内的整数值. Q ...
- js中常用的offset client screen对象
javascript中offsetWidth.clientWidth.width.scrollWidth.clientX.screenX.offsetX.pageX offsetWidth //返回元 ...
- mimkatz 用法
mimikatz用法 privilege::debug 进入debug模式 sekurlsa::logonPasswords 查看所有用户密码 sekurlsa::wdigest 读取当前登录用 ...
- MVVM软件设计模式(转)
add by zhj: MVVM是一种软件设计模式,这里要说一下设计模式,我们通常所的设计模式是指面向对象中的设计模式,用在面向对象编程语言中.但软件设计模式是更高一个级别的设计模式,两者不是同一个东 ...
- finecms指定从第几篇文章开始调用5条记录,并调用文章所在栏目
我们在建站时可能会有具体的要求,比如从第几篇文章开始调用5篇,finecms如何实现呢?用下面一段代码就能完成:num=0,5表示从第一篇开始调用5篇,注意,0代表第一,5表示调用5篇: <a ...
- what's the python之变量、基本数据类型
what's the 变量? Python 中的变量赋值不需要类型声明. 变量在内存中创建,包括变量的标识,名称和数据. 变量在使用前都必须赋值,变量赋值以后该变量才会被创建. 等号(=)用来给变量赋 ...