
网络爬虫之html2md
前言
上周利用java爬取的网络文章,一直未能利用java实现html转化md,整整一周时间才得以解决。
虽然本人的博客文章数量不多,但是绝不齿于手动转换,毕竟手动转换浪费时间,把那些时间用来做些别的也是好的。
设计思路
Java实现
一开始的思路是想着用java来解析html,想着各种标签解析、符号解析、正则替换等等,决定在github上搜索一波,果然是有前辈实现过,顿时欣喜若狂;
下载后如下图
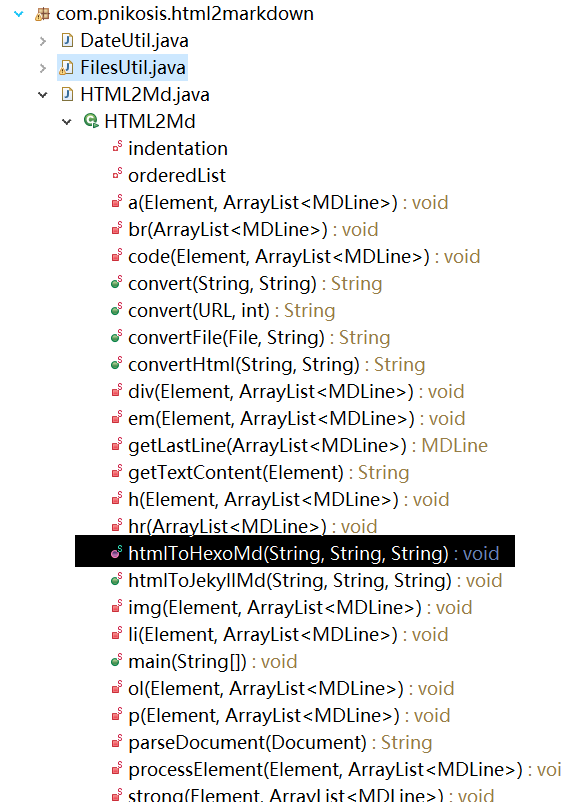
可利用htmlToHexoMd方法测试运行
可能作者是在linux服务器上定义的路径,我测试的时候一直提示路径问题,结果被迫更改转化的路径代码,
调试运行后生成的md文件,本地启动hexo服务,上传刚刚生成md文件,网页浏览,不满,弃之。
NodeJS实现
为何突然会选择NodeJS来实现,刚好最近在看node书籍,里面有提到node爬虫,解析爬取的内容,书中提到利用cheerio模块,遂果断浏览其api文档,cheerio其实就是jquery的翻版,这下可方便了,心中大喜。
实现思路
实现单个转化
自定义解析
实现批量转化
难点分析
自定义解析是比较头疼的事情,必须要分析需要转化的html的格式,需要读取的内容,本人对h1,h2,h3,div,img,a标签做了处理,可自行扩展
html解析代码如下
if('p' === name){
if(e_children.type === 'text'){
if(e.children.length > 1){
for(var j=0,c_len=e.children.length;j<c_len;j++){
if(e.children[j]['name'] === 'a') writeData = writeData + '('+e.children[j].attribs.href + ')\r\n';
else if(e.children[j]['type'] === 'text') writeData = writeData + e.children[j].data + '\r\n';
}
}else writeData = writeData + e.children[0].data + '\r\n';
}else if(e_children.name === 'img') writeData = writeData + '\r\n';
}else if('div' === name){
var codes = $('#cnblogs_post_body .cnblogs_code pre').eq(code_idx++).text();
codes = codes.replace(/^(\s*)\d+/gm, ' ');
writeData = writeData + '```bash\r\n' + codes + '\r\n```\r\n';
}else if('h1' === name) writeData = writeData + '# ' + e_children.data + '\r\n';
else if('h2' === name) writeData = writeData + '## ' + e_children.data + '\r\n';
else if('h3' === name) writeData = writeData + '### ' + e_children.data + '\r\n';
结语
完整代码请移步至本人的github,如果此文章对您有用请不吝star
网络爬虫之html2md的更多相关文章
- Python初学者之网络爬虫(二)
声明:本文内容和涉及到的代码仅限于个人学习,任何人不得作为商业用途.转载请附上此文章地址 本篇文章Python初学者之网络爬虫的继续,最新代码已提交到https://github.com/octans ...
- 网络爬虫:使用Scrapy框架编写一个抓取书籍信息的爬虫服务
上周学习了BeautifulSoup的基础知识并用它完成了一个网络爬虫( 使用Beautiful Soup编写一个爬虫 系列随笔汇总 ), BeautifulSoup是一个非常流行的Python网 ...
- 网络爬虫: 从allitebooks.com抓取书籍信息并从amazon.com抓取价格(3): 抓取amazon.com价格
通过上一篇随笔的处理,我们已经拿到了书的书名和ISBN码.(网络爬虫: 从allitebooks.com抓取书籍信息并从amazon.com抓取价格(2): 抓取allitebooks.com书籍信息 ...
- 网络爬虫: 从allitebooks.com抓取书籍信息并从amazon.com抓取价格(2): 抓取allitebooks.com书籍信息及ISBN码
这一篇首先从allitebooks.com里抓取书籍列表的书籍信息和每本书对应的ISBN码. 一.分析需求和网站结构 allitebooks.com这个网站的结构很简单,分页+书籍列表+书籍详情页. ...
- 网络爬虫: 从allitebooks.com抓取书籍信息并从amazon.com抓取价格(1): 基础知识Beautiful Soup
开始学习网络数据挖掘方面的知识,首先从Beautiful Soup入手(Beautiful Soup是一个Python库,功能是从HTML和XML中解析数据),打算以三篇博文纪录学习Beautiful ...
- Atitit.数据检索与网络爬虫与数据采集的原理概论
Atitit.数据检索与网络爬虫与数据采集的原理概论 1. 信息检索1 1.1. <信息检索导论>((美)曼宁...)[简介_书评_在线阅读] - dangdang.html1 1.2. ...
- Java 网络爬虫获取页面源代码
原博文:http://www.cnblogs.com/xudong-bupt/archive/2013/03/20/2971893.html 1.网络爬虫是一个自动提取网页的程序,它为搜索引擎从万维网 ...
- [Search Engine] 搜索引擎技术之网络爬虫
随着互联网的大力发展,互联网称为信息的主要载体,而如何在互联网中搜集信息是互联网领域面临的一大挑战.网络爬虫技术是什么?其实网络爬虫技术就是指的网络数据的抓取,因为在网络中抓取数据是具有关联性的抓取, ...
- [Python] 网络爬虫和正则表达式学习总结
以前在学校做科研都是直接利用网上共享的一些数据,就像我们经常说的dataset.beachmark等等.但是,对于实际的工业需求来说,爬取网络的数据是必须的并且是首要的.最近在国内一家互联网公司实习, ...
随机推荐
- php类自动加载
__autoload 新建一个index.php <?php $d = new z(); function __autoload($class) //自动捕获new的类名 { $file = $ ...
- 【慕课网实战】八、以慕课网日志分析为例 进入大数据 Spark SQL 的世界
用户行为日志:用户每次访问网站时所有的行为数据(访问.浏览.搜索.点击...) 用户行为轨迹.流量日志 日志数据内容: 1)访问的系统属性: 操作系统.浏览器等等 2)访问特征:点击的ur ...
- 进军微信小程序之准备工作
小程序这么火,不去浪一浪怎么行? 更何况,现在微信“赦免”了个人认证,又更新了web开发工具,现在正是搞搞小程序的最佳时期! 那么一起来看看要做什么准备吧~ 官方的文档很详细,可参考:小程序官 ...
- java实现自动生成小学四则运算——朱庭震,詹祺豪
组员:朱庭震,詹祺豪 Github地址:https://github.com/ztz1998/second/tree/master 1题目:实现一个自动生成小学四则运算题目的命令行程序. 2说明: 自 ...
- 'An instance 0x155e74a0 of class UIWebView was deallocated while key value observers were still registered with it.
在iOS和html混编的时候,当用iOS原生的navigation导航pop回去的时候,出现 *** Terminating app due to uncaught exception 'NSInte ...
- Android插件化的兼容性(下):突破Android P中灰黑名单的限制
在Android P系统中,加入了访问私有API接口的限制.
- 彻底搞懂CSS文本、空白换行问题
首先,我们来整理一下与换行有关的3个CSS属性: word-break 该属性决定文本内容超出容器时,浏览器是否自动插入换行符. 属性值: normal:默认换行规则——英文以词为单位换行,连续字符不 ...
- 简单 v.s. 基础
无论做平面设计还是做摄影创作,其基础都是一些比较粗浅的看似毫无用处的简单技能.例如画直线.拍挂在墙上的电视机,不一而足. 同样的现象还能在web的前端设计中看到.一堆类似小孩学绘画的标签,几个可以更改 ...
- EmpireCMS_V7.5的一次审计
i春秋作家:Qclover 原文来自:EmpireCMS_V7.5的一次审计 EmpireCMS_V7.5的一次审计 1概述 最近在做审计和WAF规则的编写,在CNVD和CNNVD等漏洞平台寻找 ...
- win10怎么查看激活到期时间如何看是否永久激活
win10怎么查看激活到期时间如何看是否永久激活 我们知道Windows系统需要激活后才可以使用全部功能,那么你的Windows10激活了吗?如何查看激活时间呢?是不是永久激活的?带着这些问题 ...