
Spark之UDAF
一.简介
Spark的自定义udf和udaf是为了提供函数扩展,Spark本身提供了几十上百个算子,在数据分析的各个方面的常用计算方式都有提到,但计算场景千差万别,算子也不会面面俱到,如何在单机或集群上定义函数就是要重点关注的地方。特别是在集群模式中,函数需要使用spark注册才能在各个节点上使用,因此,udf和udaf就显得比较重要了。
二.设置日志级别
Logger.getLogger("org").setLevel(Level.WARN) // 设置日志级别为WARN
三.创建spark入口
val spark = SparkSession.builder().appName("UdfUdaf").master("local[2]").getOrCreate()

val sc = spark.sparkContext

val sqlContext = spark.sqlContext
四.创建测试数据
val userData = Array(

  "2015,11,www.baidu.com", "2016,14,www.google.com",

  "2017,13,www.apache.com", "2015,21,www.spark.com",

  "2016,32,www.hadoop.com", "2017,18,www.solr.com",

  "2017,14,www.hive.com"

)

val userDataRDD = sc.parallelize(userData) // 转化为RDD

val userDataType = userDataRDD.map(line => {

   val Array(age, id, url) = line.split(",")

   Row(age, id.toInt, url)

})

val structTypes = StructType(Array(

   StructField("age", StringType, true),

   StructField("id", IntegerType, true),

   StructField("url", StringType, true)

))

// RDD转化为DataFrame

val userDataFrame = sqlContext.createDataFrame(userDataType,structTypes)
// 注冊临时表
userDataFrame.createOrReplaceTempView("udf")
五.自定义udf并测试
def isAdult(age : Int) ={

  if(age > 18){

    true

  }else{

    false

  }

}
// 注册udf(方式一)

spark.udf.register("isAdult_1", (id : Int) => if(id > 18) true else false) // 匿名函数

// 注册udf(方式二)

spark.udf.register("isAdult_2", isAdult _) // 预先定义好的普通函数

// 验证udf方式一

val result_1 = sqlContext.sql("select * from udf where isAdult_1(udf.id)")

result_1.show(false)

// 验证udf方式二

val result_2 = sqlContext.sql("select * from udf where isAdult_2(udf.id)")

result_2.show(false)
六.执行结果
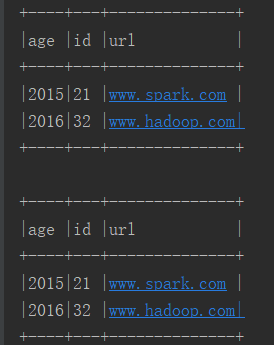
七.自定义udaf并测试
object AverageUserDefinedAggregateFunction extends UserDefinedAggregateFunction{

  //聚合函数输入数据结构

  override def inputSchema:StructType = StructType(StructField("input", LongType) :: Nil)

  //缓存区数据结构

  override def bufferSchema: StructType = StructType(StructField("sum", LongType) :: StructField("count", LongType) :: Nil)

  //结果数据结构

  override def dataType : DataType = DoubleType

  // 是否具有唯一性

  override def deterministic : Boolean = true

  //初始化

  override def initialize(buffer : MutableAggregationBuffer) : Unit = {

    buffer(0) = 0L

    buffer(1) = 0L

  }

  //数据处理 : 必写,其它方法可选,使用默认

  override def update(buffer: MutableAggregationBuffer, input: Row): Unit = {

    if(input.isNullAt(0)) return

    buffer(0) = buffer.getLong(0) + input.getLong(0) //求和

    buffer(1) = buffer.getLong(1) + 1 //计数

  }

  //合并

  override def merge(bufferLeft: MutableAggregationBuffer, bufferRight: Row): Unit ={

    bufferLeft(0) = bufferLeft.getLong(0) + bufferRight.getLong(0)

    bufferLeft(1) = bufferLeft.getLong(1) + bufferRight.getLong(1)

  }

  //计算结果

  override def evaluate(buffer: Row): Any  = buffer.getLong(0).toDouble / buffer.getLong(1)

}
    /**

      * 测试udaf

      */

    spark.udf.register("average", AverageUserDefinedAggregateFunction)

    spark.sql("select count(*) count,average(age) avg_age from udf").show(false)
八.执行结果

Spark之UDAF的更多相关文章
- Spark SQL UDAF示例
UDAF:用户自定义聚合函数 Scala 2.10.7,spark 2.0.0 package UDF_UDAF import java.util import org.apache.spark.Sp ...
- Spark笔记之使用UDAF(User Defined Aggregate Function)
一.UDAF简介 先解释一下什么是UDAF(User Defined Aggregate Function),即用户定义的聚合函数,聚合函数和普通函数的区别是什么呢,普通函数是接受一行输入产生一个输出 ...
- Kafka:ZK+Kafka+Spark Streaming集群环境搭建(十五)Spark编写UDF、UDAF、Agg函数
Spark Sql提供了丰富的内置函数让开发者来使用,但实际开发业务场景可能很复杂,内置函数不能够满足业务需求,因此spark sql提供了可扩展的内置函数. UDF:是普通函数,输入一个或多个参数, ...
- Spark Sql的UDF和UDAF函数
Spark Sql提供了丰富的内置函数供猿友们使用,辣为何还要用户自定义函数呢?实际的业务场景可能很复杂,内置函数hold不住,所以spark sql提供了可扩展的内置函数接口:哥们,你的业务太变态了 ...
- spark编写UDF和UDAF
UDF: 一.编写udf类,在其中定义udf函数 package spark._sql.UDF import org.apache.spark.sql.functions._ /** * AUTHOR ...
- spark自定义函数之——UDAF使用详解及代码示例
UDAF简介 UDAF(User Defined Aggregate Function)即用户定义的聚合函数,聚合函数和普通函数的区别是什么呢,普通函数是接受一行输入产生一个输出,聚合函数是接受一组( ...
- 【转】Spark-Sql版本升级对应的新特性汇总
Spark-Sql版本升级对应的新特性汇总 SparkSQL的前身是Shark.由于Shark自身的不完善,2014年6月1日Reynold Xin宣布:停止对Shark的开发.SparkSQL抛弃原 ...
- 转:Spark User Defined Aggregate Function (UDAF) using Java
Sometimes the aggregate functions provided by Spark are not adequate, so Spark has a provision of ac ...
- Spark SQL 用户自定义函数UDF、用户自定义聚合函数UDAF 教程(Java踩坑教学版)
在Spark中,也支持Hive中的自定义函数.自定义函数大致可以分为三种: UDF(User-Defined-Function),即最基本的自定义函数,类似to_char,to_date等 UDAF( ...
随机推荐
- sql server 性能调优之 资源等待之网络I/O
一.概述 与网络I/O相关的等待的主要是ASYNC_NETWORK_IO,是指当sql server返回数据结果集给客户端的时候,会先将结果集填充到输出缓存里(ouput cache),同时网络层会开 ...
- 你不可错过的Java学习资源清单(包含社区、大牛、专栏、书籍等)
学习Java和其他技术的资源其实非常多,但是我们需要取其精华去其糟粕,选择那些最好的,最适合我们的,同时也要由浅入深,先易后难.基于这样的一个标准,我在这里为大家提供一份Java的学习资源清单. 一: ...
- 不一样的ssm
这里的ssm不是指的spring+springmvc+mybatis,而是指的spring+springmvc+mongodb,下面我将搭建一个简单的“ssm”框架. 1.新建一个maven项目,骨架 ...
- dubbo自定义异常传递信息丢失问题解决
访问我的博客 目前计划对已有的单体项目进行组织架构拆分,调研了分布式系统中常用中间件 Dubbo 和 Spring Cloud,选择了 Dubbo,可以对当前现有项目进行平滑升级改造.但是一开始就遇到 ...
- Java线程池ThreadPoolExecutor使用和分析(二) - execute()原理
相关文章目录: Java线程池ThreadPoolExecutor使用和分析(一) Java线程池ThreadPoolExecutor使用和分析(二) - execute()原理 Java线程池Thr ...
- go跨平台编译
go语言支持直接编译不同系统的可执行程序,例如可以直接在mac上可以直接编译linux的执行程序 支持的环境变量 GOOS:目标可执行程序运行操作系统,支持 darwin,freebsd,linux, ...
- Qt5 在添加 Q_OBJECT 后发现编译出错的原因
在 Qt 编写过程中,如多线程使用信号槽时,需要添加 Q_OBJECT,但是在添加之后发现编译老会出错.如下: class ThreadSxxx : public QThread { Q_OBJECT ...
- mybatis是如何防止SQL注入的
mybatis是如何防止SQL注入的 1.首先看一下下面两个sql语句的区别: <select id="selectByNameAndPassword" parameterT ...
- OpenCV神技——人脸检测,猫脸检测
简介 OpenCV是一个基于BSD许可(开源)发行的跨平台计算机视觉库,可以运行在Linux.Windows.Android和Mac OS操作系统上.它轻量级而且高效--由一系列 C 函数和少量 ...
- This relative module was not found (转载)
vue踩坑-This relative module was not found 在使用vue.js的日期选择插件 的时候,报错如下 This relative module was not fo ...